引言
如果你正在阅读这篇文章,大概率已经掌握了基础Python知识,对数据科学抱有兴趣,可能写过循环语句,甚至用过Pandas这类库。但你大概率也遇到了一个普遍难题:数据科学领域过于庞杂,不知道从哪里起步,更不清楚哪些内容可以暂时不学,这种迷茫往往让人倍感疲惫。
这篇指南就是为你量身打造的,它帮你过滤掉繁杂的无效信息,提供一条清晰、结构化的学习路径。数据科学的核心目标,本质上是从数据中提取知识与洞察,进而推动实际行动与决策。读完这篇文章,你将学会把原始数据转化为可落地的业务情报。
我们会解答最核心的问题:“数据科学入门,我该先学什么?”,同时梳理出可以安全延后学习的内容,帮你节省数百小时的迷茫时间。读完本文,你会拿到一份2026年实用、聚焦、适配求职需求的学习路线图。
理解数据科学的核心学习原则
在学习具体工具之前,必须先掌握贯穿数据科学领域的核心原则——帕累托法则(80/20法则)。这条法则指出,80%的结果来自20%的原因。
放到数据科学学习中,意味着20%的核心概念和工具,就能解决实际工作中80%的任务。很多新手会陷入一个误区:试图学完所有算法、所有库、所有数学推导证明,最终导致学习倦怠、半途而废。
真正优秀的数据科学家,会优先聚焦高价值的核心技能。行业内公认的高效学习公式很简单:完成2个可部署的实战项目,每周发布3篇领英文章、投递50份简历,最终每月能拿到3-5个面试机会。这就是80/20法则的实际应用,把精力集中在能带来大部分成果的少数关键行动上。
核心学习逻辑是:按照职场实际使用顺序学习技能,每掌握一项技能就完成一个小型可验证的实战项目。这种学习方式,能把单纯考证的学习者和真正能入职的从业者区分开来。
四大数据分析类型(数据科学四大支柱)
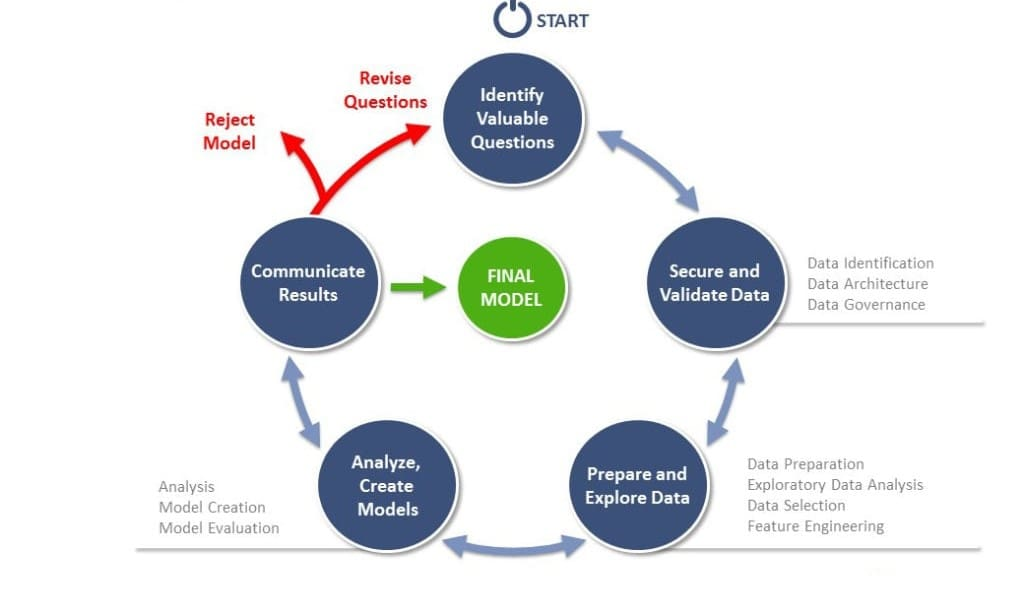
想要打好数据科学基础,必须先明确学习范围。人们常说的“数据科学四大类型”“数据分析四大支柱”,本质上是数据分析的四个成熟度阶段,代表着从数据中挖掘价值的递进层次。
理解这四大支柱,能帮你建立解决所有数据问题的基础框架。
第一支柱:描述性分析
解决“发生了什么”的问题,核心是汇总历史数据、梳理趋势。比如计算月均销售额、上一季度客户转化率,都属于描述性分析,它能帮你快速掌握数据的整体概况。
第二支柱:诊断性分析
解决“为什么会发生”的问题,需要深入挖掘问题根源。比如客户流失率上升,诊断性分析会帮你拆解问题,判断流失集中在特定地区、产品类型还是客户群体,找到背后诱因。
第三支柱:预测性分析
解决“可能会发生什么”的问题,也是机器学习的核心应用场景。通过挖掘历史数据中的规律,构建模型预测未来事件。比如计算特定客户未来几个月内流失的概率,就是典型的预测性分析任务。
第四支柱:指导性分析
解决“我们该做什么”的问题,属于最进阶的分析阶段。通过模拟运算和优化算法,给出具体的行动建议。比如分析后告诉你,哪类促销活动最能挽留高流失风险客户,就是指导性分析的成果。
学习过程要循序渐进,从描述性分析入手,逐步过渡到预测性、指导性分析任务。
优先掌握的核心技能(入门必学)
接下来进入核心内容:数据科学入门,第一阶段该学什么?结合2026年行业求职路线,前两个月要集中打造“生存必备技能”,这是入行的基础。
1. 编程与数据处理
首先夯实Python基础:如果你已经有基础Python知识,要重点深化函数、模块和虚拟环境的学习。Python凭借丰富的库生态和可扩展性,仍是2026年数据科学领域的主流语言。
必须精通Pandas数据处理:这是不可跳过的核心技能,要熟练掌握数据读取(read_csv)、缺失值处理、数据集拼接、分组聚合(groupby)和数据透视表(pivot_table)等操作。
掌握NumPy基础:学习数组和向量化运算,因为绝大多数数据科学库都基于NumPy构建,是后续学习的底层基础。
2. 数据探索与可视化
掌握探索性数据分析(EDA):通过分析数据集,汇总核心特征,多采用可视化方式完成。要学会检查数据分布、特征相关性、基础特征交互关系,这是数据建模前的关键步骤。
学习可视化工具:从Matplotlib入门,再掌握Plotly,优先制作简洁清晰的图表。核心原则是:每张图表都要有明确标题,直接点明分析结论。
3. SQL与数据规范
精通SQL:即便到2026年,SQL依然是数据领域的通用语言。必须掌握查询(SELECT)、条件筛选(WHERE)、多表连接(JOIN)、分组聚合(GROUP BY)和窗口函数,这是职场日常工作高频使用技能。
学习Git与数据规范:掌握Git版本控制,代码仓库要整洁,配套清晰的README.md文档,写明代码运行方法,养成规范的工程化习惯。
4. 统计学基础
很多新手会焦虑数学门槛,其实数据科学不需要博士级别的数学知识,只需牢牢掌握三大核心板块即可。
描述性统计:掌握均值、中位数、标准差、相关系数,帮你快速把握数据整体特征;
概率基础:理解事件发生可能性,量化不确定性,为预测分析打基础;
数据分布:掌握正态分布等常见分布规律,帮你选择合适的统计分析方法。
统计学思维至关重要,因为数据不会“自己说话”,需要具备统计思维的分析师解读随机性和数据波动性,得出可靠结论。
Python和R,数据科学该选哪个?
这是新手最常问的问题,简单来说:两者都很优秀,但适用场景不同。
Python:是生产部署和规模化应用的首选语言,能无缝对接Spark等大数据技术,也是TensorFlow等深度学习框架的主力语言。如果想把模型部署到实际应用中,或从事大规模系统相关工作,Python是最优选择。
R:传统统计分析专用语言,在高级统计分析和可视化(ggplot2库)方面实力强劲,目前仍广泛应用于学术和特定研究领域。
2026年零基础入门,优先推荐Python。R适合小规模分析,在实际职场大规模应用中性能存在短板;加上你已有基础Python知识,深耕Python是最高效的学习选择。
6个月行动规划:打造求职竞争力
结合2026数据科学入门指南,这份按月拆解的学习计划,源自行业成功求职路线,帮你稳步实现求职目标。
第1-2个月:夯实基础
核心目标:独立处理真实数据
核心技能:深化Python(Pandas、NumPy)、精通SQL连接与聚合、掌握Git、搭建描述性统计基础
实战项目:城市出行数据分析。抓取一个月的公共交通数据,完成数据清洗、汇总,解答业务问题(如“哪三个站点早高峰延误最严重”),代码上传至GitHub。
第3-4个月:机器学习基础
核心目标:构建并评估预测模型
核心技能:掌握监督学习算法(逻辑回归、随机森林)、训练集/测试集划分、交叉验证、核心评估指标(准确率、精确率、召回率、ROC-AUC)。切记:特征工程占这项工作的70%,是建模核心。
实战项目:客户流失预测模型。目标AUC值达到85%以上,配套简易模型说明文档,写明模型用途和局限性。
第5个月:模型部署
核心目标:让模型可被他人使用
核心技能:使用Streamlit或Gradio搭建简易模型网页界面,掌握pickle/joblib模型保存与加载方法
实战项目:简历-岗位匹配工具。用户上传简历,工具自动完成与岗位描述的匹配打分,实现简易实用的部署效果。
第6个月:打造求职作品集
核心目标:向雇主证明自身价值
核心行动:完成3个打磨完善的GitHub项目,配套清晰README;优化简历,用数据量化成果(如“构建流失模型,精准识别85%高风险用户”);在领英分享项目,拓展职场人脉;重点投递初创公司,这类企业更需要全能型数据人才。
学习避坑:这些内容直接跳过(新手阶段)
想要高效学习,不仅要知道学什么,更要知道暂时不学什么,这部分内容能帮你避开困住无数新手的无效学习弯路。
1. 暂时搁置深度学习
除非你专门瞄准计算机视觉、自然语言处理岗位,否则新手阶段完全可以跳过深度学习。Transformer、神经网络、反向传播等内容很前沿,但80%的入门级数据科学岗位并不要求,先精通Scikit-learn才是关键。
2. 跳过复杂数学推导证明
理解梯度等概念的原理即可,不需要从零推导数学公式。现代数据科学库已经封装了所有数学运算,重点关注工具应用,而非数学推导过程。
3. 避免频繁切换框架
不要试图同时学习十几个框架,先精通核心的Scikit-learn。掌握模型拟合、预测的核心逻辑后,再学习XGBoost等其他库会非常轻松,盲目跟风学框架只会浪费时间。
4. 新手阶段暂缓Kaggle竞赛
Kaggle竞赛看似诱人,但很多新手花费数周时间,通过集成数十个模型追求榜单前0.01%的准确率,这和实际职场工作完全不符。对雇主来说,一个整洁、可部署、解决实际问题的项目,远比竞赛高排名更有价值。
5. 不必精通所有云平台
不需要同时精通AWS、Azure、GCP三大云平台,入职后可根据岗位需求再学习。优先打磨核心数据科学技能,云平台操作属于锦上添花的内容。
结语
2026年开启数据科学学习,不必陷入焦虑和迷茫。运用80/20法则,聚焦高价值核心技能:Python、SQL、统计学基础、项目实战与清晰表达。把四大数据分析支柱作为工作框架,跟着6个月学习路线稳步推进。
记住,数据科学的核心目标是把数据转化为实际行动。遵循这份入门指南,你不只是积累知识,更是在培养输出决策洞察的能力。今晚就开始你的第一个项目:下载一份数据集,完成简易分析,上传至GitHub。千里之行,始于足下,数据科学的漫长征程,从一行代码开始。
参考文献
NIIT. (2025). Data Science Career Roadmap: From Beginner to Expert.
OpenDSA. (n.d.). Self-Organising Lists.
Institut für angewandte Arbeitswissenschaft. (2024). Data Science.
Raschka, S. (2026). Is R used extensively today in data science?
NIELIT. (2025). Big Data & Data Science.
EdgeVerve. (2017). Analytics: From Delphi's prophecies to scientific data-based forecasting.
KNIME. (2024). How much statistics is enough to do data science?
Penn Engineering Blog. (2022). Data Science: Refining Data into Knowledge, Turning Knowledge into Action.
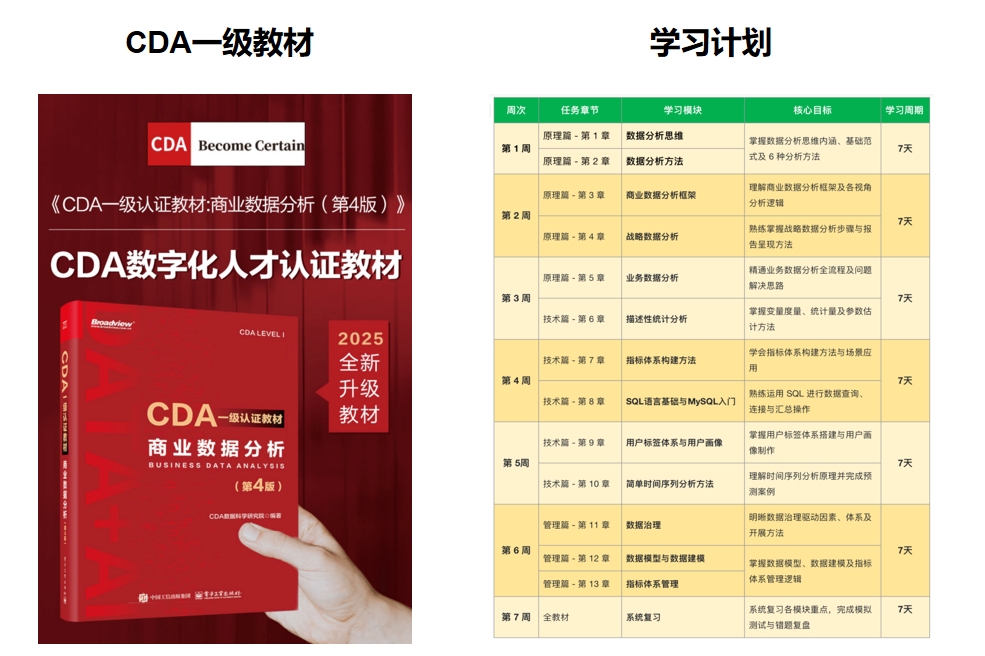
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





