
经管之家App
让优质教育人人可得
立即打开



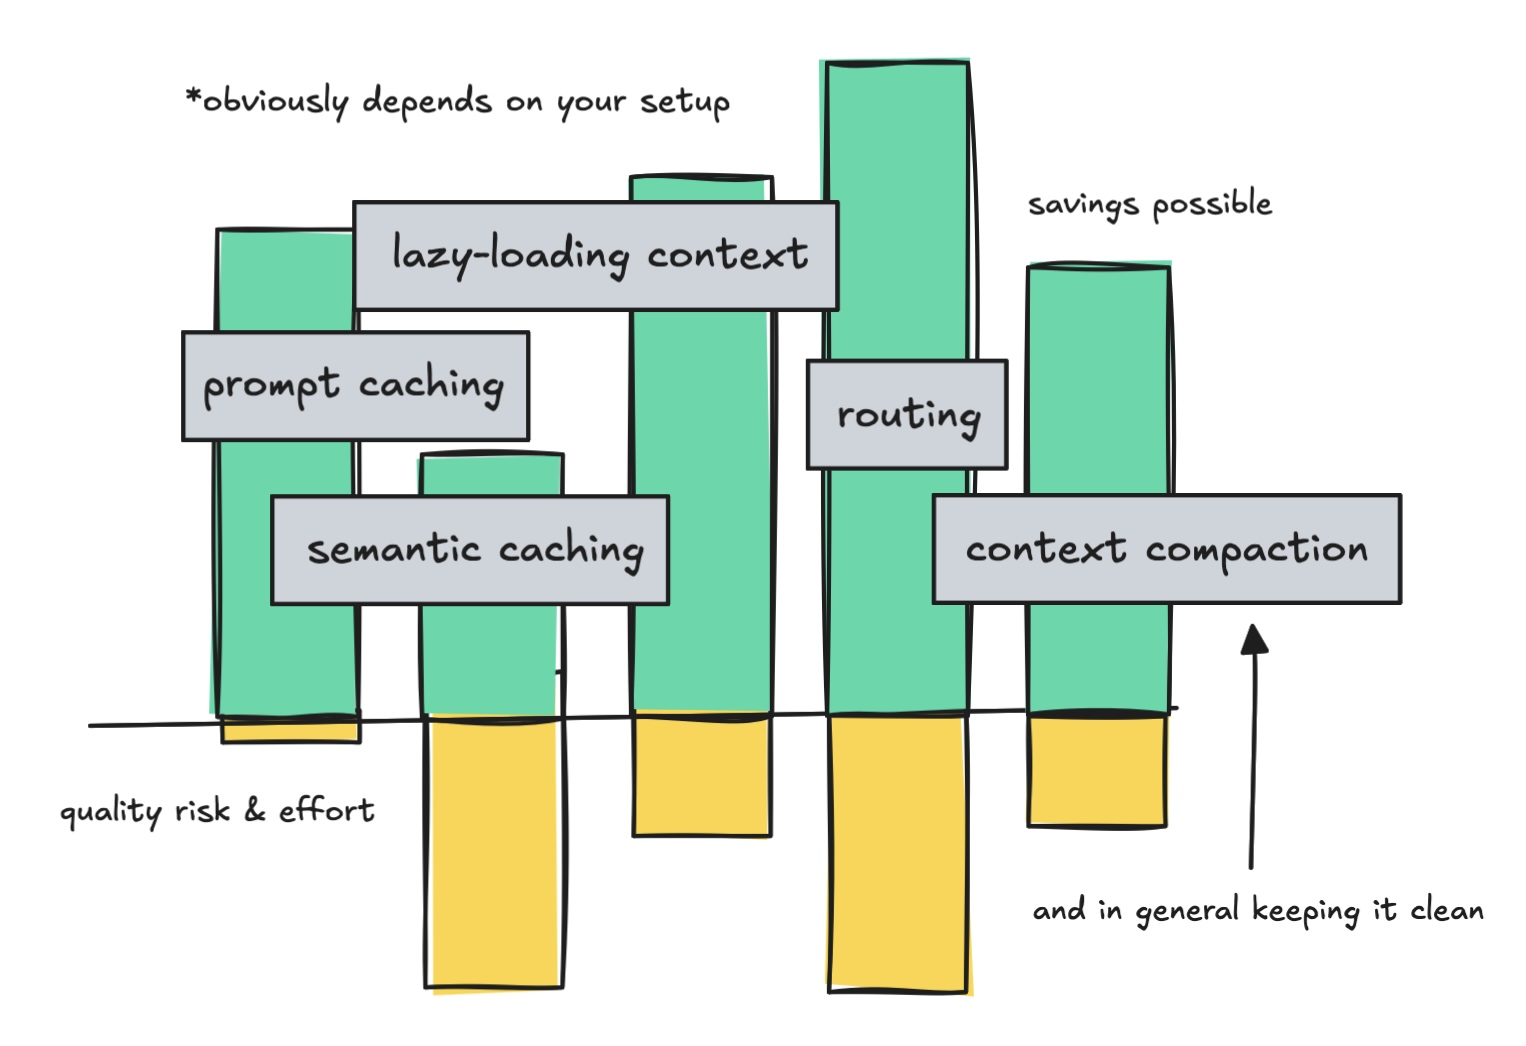
你的第一个智能体(Agent)可能仅包含500个令牌的系统提示和两个工具,但这些数字通常会迅速膨胀。
举个例子,泄露的Claude系统提示约有24,000个令牌,而OpenClaw用户报告称,在第一轮交互中,向Gemini 3.1 Pro发送的输入令牌超过150,000个,却仅得到29个令牌的输出。
这样一个未优化的智能体,若每天运行100条消息,每条消息包含166,000个输入令牌,在Gemini 3.1 Pro上每月成本约为996美元,在Claude Opus 4.6上则约为2,490美元。
不过,有一些技巧可以将这些成本降低,接近每月50美元和100美元。
因此,我想梳理一下构建智能体时需要考虑的一些设计原则。
我们将探讨提示缓存的工作原理及其快速优势、语义缓存、工具和MCP(可能指模型控制协议)的懒加载、路由和级联、委托给子智能体,以及如何保持上下文整洁等内容。
文章中还包含了交互式图表——帮助你根据当前使用的令牌数量,直观了解每种原则能带来的成本节省。
当然,我会保持客观:每一项节省都伴随着相应的权衡。
本文将分为四个部分,每个部分都配有一个交互式计算器。
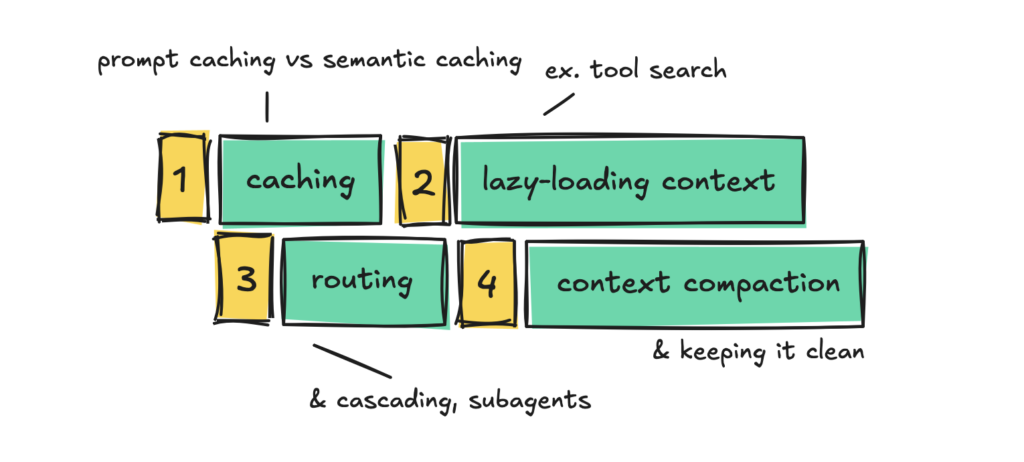
首先,我们将探讨如何在可能的情况下重用令牌,包括提示缓存和语义缓存。然后,我们将看看如何最小化那些稳定且始终会添加的令牌,比如内存和工具定义。
我们还将讨论如何将请求路由到较小的模型,或升级到较大的模型,以及由此带来的质量风险和成本节省。
最后一部分将讨论如何为了性能和经济原因保持上下文整洁,同时简要提及压缩技术。
大型语言模型(LLM)的成本不仅来自过于频繁地调用模型,还来自反复为处理相同的令牌付费。
因此,在本节中,我们将介绍KV缓存(键值缓存)——提示缓存背后的底层机制,以及语义缓存,这是两种截然不同的技术。我们将详细说明它们是什么、能做什么,以及能节省多少成本。
对于较长的系统提示,提示缓存是一个快速见效的方法,而语义缓存则需要更多工作,且伴随更多风险。
模型生成内容之前,必须先处理提示。这一过程需要消耗计算资源,意味着会产生延迟和成本。因此,为了提高效率,我们不应反复处理相同的内容。
当你使用大型语言模型时,提示首先会被分词,然后这些令牌会转换为向量,之后在每个注意力层中,这些向量会被投影到KV张量中。
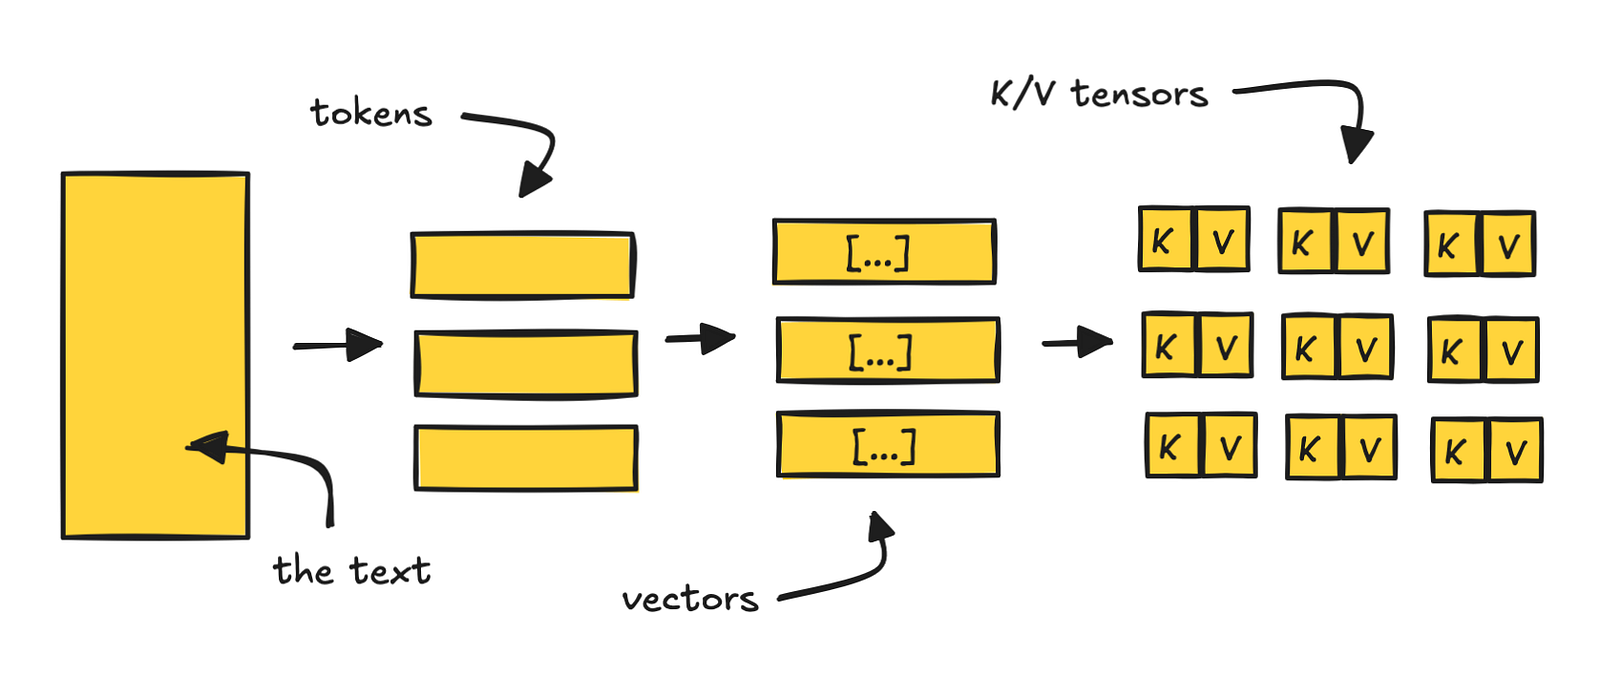
据我了解,推理引擎会在生成过程中缓存KV张量,否则运算速度将无法达到合理水平。
但我们不必在响应结束后就丢弃缓存,而是可以将其存储起来。
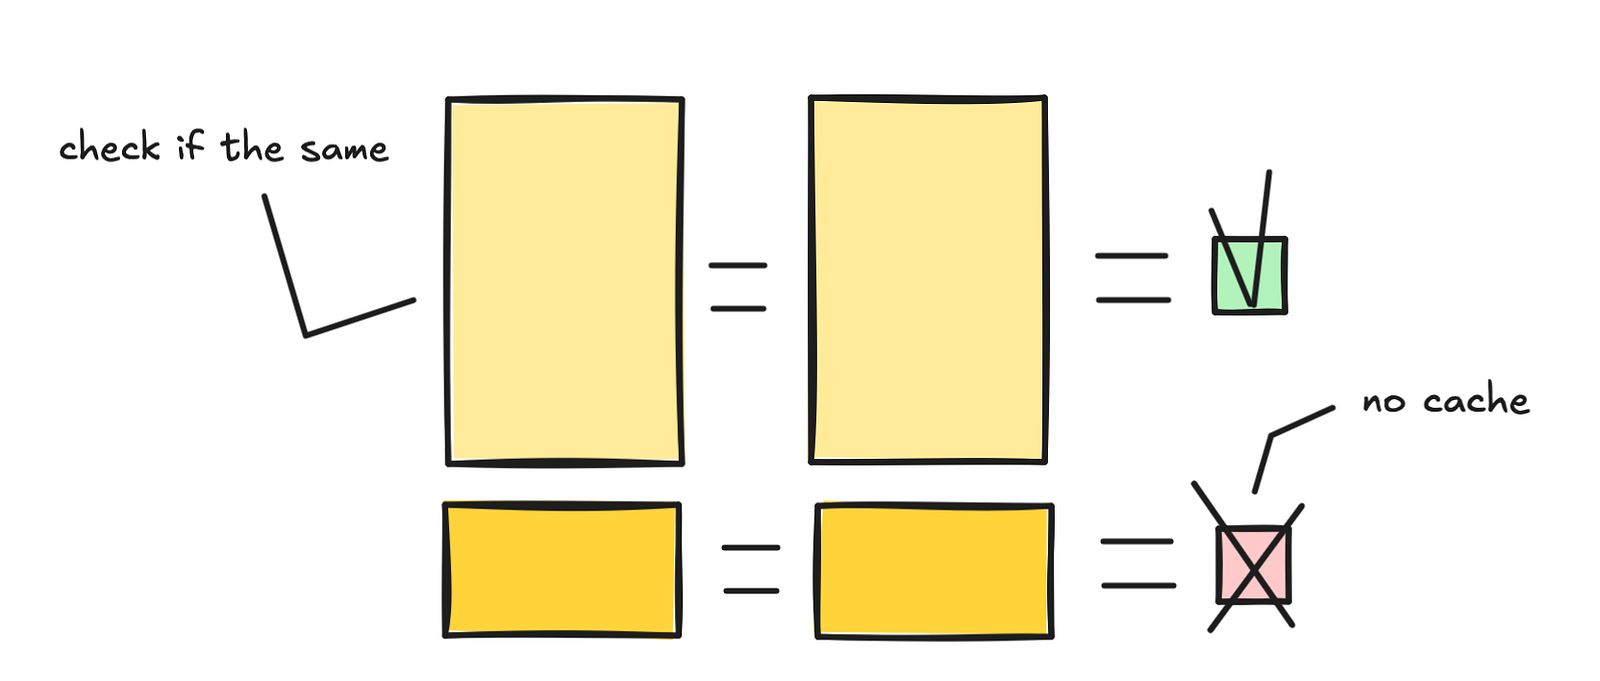
下次有请求进来时,我们会检查提示中相同的部分是否已有对应的张量。如果有,就加载这些张量,跳过重新处理的步骤。
从经济角度来看,这一点的重要性不言而喻:假设处理2,000个令牌需要1秒,而你的系统提示有10,000个令牌。
那么,每次调用LLM都能节省5秒时间,只需避免反复通过模型重新处理提示的开头部分(不过预填充吞吐量会因设置不同而有很大差异)。
需要注意的是,我们必须让输入与存储的KV缓存完全匹配。
如果令牌发生变化,我们就不再有该提示确切部分的预计算KV张量,因此必须重新处理。这是很多人容易出错的地方:多添加一个空格、工具定义顺序调整、时间戳位置错误,都会导致缓存失效。
因此,存储缓存不仅能加快请求速度,进而降低请求成本,还具有实际价值。
需要注意的是,存储这些张量并非免费。缓存的KV会占用服务端的内存,这就是为什么许多提供商将生存时间(TTL)窗口设置在5-10分钟左右。
不过,我们无需自己构建这一功能,以上只是为了让大家理解其工作机制。已有一些框架可以提供帮助,而且API提供商也有自己的提示缓存规则,我们将分别介绍这两者。
如果你托管的是开源模型,理想情况下应使用LLM服务框架,比如vLLM。虽然还有其他框架可以提供缓存层,但vLLM有一个附加功能值得我们探讨。
vLLM中的缓存层通过将提示分割成块,根据每个块的令牌(以及其前面的令牌)进行哈希处理,并将KV张量存储在这些哈希值对应的位置。
与大多数设置一样,需要缓存的静态部分应放在提示的开头。
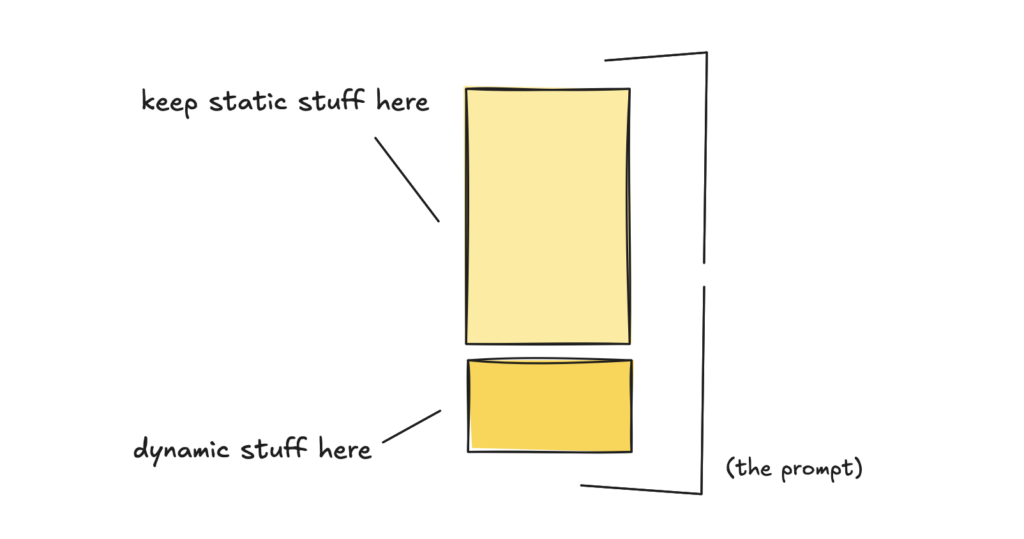
要在vLLM中启用缓存,请使用标志 --enable-prefix-caching
要调整块大小,可以使用标志 --block-size
块大小指的是每个块包含的令牌数。如果块大小为16,那么每16个令牌就会分割一次,开始一个新的块。
你也可以使用标志 --kv-cache-memory-bytes 来明确设置每个GPU的KV缓存大小。
分配的内存越多,缓存块能保留的时间就越长。但如果同时有大量不同的长请求,内存会更快被占满,因此旧的块会被更快地移除。
市面上还有其他解决方案,但核心机制与我们上一节讨论的一致。
你也可以了解一下SGLang、RadixAttention的前缀缓存功能,以及可以接入服务引擎的LMCache。
不过,大多数人使用的是API提供商,他们有自己的提示缓存政策,下面我们来详细说明。
使用API提供商时,你需要确保提示的结构能命中缓存。要做到这一点,有一些注意事项需要遵守。
这里我们先以OpenAI为例。
对于OpenAI,他们有明确的要求:要缓存提示的一部分,需要完全匹配前缀。也就是说,提示开头必须是相同的静态输入。
这意味着你应始终将稳定的指令、示例和工具放在前面,变量内容放在后面。
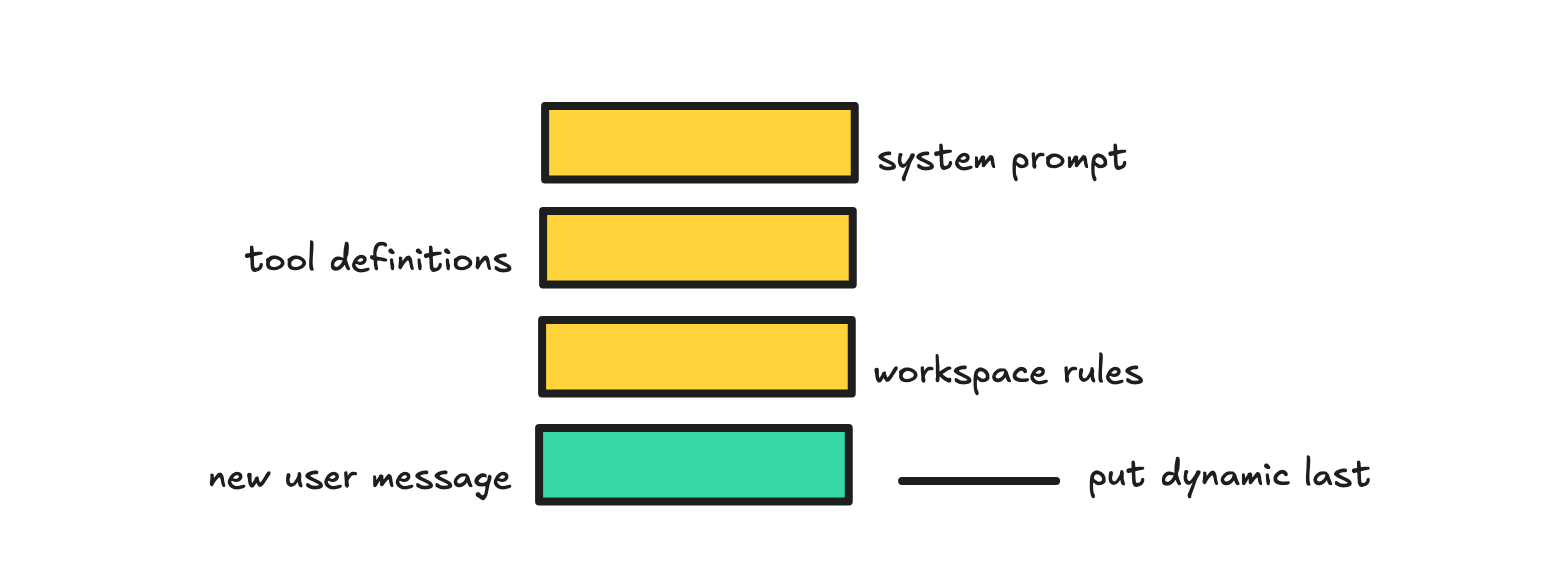
你也可以传入prompt-cache-key(提示缓存键),这有助于将相似的请求路由到一起,提高缓存命中率。
还有一些更具体的细节。对于长度为1,024个令牌或更长的提示,缓存会自动启用,但他们会使用前256个令牌将请求路由回相同的缓存。因此,提示的静态部分需要超过256个令牌。
对于Anthropic,你需要通过cache-control(缓存控制)参数启用缓存。
值得一提的是,通常情况下,缓存的回收(TTL)会在闲置5-10分钟后发生,但可以延长。Anthropic的情况也是如此,但你可以将其延长至1小时(不过成本会增加一倍)。
早些时候我提到了节省的时间,如果你是自托管,这也能节省成本。对于API提供商,节省的成本体现在缓存输入令牌的价格降低上。
OpenAI的缓存输入令牌最高可享受90%的基础输入价格折扣。
Anthropic对缓存输入也提供相同的折扣,但你还需要为存储缓存付费。因此,如果使用不当,Anthropic的成本会更高。
不过,总的来说,如果你的提示中有90%是静态的,正确使用缓存后,你可以参考以下可能的定价。
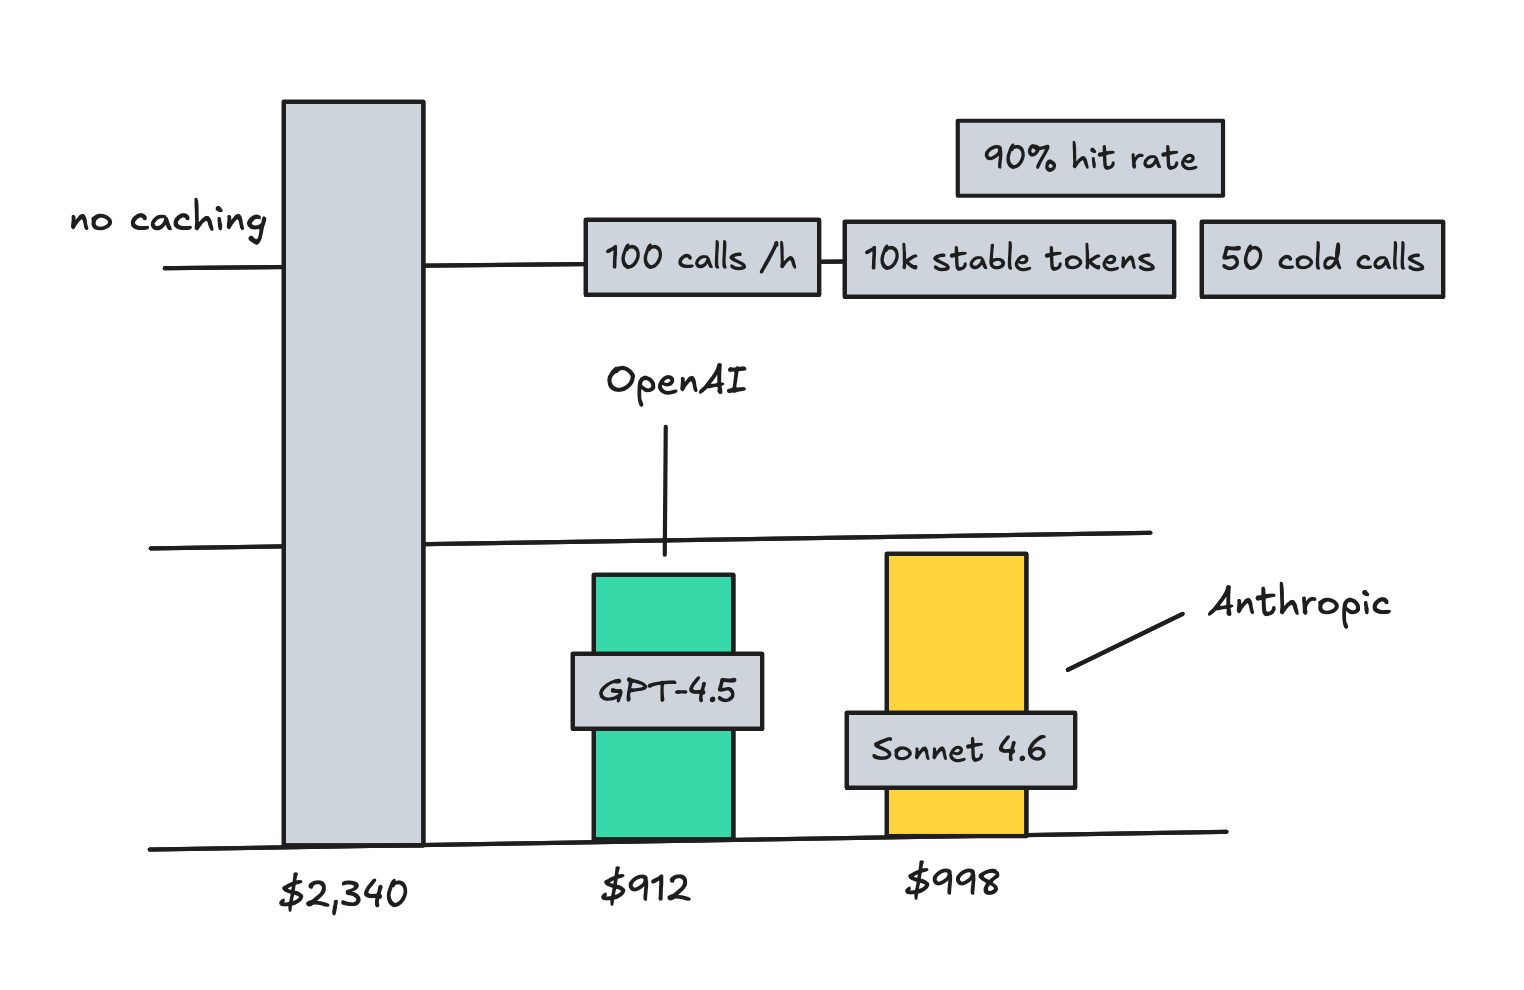
我为此创建了一个关于Claude的交互式图表,你可以自行操作查看。
因此,如果你使用的是较长且保持不变的系统提示,提示缓存是一个非常不错的选择,值得考虑用于节省令牌。
接下来我们谈谈语义缓存,这是一种完全不同的技术。
语义缓存基于含义进行匹配,也就是说,如果请求足够相似,就返回缓存的结果。虽然听起来很简单,但有一些明显的陷阱需要注意。
要对文本进行语义匹配,我们会使用嵌入(embeddings)。如果你对这个词不熟悉,可以先做一些研究。几年前我曾写过相关内容。
本质上,嵌入是一种向量,我们可以使用余弦相似度来比较它们。如果相似度高,说明含义相近,不过这也取决于所使用的模型。
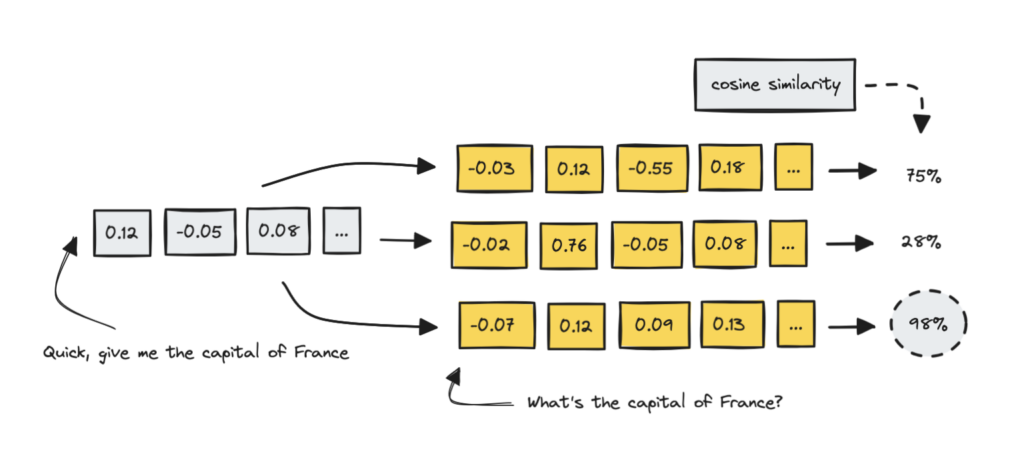
语义缓存的核心思路是将相似的请求匹配到已有的答案。例如,“法国的首都是什么?”和“快告诉我法国的首都是哪里”应该路由到同一个答案。
无需反复使用LLM来回答相同的问题。
如果很多人询问近乎相同的通用问题,而且数据不会很快过时,这种方法会非常有效。
那么为什么不将其应用于所有情况呢?这里有很多陷阱。
我先简单列举几个:你需要确定相似度的阈值、答案的有效时间、多轮对话问题的处理方式、实际存储的内容、是否需要实现路由器、如何区分用户,以及缓存错误答案时该怎么办。
你还需要考虑生存时间(TTL),即信息何时会过时,以及针对哪些问题设置过期时间。
因此,尽管其机制相当简单,但你仍然需要元数据过滤器和标签,例如用户、工作区、语料库版本、角色、会话/用户范围、智能TTL,以及判断“返回结果是否足够”的规则。
这就需要投入一定的工程开发工作。
因此,如果你想实现语义缓存,或许可以使用语义索引来查找之前的问题。不同的问题可以指向同一个存储的答案,这样可以减少存储量。根据使用频率设置智能TTL:如果某个答案被频繁重用,就保留更长时间,否则就删除。
我还建议你在日志中发现重复请求后再实施语义缓存,而不是一开始就盲目使用。因为你的使用场景可能并不适合这种方式。
至于实现方法,很多数据库都支持语义缓存。此外,还有一些库可以帮助处理相关流程,比如semanticcache、prompt-cache、GPTCache、vCache、Upstash semantic-cache、Redis + LangCache等。
显然,这种方法确实能带来成本节省。Redis声称可以减少高达68.8%的API调用,并将延迟降低40-50%,不过需要注意的是,这有点营销成分,因为他们使用的是典型的问答场景。
因此,这完全取决于你的设置。如果你有一个存在大量冗余调用的问答智能体,那么节省的成本会更多。如果你有一个处理独特请求的编程机器人,那么节省的成本会更少。
当变化的问题位于大型静态提示中时,提示缓存效果较好;当人们用不同的措辞反复询问相同问题时,语义缓存效果较好。
你可以通过这个交互式工具查看两种缓存方式的成本节省情况。
在进入下一节之前,我想指出,标准缓存也能带来不少节省。
记得缓存那些成本高昂且具有确定性的内容,比如SQL查询结果、工具输出和检索结果。永远不要重复运行这些操作。
我在自己的一个工具中就采用了这种方法。它收集关键词数据进行总结,然后将其缓存起来,直到数据过时。如果数据过时,当该路由被访问时,它会重新运行。
因此,语义缓存是一个有趣的想法,对于某些使用场景可以节省令牌,但需要工程开发才能很好地实现。
这一部分主要讨论当你的系统提示因工具庞大或内存增长而变大时,该如何处理。
对于小型智能体来说,这并不是什么问题,但如果你的智能体规格不断扩大,有一些方法可以精简它,并按需获取信息(至少可以尝试)。
一旦你的智能体提示超过某个规模,最好将始终加载的层保持得尽可能小且稳定,并将不断增长的细节单独存放。
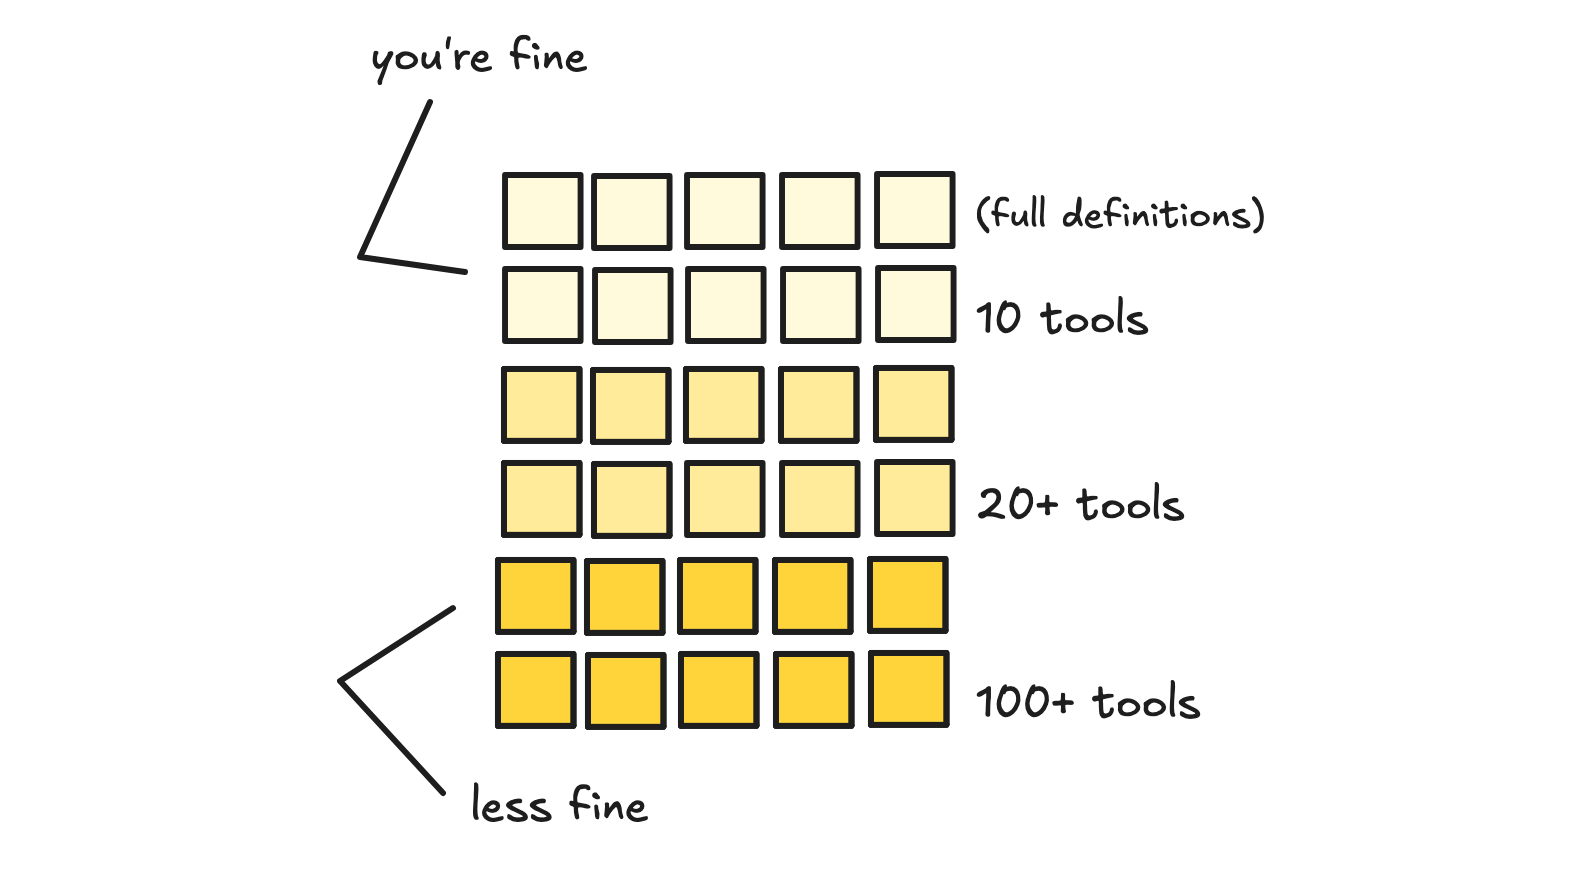
这一点很重要,因为当这些层开始增长时——比如当你加载数百个工具,或发送不断变化的完整MCP服务器描述时——上下文会变得混乱。
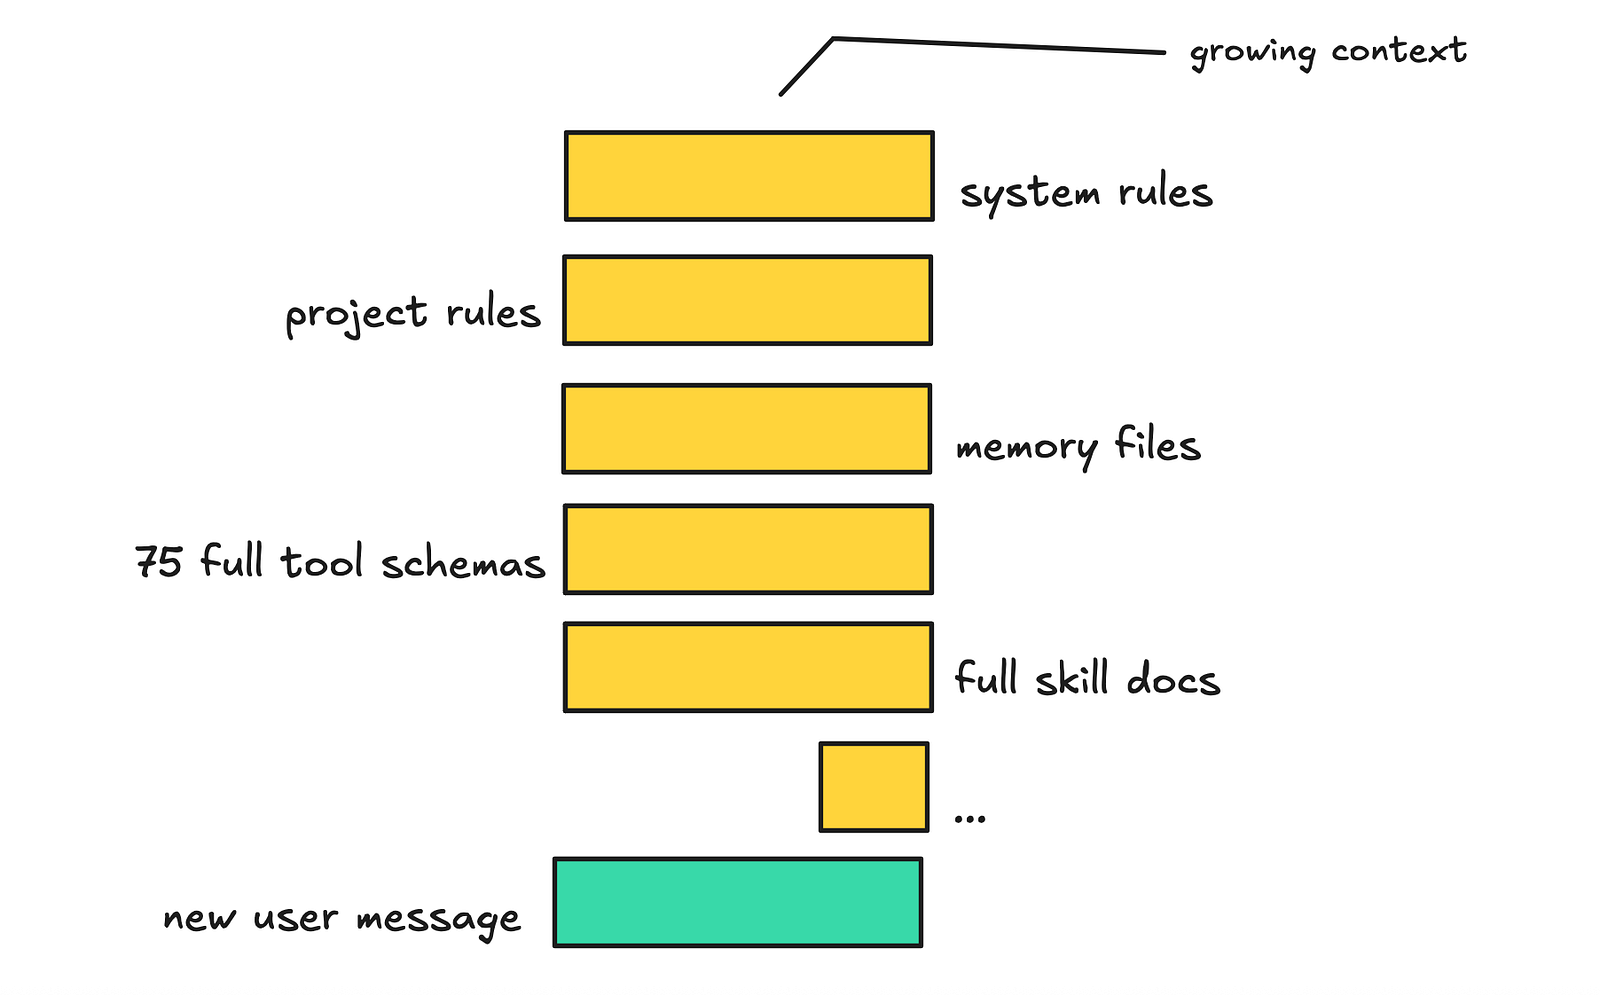
问题显然不仅在于成本,还在于性能。而且,如果其中一个层不断变化,提示缓存就很难命中。
因此,核心思路是将顶层保持紧凑和稳定。顶层应帮助模型了解自己所处的环境以及下一步该做什么,但不需要预先包含所有信息。
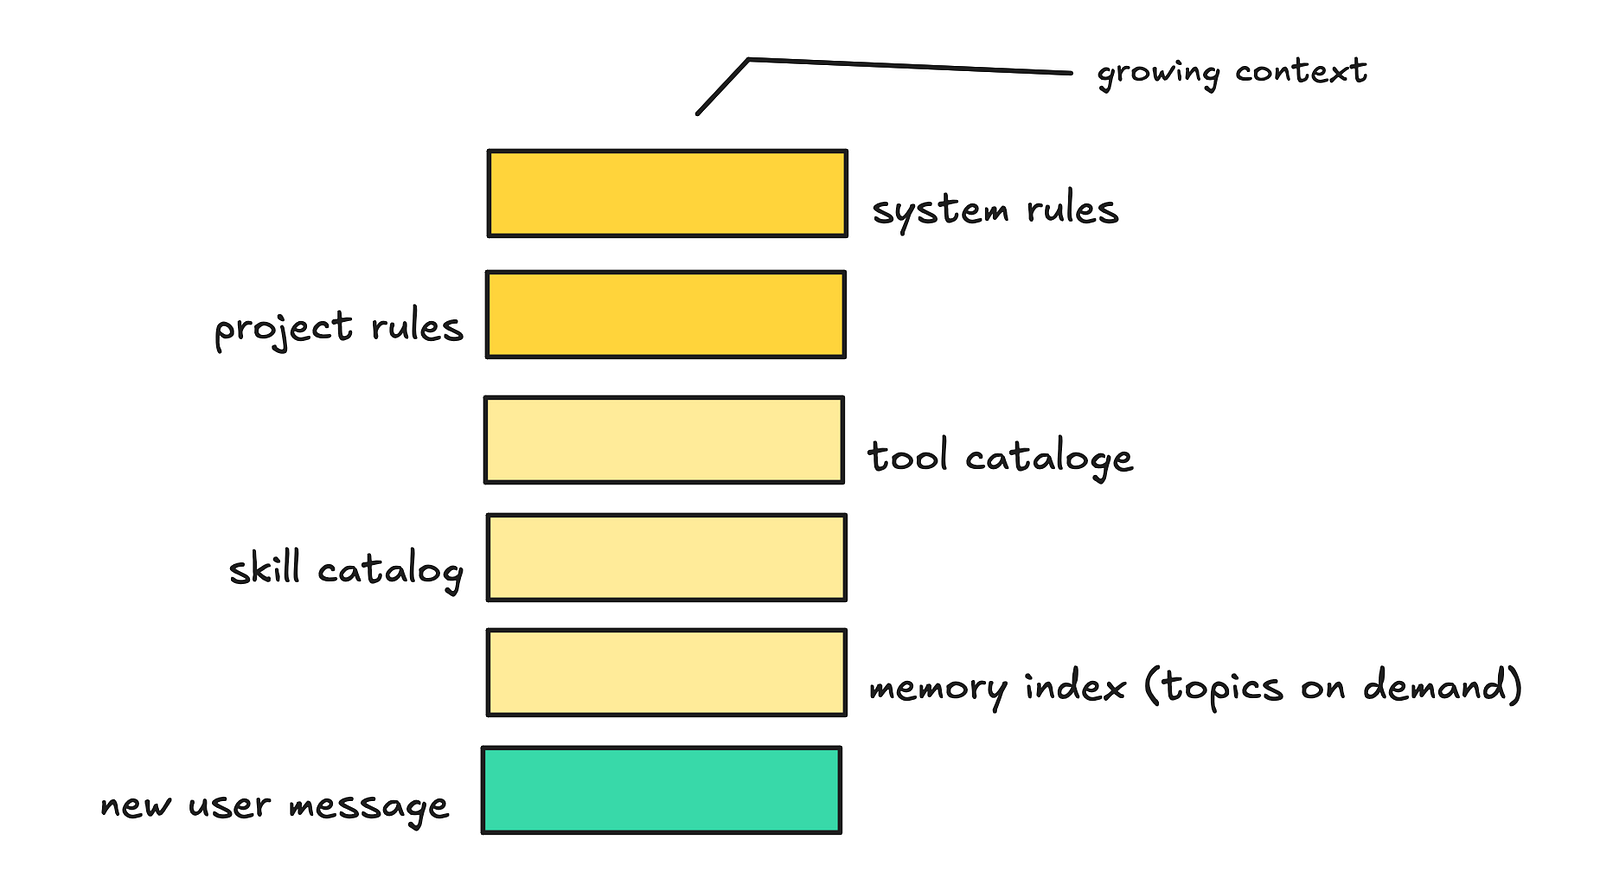
如果你查看过Claude Code的源代码,就会发现他们的内存系统就采用了类似的设计。
他们有一个始终加载的索引文件,长度不超过200行,详细的主题文件则存放在其他地方。不过,智能体实际的行为与系统预期的行为,就是另一个话题了。
这种思路在其他地方也能看到,比如Claude的高级工具设置、Claude Skills的分层设置,以及尝试懒加载MCP工具,而不是将所有服务器定义都预先写入提示中。
这个思路是合理的。当上下文不断增长时,LLM选择正确操作的难度会增加。但这个领域还处于早期阶段,因此我们将以一个工具为例,看看它如何发挥作用。
几个月前,Anthropic推出了一项名为“高级工具搜索”的功能。这一功能旨在解决如何在保持上下文精简的同时,让模型能够访问数百个工具的问题。
Anthropic表示,在优化之前,工具定义的令牌数在55,000到134,000之间,而且当上下文增长到这个规模时,工具选择错误是常见的失败模式。
因此,搜索工具通过让LLM使用它来查找工具,而不是预先定义所有工具,从而优化上下文。
tools=[
        {
            "type": "tool_search_tool_bm25_20251119",
            "name": "tool_search"
        },
        {
            "name": "search_contacts",
            "desc ription": "通过姓名或电子邮件查找联系人。",
            "input_schema": {
                "type": "ob ject",
                "properties": {
                    "query": {"type": "string"}
                },
                "required": ["query"]
            }
        },
        {
            "name": "send_email",
            "desc ription": "向一个或多个收件人发送电子邮件。",
            "input_schema": {
                "type": "ob ject",
                "properties": {
                    "to": {"type": "string"},
                    "subject": {"type": "string"},
                    "body": {"type": "string"}
                },
                "required": ["to", "subject", "body"]
            },
            "defer_loading": True
        }
    ]
上面的代码中,我们定义了一个名为tool_search的工具。你可以选择现成的选项(BM25或Regex),也可以构建自己的自定义工具。然后我们以一个工具为例,将其设置为延迟加载。
不过,只有当你有10个以上的工具时,才建议这样做。
Anthropic会负责搜索工作,因此你不会看到它如何将工具模式添加到系统提示中,也不会看到底层的搜索过程。
他们表示,一旦找到匹配的工具,其定义就会作为tool_reference(工具引用)块内联到对话中,供LLM使用。
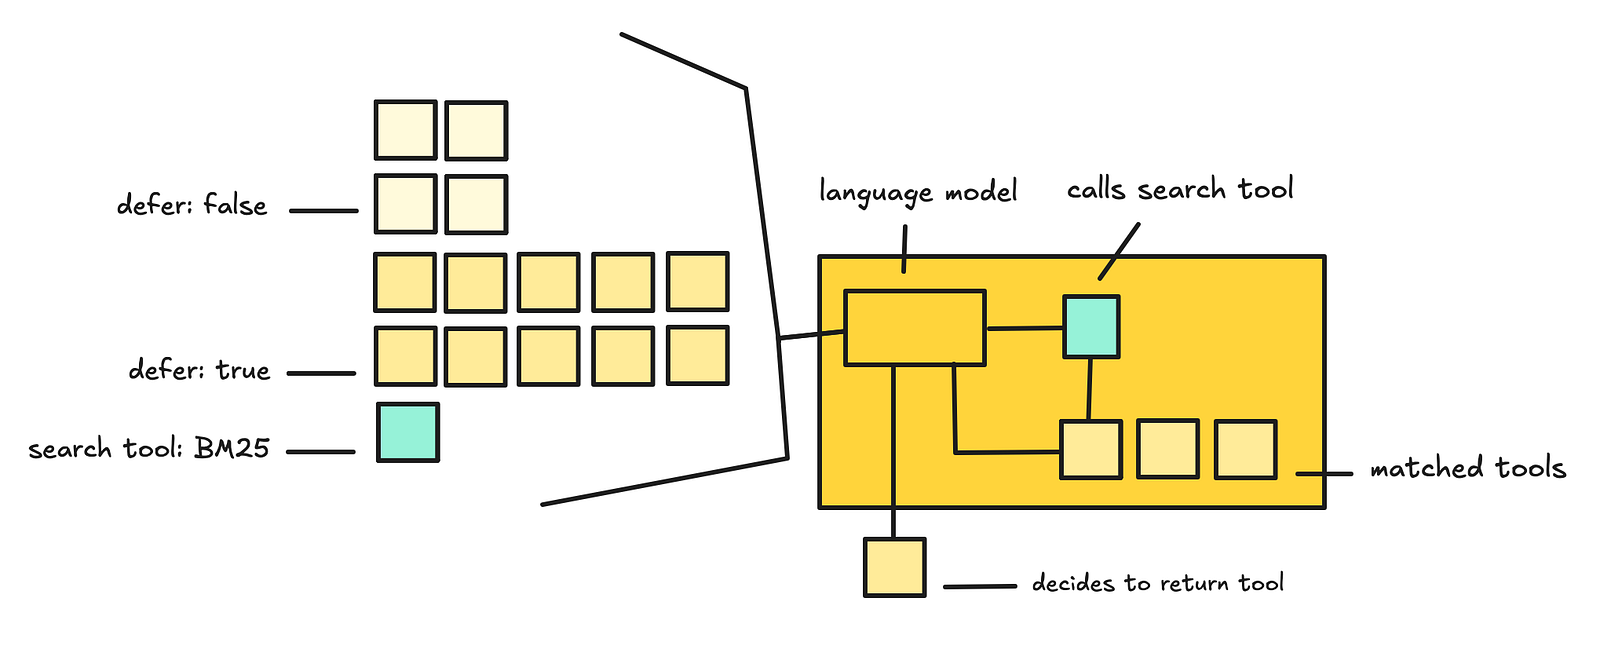
这个思路很巧妙:初始上下文更小,但会增加一个额外的搜索步骤。也有人测试过这个工具,结果有些不尽如人意,但那是在有4,000个工具的情况下,因此还有更多测试空间。
我们也需要合理定义工具,以便它们能够被搜索到。但当你无法看到中间步骤时,调试起来会更加困难。
这种思路在其他地方也有应用,但人们通常将其称为良好的AI工程实践:不要让智能体暴露在庞大而混乱的上下文中。相反,给它一种缩小范围的方法,只有在需要时才让它检查或加载工具。
这一部分也能带来显著的成本节省,不过具体取决于你最初发送的令牌数量。
我们创建了另一个计算器,用于比较工具搜索和提示缓存的成本节省情况。
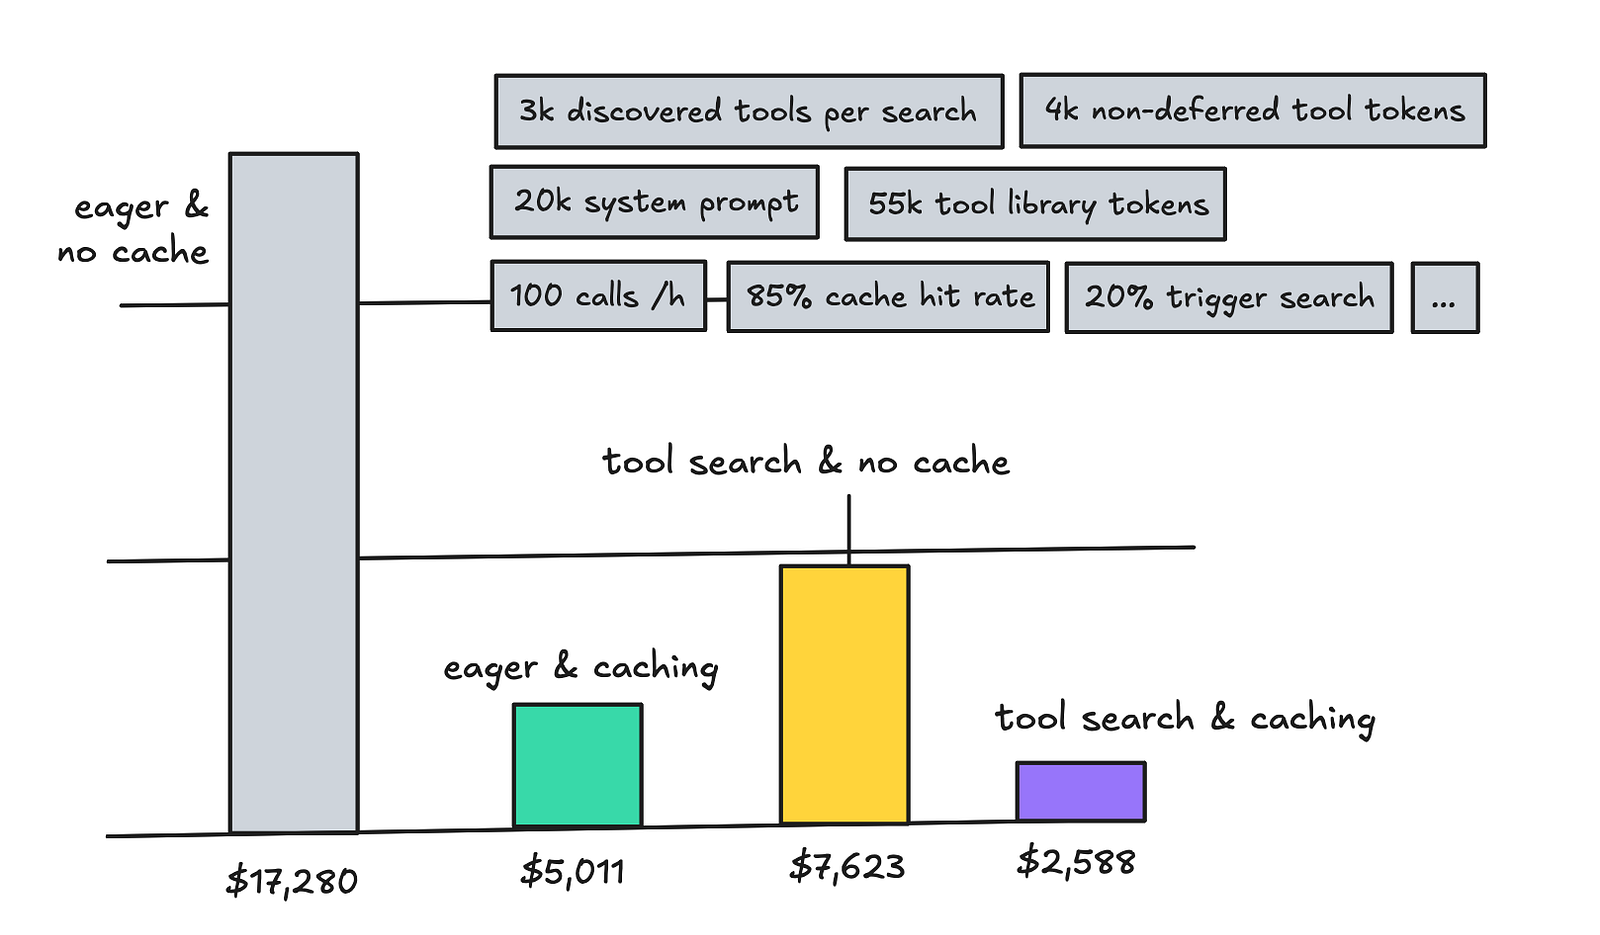
提示缓存+工具懒加载的成本节省示例(估算)
我们可以看到,提示缓存和懒加载上下文都能带来成本节省,但两者结合起来,节省的幅度并不会大幅增加。不过,这样的工具搜索不仅仅是为了节省成本,它还有助于保持上下文的整洁,提升性能。
但如果你只是为了节省成本,至少选择其中一种方法就能获得不错的效果。
本节将讨论如何将提示路由到不同的模型,以及使用更廉价的模型作为子智能体处理特定任务,这种方法如何降低令牌成本,同时可能带来质量风险。
这个领域很有趣,因为大多数人认为,60%以上的传入问题都是简单任务,因此不需要最强大的模型,尤其是不需要具有推理能力的模型。
ChatGPT会利用对话类型、复杂度、工具需求和明确意图(如“认真思考”)等信号进行路由。Claude则使用基于描述的委托和内置的子智能体(如Explore)。
这个思路很容易理解,但如何在不牺牲太多质量的情况下正确实施,是一个难点。
因此,我们将分别介绍预测性路由和基于输出检查的方法(如级联和子智能体),让你了解可以在自己的项目中测试哪些方法。
这里能带来的成本节省是非常可观的。我为这一部分也创建了一个交互式图表,你可以在这里查看。
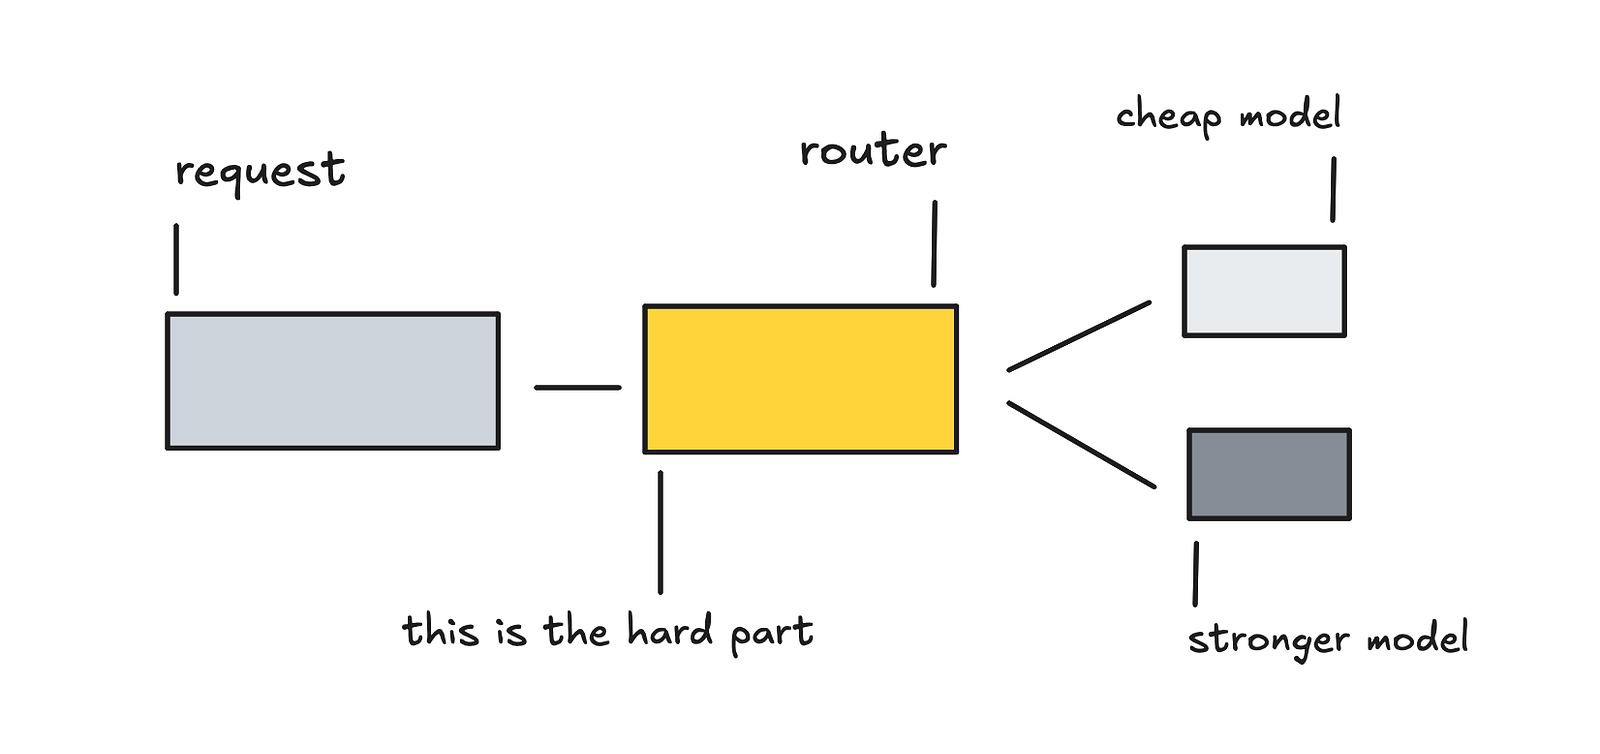
请求级路由意味着在看到输出之前,就尝试估算任务的难度和意图。这种方法的优势很明显,但如果选择错误,可能会影响整个会话,因此需要注意质量方面的不足。
要实现这一点,你需要某种路由器模型来决定将请求路由到哪里。
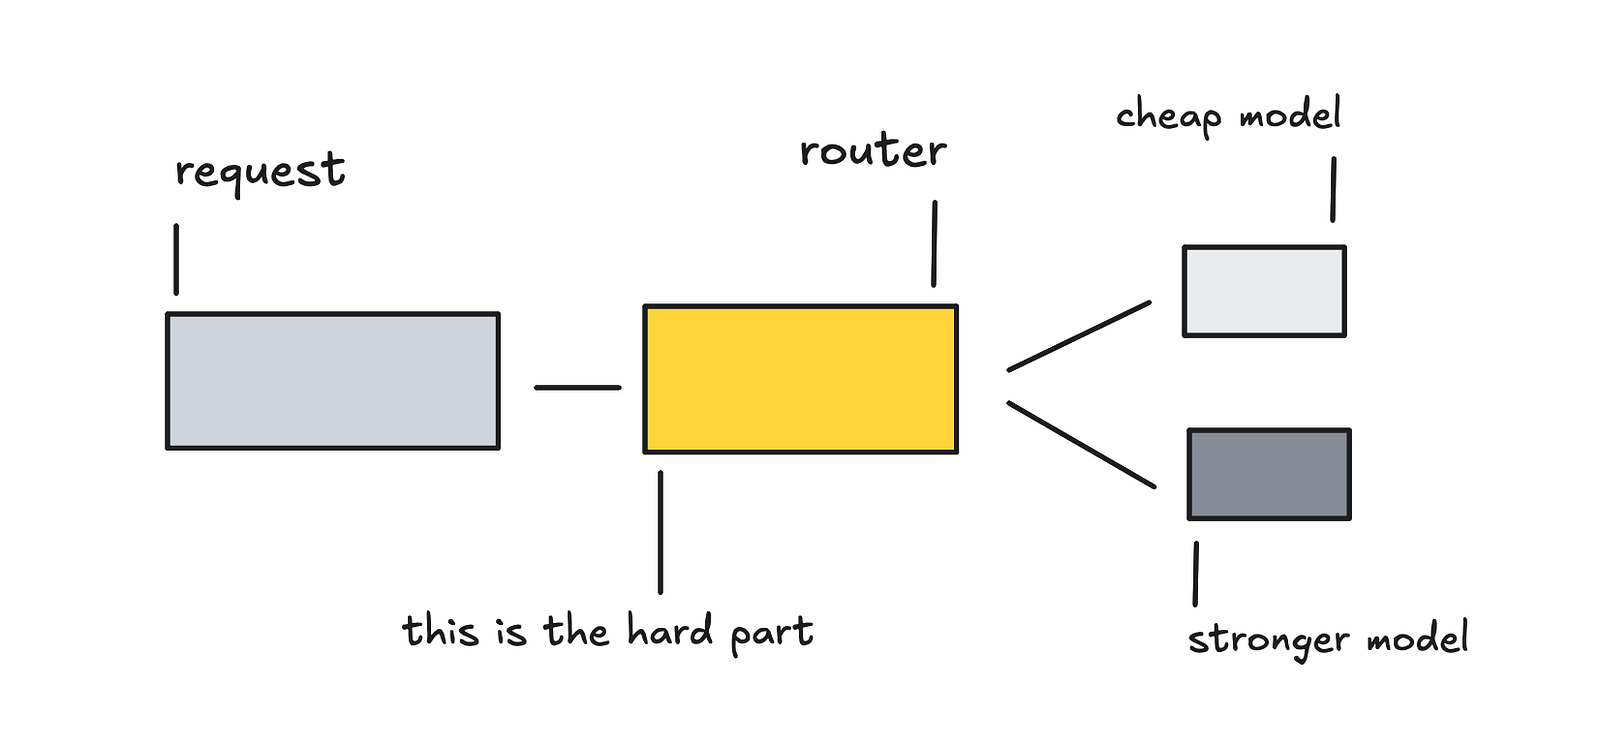
我们并不确切知道OpenAI使用哪些信号来将请求路由到不同的模型,但不知道你是否有这样的感受——我经常觉得自己被委派给了一个能力较差的模型,这可能会让人感到恼火。
不过,我们仍然可以从开源社区中收集一些信息。可以看看LMSYS(Chatbot Arena背后的伯克利团队)的RouteLLM。这个解决方案从Chatbot Arena的真实偏好数据中学习。
RouteLLM使用标准嵌入和一个小型路由头,因此托管它的成本应该不会太高。
我自己没有测试过RouteLLM,但他们报告称,在保持GPT-4大部分性能的同时,能大幅降低成本。
不过,我研究了LLMRouterBench论文,该论文指出,许多学习型路由器的表现几乎不如简单的基线方法,比如基于关键词/启发式的路由、嵌入最近邻路由或kNN风格的路由。
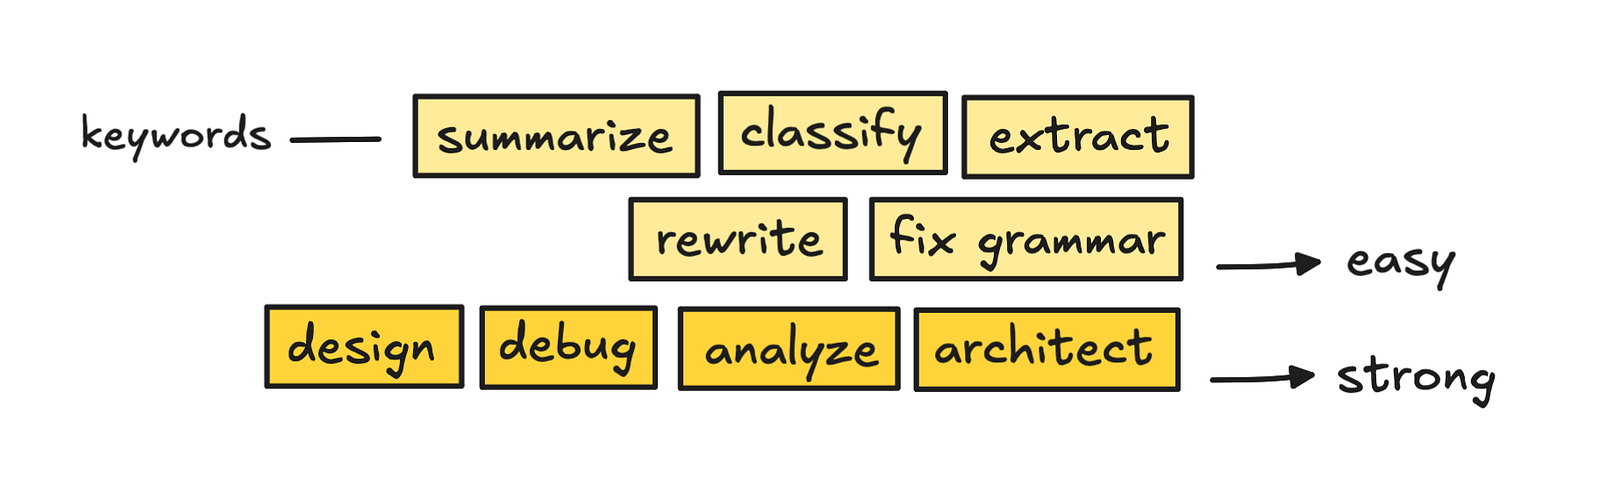
问题在于,这些路由器可能不太擅长判断任务的难度级别,因此与使用简单方法相比,它们可能无法带来太多提升。
尽管如此,人们并没有放弃路由技术,而是仍在不断探索,因此,如果答案质量无法跟上,这种方法在成本节省方面并不会带来显著效果。
目前,这个领域也有一些现成的解决方案,比如OpenRouter Auto和Switchpoint。不过,关于它们的路由内部机制或公开的准确率数据,并没有我所期望的公开信息。
但在本节中,你也可以查看我们为LLMRouter、启发式方法、自托管分类器、LLM作为路由器、RouteLLM、OpenRouter Auto制作的计算器。
至于质量以及它在实际项目中的表现,在我自己进行更充分的测试之前,还不能给出确切结论,因此这个领域确实值得在未来单独写一篇文章探讨。
在继续之前,我们还简要介绍一下级联和子智能体。
与其根据提示猜测请求是“简单”还是“困难”,我们也可以让廉价模型先尝试生成答案,然后再决定是否保留该答案或升级到更强大的模型。
谷歌的“推测级联”(Speculative Cascades)文章中阐述了这种权衡:首先使用较小的模型以降低成本和提高速度,只在需要时才委托给较大的模型。
要实现这一点,先让廉价模型生成答案,然后使用一个轻量级检查器,查看日志概率(logprobs)/令牌概率、熵或边际风格的不确定性,以及/或语义对齐度。
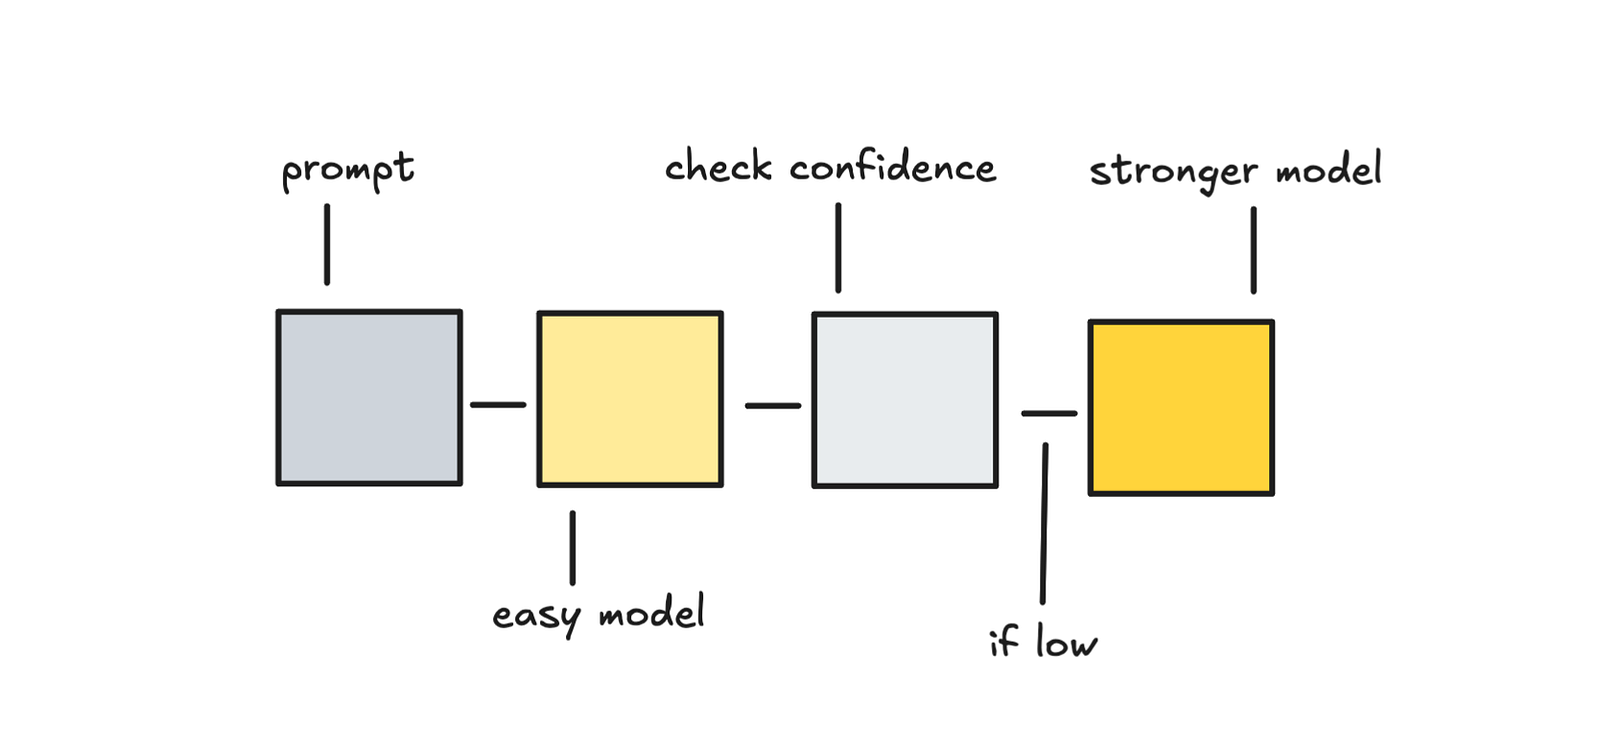
这个思路非常有吸引力,因为正如上面所指出的,提示难度通常很难预测,而且大多数路由器的表现并不完美。
此外,在得到答案后,更容易判断质量。
只有当你认为大多数问题都可以由简单模型回答时,这种方法才有意义,因为对于需要升级的请求,你需要支付两次调用的费用。
但根据实施这种方法的人的反馈,这是一个很有吸引力的选择,因为调用之间的验证延迟可以控制在20毫秒以内。
我研究了一些开源实现,比如CascadeFlow,它声称与GPT-5相比,能节省69%的成本,同时保持96%的质量。但需要注意的是,他们测试的提示有可验证的真实答案,比如数学答案和多项选择题。
需要考虑的一个主要问题是,小型模型往往会“自信地给出错误答案”,因此可能需要设置保守的阈值,更频繁地进行升级。这不可避免地会增加成本。
我也将级联(廉价模型优先)添加到了交互式图表中,你可以将其与其他方法的成本节省情况进行比较。
如果情况属实,使用这种技术可能会将成本降低50%——前提是你确实需要大型模型来处理某些请求。但同样,这也伴随着质量风险。
子智能体是指将工作委托给独立的智能体。有时这些子智能体使用较小的模型,因此我们也可以将其视为一种路由形式。这里的成本节省虽然不那么显著,但值得一提。
将工作委托给子智能体不仅仅是为了成本。它还能保持上下文的整洁,让每个智能体都能专注于自己应该完成的任务。
很多人都知道,Anthropic在Claude Code中内置了子智能体。Explore子智能体明确是一个用于代码库搜索和探索的Haiku模型(Anthropic的轻量型模型)。因此,其设计原则是:使用较小的模型处理成本较低的任务。
Claude的主会话也通过描述匹配进行委托,但我们看不到这一过程。我们只能看到总体成本降低了。
但由于协调器通常仍会参与规划、合成和重试过程,因此节省的成本并不像我们在路由中看到的那么多。
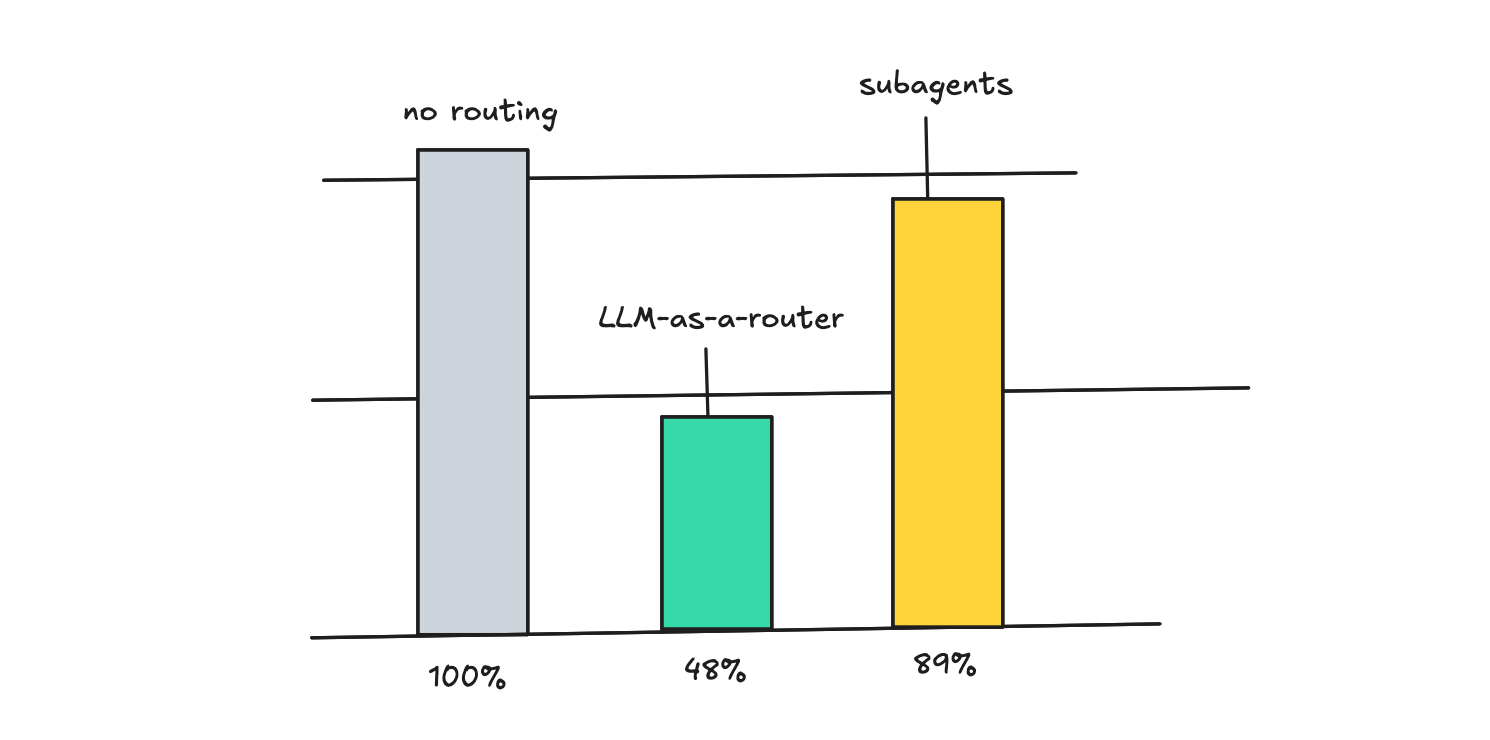
你可以查看上面我们创建的图表,根据我们的计算,子智能体可能会比“不使用路由”的方案节省约11%的成本,因此,如果你只是为了削减成本,这并不是首要选择。
我的下一篇文章将深入探讨子智能体,但更多是将其作为在深度智能体(deepagents)中委托工作和隔离任务的一种方式。
在结束之前,我们来看最后一部分。
良好的上下文工程通常是为了提升性能,但它也能提高成本效率。因此,我们将讨论上下文压缩,并谈谈保持上下文整洁如何节省令牌。
问题在于,智能体会不断积累无用信息:工具输出、日志、重复的观察结果、旧计划、过时的尝试和重复的状态。
对于第一次构建智能体的人来说,这种情况尤其常见——他们会将结果不断添加到主智能体的工作状态中。
[系统规则]
[项目规则]
[用户任务]

grep输出:2,000行
文件读取:900行
测试日志:1,300行
重试日志
重复读取
过时的无效推理
更多日志
更多日志
更多日志
我自己在构建草稿智能体时,也自然会这样做,先看看它的“表现”如何。
但我也看到有人抱怨OpenClaw的上下文积累问题,这种情况在任何地方都可能发生。人们也会抱怨Claude Code,因为一般来说,将内容添加到上下文中比清理它更容易。
我们简要讨论一下这个问题,不过不会过多涉及性能方面(这也是你应该保持上下文整洁的原因之一)。
这是一个双层问题。你不仅要“压缩对话”,还需要在将内容添加到工作状态时保持其整洁,这需要大量繁琐的工程工作。
首先,为了保持上下文整洁,我们不希望出现这种占用大量上下文的结果。
糟糕的状态:
智能体执行工作
→ 将工具输出倒入上下文
→ 读取文件
→ 将文件倒入上下文
→ 运行测试
→ 将日志倒入上下文
→ 重试
→ 保留所有内容
因此,真正的工作是在进行过程中保留正确的状态,同时删除无用信息。
像这样的原始输出可以存入归档,只有需要的内容才放入活跃上下文。一般来说,这里的主要问题可能是工具输出的膨胀,因此工作重点是让工具默认输出更少的无用信息。
[系统规则]
[项目规则]
[用户任务]
[当前工作状态]

保留:
+ 认证流程位于auth.ts和session.ts中
+ 漏洞仅在刷新路径上出现
+ 失败测试:session_refresh_keeps_user
+ 可能是刷新时的覆盖问题
+ 相关文件:auth.ts、session.ts、auth.test.ts

丢弃:
- 原始grep结果
- 完整测试日志
- 重复的文件内容
- 无效的重试
我还认为,某些上下文内容可以有生命周期或过期时间。
这样一来,当你需要压缩上下文时,就更容易判断哪些内容对LLM有用。
如果我们看看Anthropic的相关文档,他们指出,当上下文需要压缩时,你还需要想办法保留架构决策、未解决的漏洞和实现细节。
对于LangChain的自主压缩功能,智能体会决定何时进行压缩,而不是像Anthropic那样,只在上下文已经膨胀后才进行压缩。
有趣的是,团队也开始将压缩视为一个系统问题,制定了基准和智能体特定的策略,而不仅仅是将其作为一种通用的总结技巧。
我们也可以看看最近的一篇论文,了解一下可能的结果。贾等人(Jia et al.)的这篇论文认为,在6倍压缩率下,令牌预算可减少51.8-71.3%,同时在SWE-bench Verified(软件工程师基准测试)上的问题解决率提高了5.0-9.2%。
因此,这不仅与成本有关,还与整体性能有关。
至于成本,构建良好的上下文本身显然需要大量工作,但删除无用信息可能会清理掉30-70%的上下文,从而节省相应比例的成本。
举个例子,对于10,000个令牌的上下文窗口,如果在100,000次运行中清理掉30%到50%的无用信息,你可能最多节省1,500美元。对于40,000个令牌的上下文窗口,这个数字会上升到6,000美元。
我们也为此做了一个计算,你可以在这里直观查看。
需要注意的是,对于使用非常小的廉价模型的智能体,进行压缩可能会导致成本更高。
尽管如此,保持上下文整洁的好处在于,它不会像语义缓存或路由那样牺牲质量,因此如果实施得当,这是一个明确的增益。
显然,难点在于实施过程中的工作量。
这是一篇很长的文章,介绍了四种在构建智能体时可以削减令牌成本的方法。
具体采用哪种方法,很大程度上取决于你的使用场景:如果你在循环调用LLM时使用的是大型且不变的系统提示,就使用提示缓存;如果你有一个需要保持低成本的通用问答机器人,就使用语义缓存。
如果你需要同时处理简单和困难的问题,可以测试路由技术;如果你想确保不发送不必要的令牌,就保持上下文尽可能整洁。
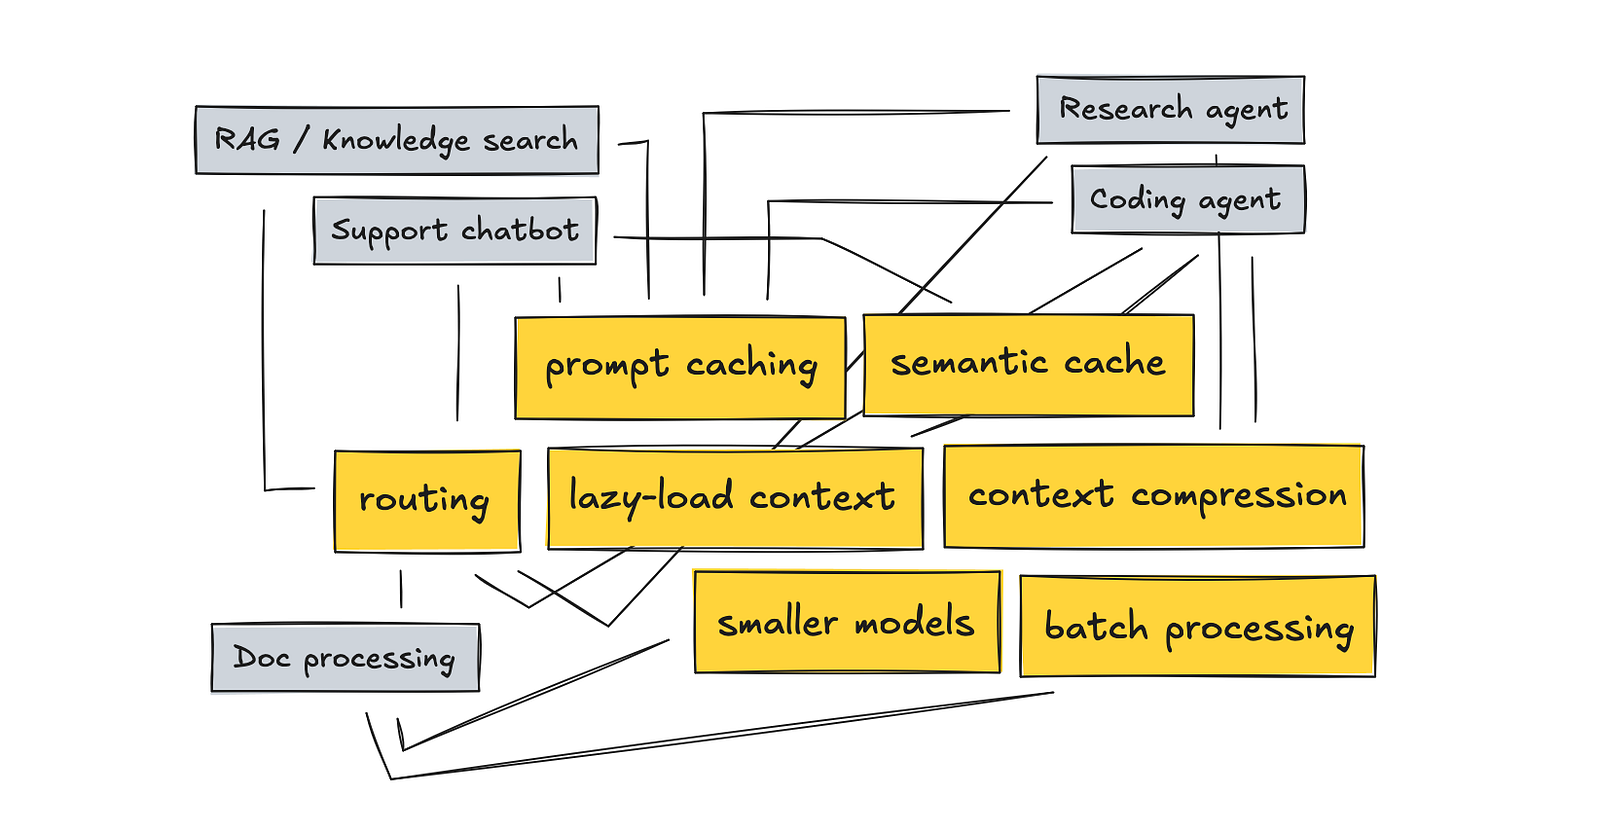
未来或许值得写一篇更短、更聚焦经济层面的文章,针对特定设置进行深入探讨。
希望这篇文章对你有帮助。如果你想一起研究智能体,或者想阅读更多类似内容,可以通过LinkedIn、Medium或我的个人网站与我联系。

 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏






