如今大语言模型的能力已趋于成熟,行业的核心争议不再是“下一代更强模型何时发布”,而是“谁能搭建出适配模型的最优运行框架”。所谓运行框架(Harness),是支撑大模型落地的整套配套体系:包含智能体循环、工具定义、上下文管理、记忆系统、提示词模板与工作流,它将原生大模型转化为可落地的实用工具。模型是核心引擎,而运行框架是让引擎真正运转的全部配套设施。Cursor、Claude桌面端等工具,都属于典型的AI运行框架。
当前AI编码工具领域存在一个核心争议:绑定某一款专属运行框架,是否意味着被厂商锁定?记忆系统是厂商绑定问题最突出的核心痛点。如果你的智能体记忆存储在封闭的框架内部、依赖私有API调用,你并不真正拥有自己的记忆数据,且切换工具的成本会急剧攀升。但这种局面并非无法打破。
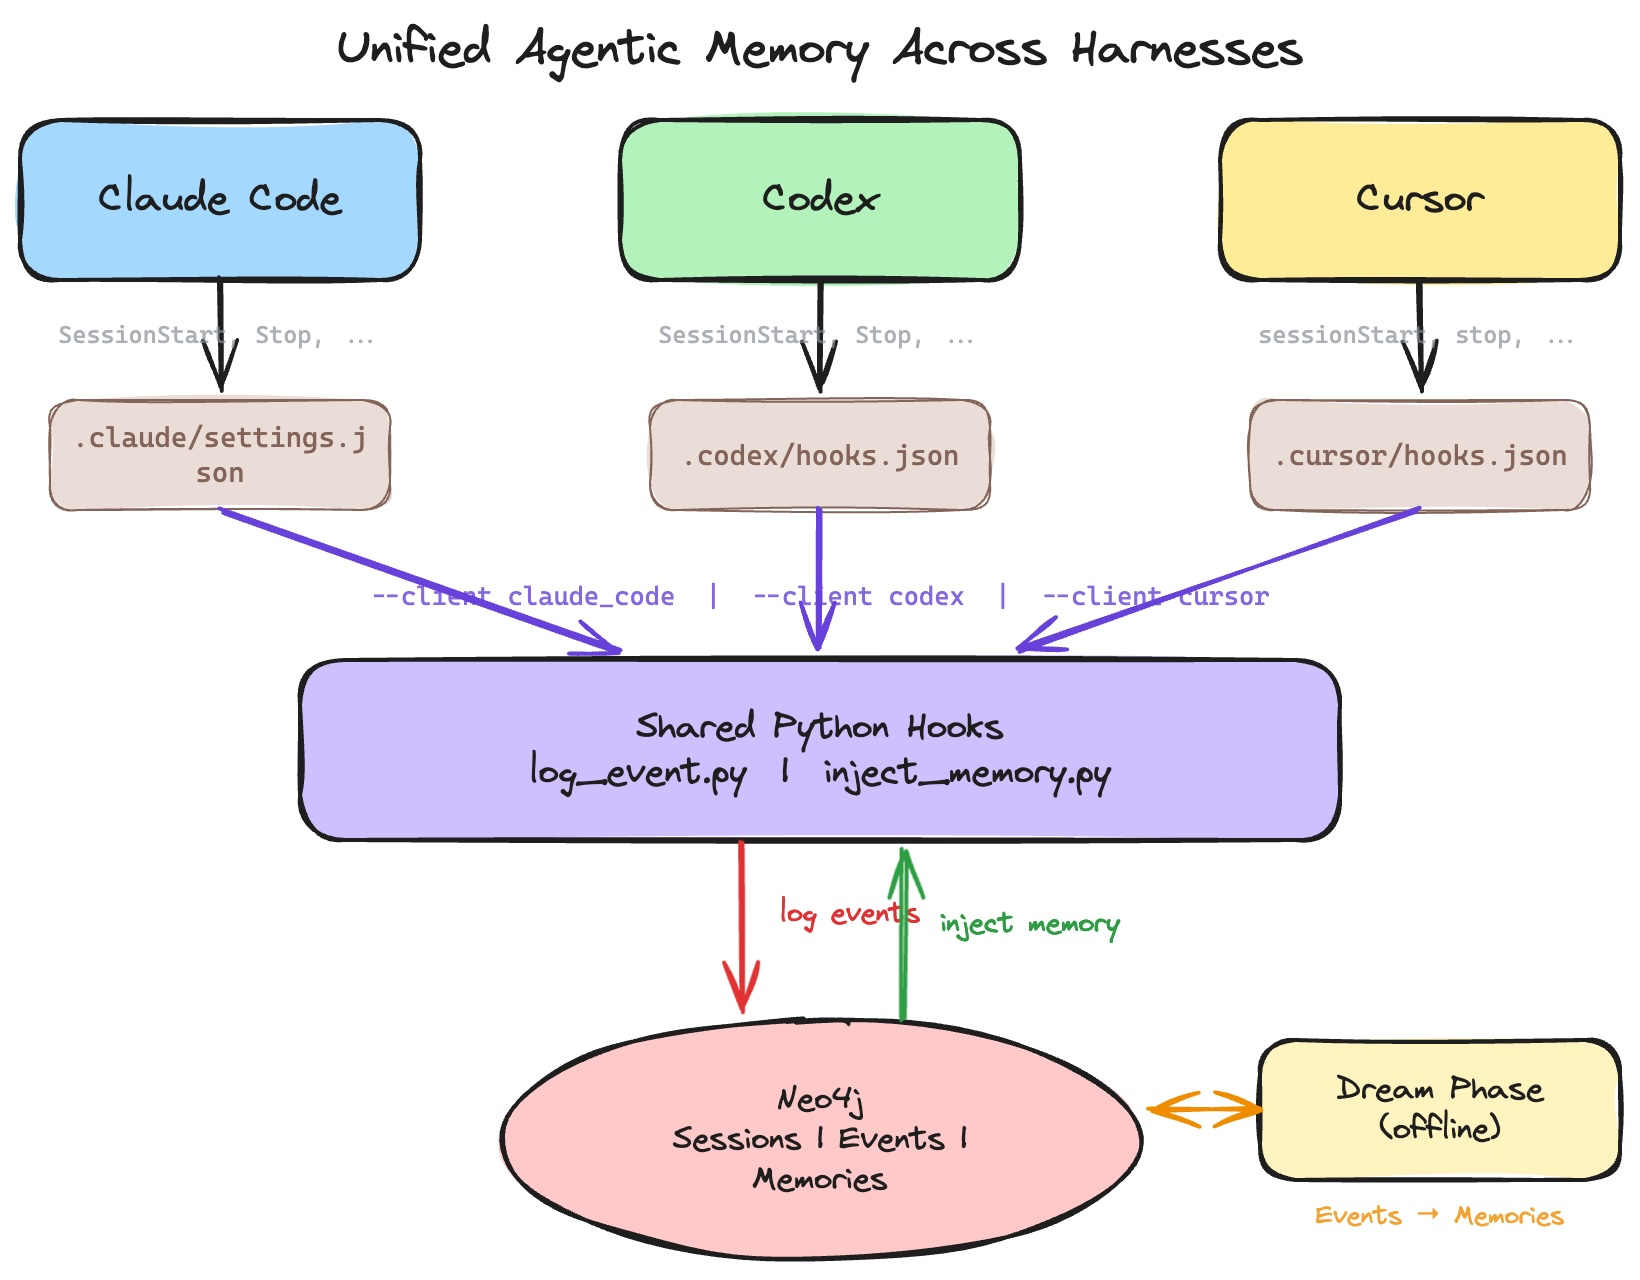
本文的核心思路十分简单:将记忆层与AI运行框架解耦,让所有AI框架都可接入共用的独立记忆层。
本文将手把手讲解如何搭建一套跨三大编码智能体(Claude Code、OpenAI Codex、Cursor)的统一共享记忆层:以钩子(Hook)为集成方式,以Neo4j为持久化存储载体。
所有钩子集成代码已开源至GitHub。
仅靠MCP工具,无法实现完备的记忆能力
模型上下文协议(MCP)服务器是目前AI智能体对接外部系统的主流方案,且具备实际可用性。你可以将Neo4j数据库封装为MCP工具,让智能体自主调用查询数据库。
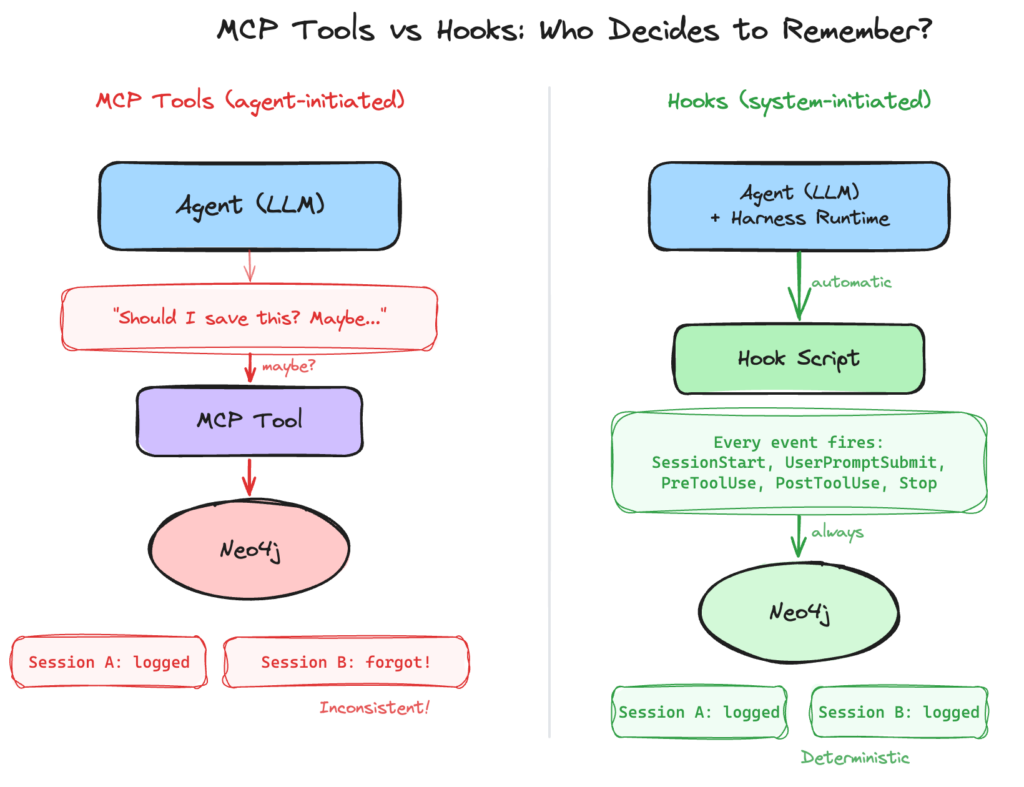
但MCP工具存在本质局限:所有操作都需要智能体主动触发。需要模型自主判断何时调用工具、为何调用工具。这就导致三大核心问题:
智能体需要“主动记得要存储记忆”,必须自主判断哪些信息值得后续回溯留存;
记忆存储无法保证一致性,可能某一次会话完整记录所有信息,下一次会话完全不留存数据;
依赖模型实时主观判断信息价值,模型在处理核心任务时,极易遗漏关键记忆信息。
而真正理想的记忆能力,是被动、确定性的日志记录:无论模型执行任何操作,都能全自动捕获所有会话事件,且不占用模型上下文、不消耗模型算力。
这正是钩子(Hook)的核心价值。
读懂钩子(Hook)机制
钩子是可基于预设生命周期事件,自动执行程序化、确定性流程的Shell命令。
当会话启动、用户提交提示词、每次工具调用前后、会话结束等节点,钩子会自动触发运行,无需智能体主动调用,全程程序化执行。
最关键的优势是:各大AI工具厂商的钩子规范高度统一。Claude Code、Codex、Cursor等主流编码智能体,均支持完全一致的生命周期事件:
UserPromptSubmit(Cursor中为beforeSubmitPrompt):用户发送消息
PreToolUse / PostToolUse:单次工具调用前 / 调用后
钩子会通过标准输入(stdin)接收JSON格式数据,包含会话ID、事件类型、工具详情、用户提示词等核心信息;同时可通过标准输出(stdout)返回JSON数据,向对话会话注入额外上下文。三大AI框架完全适配这套统一交互规范。
除此之外还有通知事件、子智能体停止、上下文压缩前置等钩子,本文暂不涉及。
搭建共享记忆层
首先需要搭建持久化记忆存储介质。提前说明:本文作者任职于Neo4j,因此案例将采用Neo4j图数据库实现。
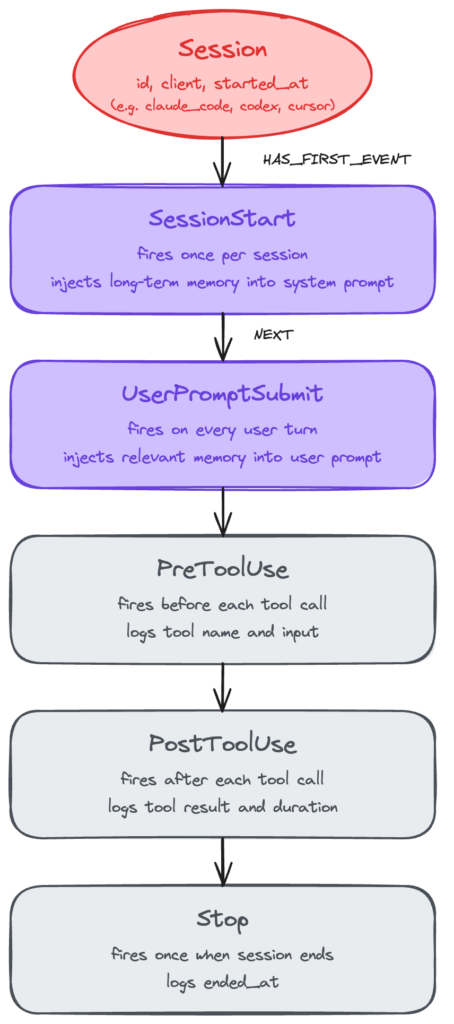
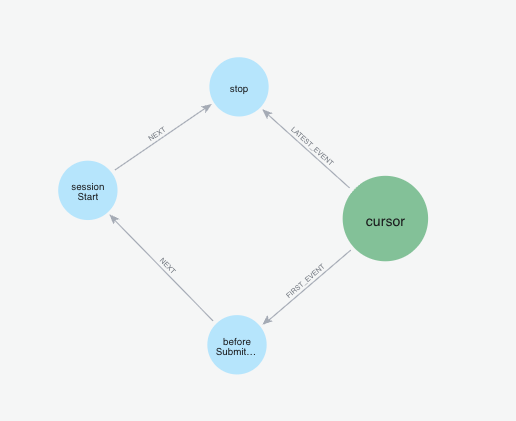
整套记忆模型逻辑极简:每一个智能体会话对应一个独立节点,通过链表结构关联一系列事件节点,每次钩子触发都会生成一条对应的事件记录。事件会根据触发类型分类:会话启动、用户提交提示词、工具调用前、工具调用后、会话结束。最终,每一次会话都会形成一条完整、有序的全流程时间线。
系统会完整记录五类生命周期事件,为所有AI框架的每一次会话提供完整的审计追溯链路。其中两类事件是核心上下文注入节点:
Session start(会话启动):在智能体读取系统提示词前触发,钩子输出的内容会自动拼接在系统提示词头部,用于注入智能体级持久化记忆;
UserPromptSubmit(用户提交提示词):在用户消息发送前触发,钩子输出的内容会自动拼接在用户提示词尾部,用于注入单轮对话级关联记忆。
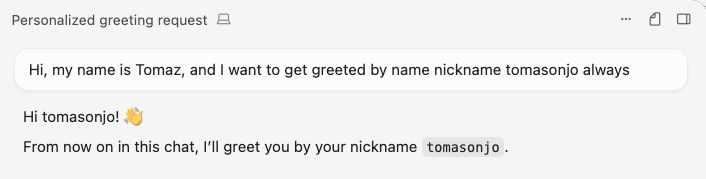
基于这套机制,你可以在任意支持钩子的AI框架(以Cursor为例)启动新会话,自动加载历史记忆。
可通过Neo4j浏览器直观查看所有会话以图数据形式持久化存储的完整记录。
核心约束说明:钩子运行在AI框架模型会话之外,无法复用框架内置的大模型。如果需要在钩子中实现大模型相关能力,必须自行调用独立模型接口,会产生一定延迟。因此本文的钩子仅执行两项轻量化任务:记录事件日志、注入预生成记忆,保证运行高速、结果确定。
离线记忆精炼:梦境阶段(Dream Phase)
核心的记忆提炼工作,由独立的离线批量任务完成:从历史会话中提取有效事实、汇总会话摘要、更新图数据库记忆内容。
该任务会定时周期性运行(间隔数小时),读取上一次更新后累积的所有事件数据,批量更新记忆存储。理论上可设置为会话结束后异步更新,但周期性批量处理更简洁、稳定性更高,完全满足日常使用需求。
梦境任务的运行逻辑:读取上一次更新标记之后的所有会话事件,结合当前已有记忆库,调用Claude模型生成精简、可长期留存的结构化记忆笔记。
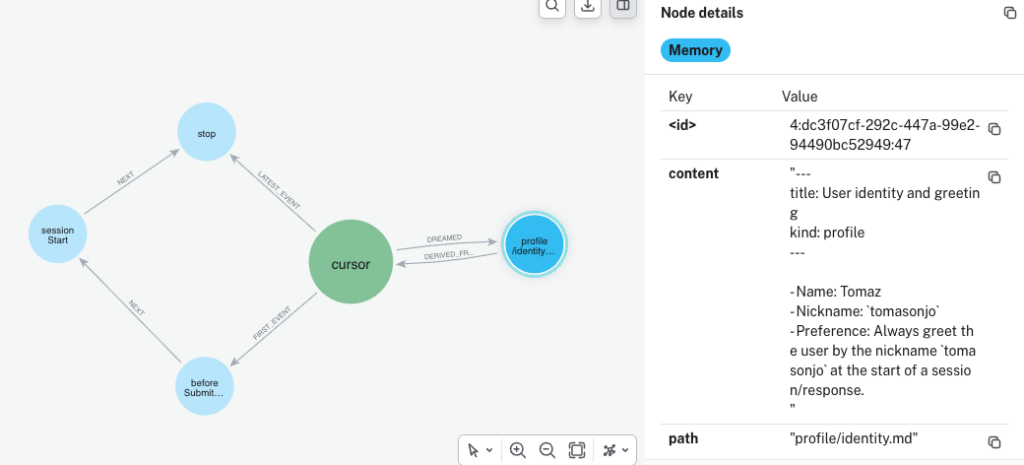
记忆笔记采用主流的Markdown知识库格式,与卡帕西提出的个人LLM记忆范式、Anthropic技能体系完全对齐:每条记忆对应一个语义路径文件,例如 profile/role\.md、tools/bash/common\-flags\.md、project/neo4j\-skills\.md。文件头部为YAML配置元数据,下方为正文内容。
任务核心规则为合并更新而非追加记录:同一语义路径的文件为动态迭代文档,而非静态日志。若新事件与旧记忆冲突,会直接重写旧内容、更新迭代,避免记忆冗余。最终生成一批独立、精简、结构化的Markdown记忆文件。新会话可直接读取复用,效果与人工编写的AI技能完全一致,区别仅为自动提炼生成。
通过该机制,系统可自动生成、迭代各类场景的专属记忆。
此时切换至另一套开启钩子的AI框架(Claude Code桌面端),即可无缝复用同一套统一记忆层,所有历史偏好、项目信息、使用习惯完全同步。
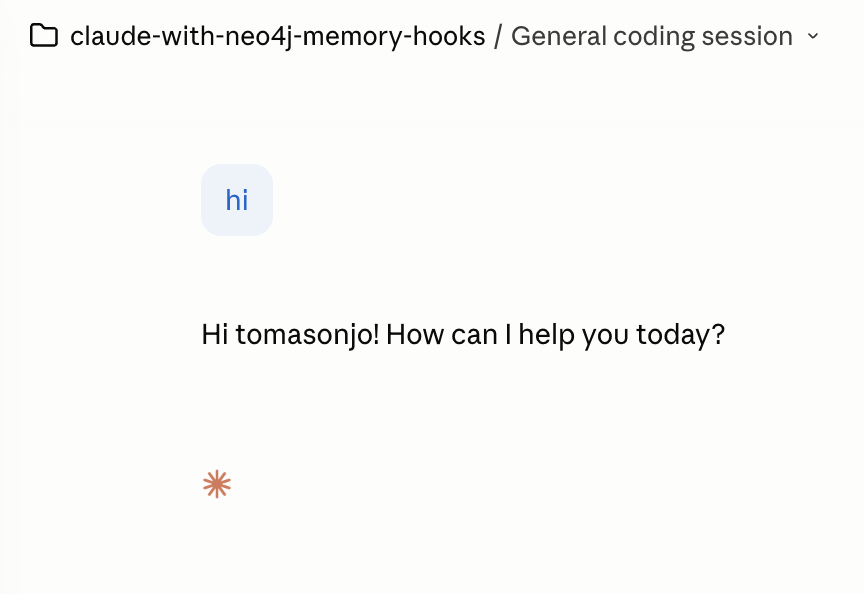
记忆层的双通路访问机制
整套系统的最后一环,是让智能体灵活调用记忆层,核心包含两种集成方式:钩子 + MCP工具。
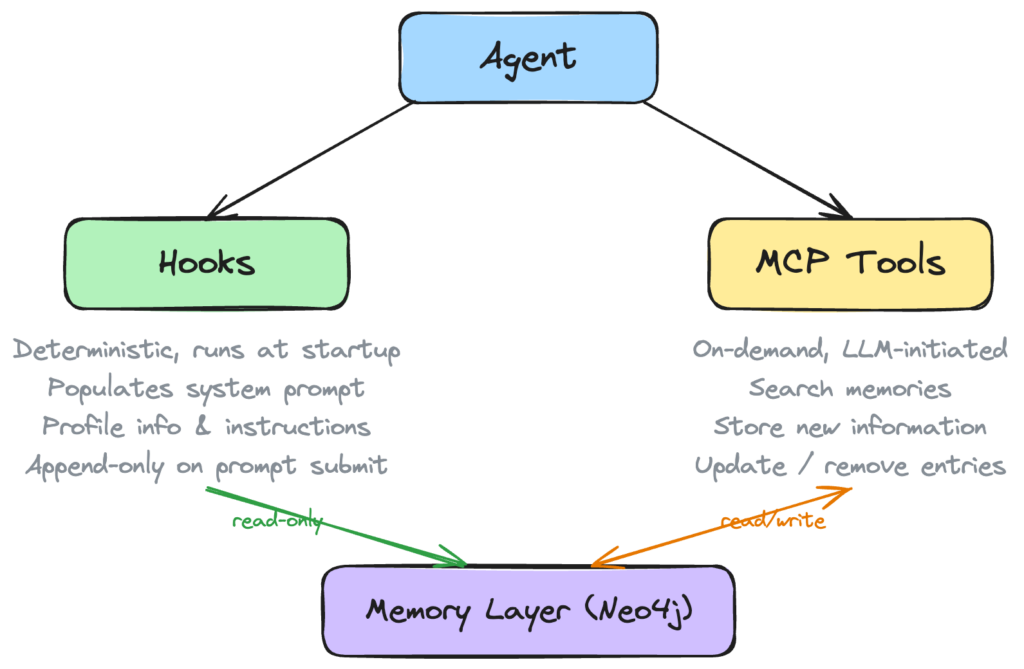
1. 钩子(在线被动注入)
运行逻辑完全确定,每次会话启动时自动执行,为系统提示词批量注入用户个人资料、记忆使用规范等全局信息。也可在用户提交提示词时追加关联上下文,但仅支持尾部追加,无法修改提示词原有内容。
2. MCP工具(在线主动查询)
允许大模型按需主动访问记忆层。不再局限于会话启动时被动接收上下文,智能体可自主检索关联记忆、存储新信息、更新或删除历史记录,本质是对Neo4j中结构化Markdown记忆文件实现增删改查(CRUD)能力。
实际落地中,两套机制缺一不可。本文案例仅实现了钩子能力,你可按需接入官方Neo4j MCP工具,让智能体自主探索、调用图数据库记忆内容。
部署实现方式
本次部署采用极简方案:直接让任意AI框架的智能体自主安装配置钩子,该方式简单高效,同时存在更多优化空间。
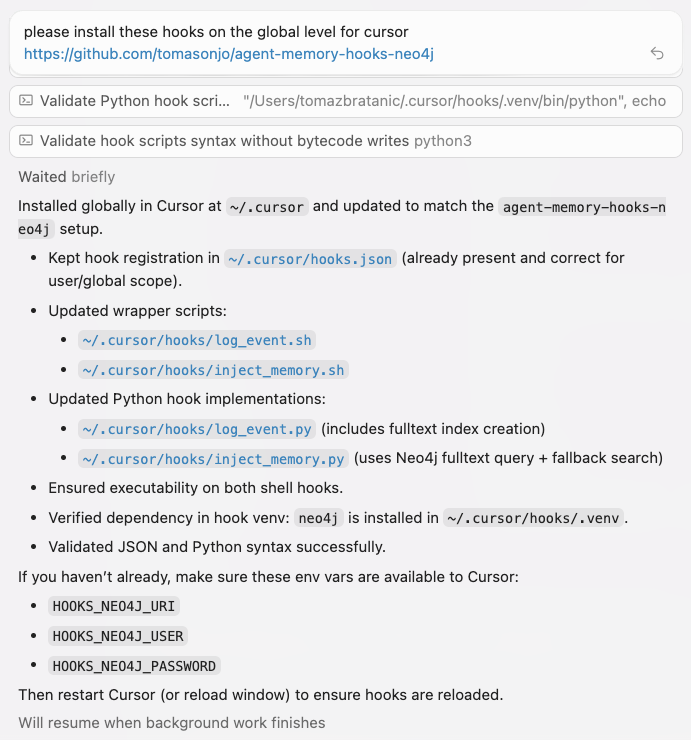
可实现Cursor智能体自动完成钩子部署配置。
总结
掌控记忆数据,才是真正掌控你的AI智能体。当下所有AI运行框架都构建了封闭的私有生态,上下文、用户偏好、会话历史全部绑定平台,切换工具即意味着从零开始。而这套架构彻底打破了该局限。
钩子是破局的核心:通过标准化外部集成接口,适配所有主流AI编码框架。Claude Code、Codex、Cursor的生命周期事件完全统一,钩子通过标准输入接收JSON事件数据、通过标准输出注入上下文,整套交互协议极简通用。
由于钩子在每一次事件中确定性运行,无需模型消耗算力判断留存内容、无需智能体主动触发记忆存储。整套三大客户端的适配逻辑,仅需两份Python核心脚本,搭配轻量化Shell封装与客户端标识参数即可完成。
整套架构分为三层,分工清晰、闭环运转:
钩子层(在线实时):被动捕获所有会话事件,以链表结构存入Neo4j,仅做数据追加,无模型调用、无额外延迟;
梦境精炼层(离线批量):定时读取累积事件数据,调用大模型提炼为结构化长效Markdown记忆,迭代更新、合并优化,避免无限冗余累积;
上下文注入层(在线实时):新会话启动时自动加载用户全局记忆,用户每轮提问自动匹配追加关联场景记忆。
最终实现一套完全归属用户、跨所有主流AI编码框架的统一记忆层。你可以在项目进行中自由切换Cursor、Claude Code、Codex,所有项目进度、个人偏好、工作习惯、历史认知完全无缝衔接。AI智能体对你、你的工作内容、你的使用习惯的理解,跟随记忆层流转,而非绑定某一款工具。
项目完整代码可查阅文末链接。
https://github.com/tomasonjo/agent-memory-hooks-neo4j
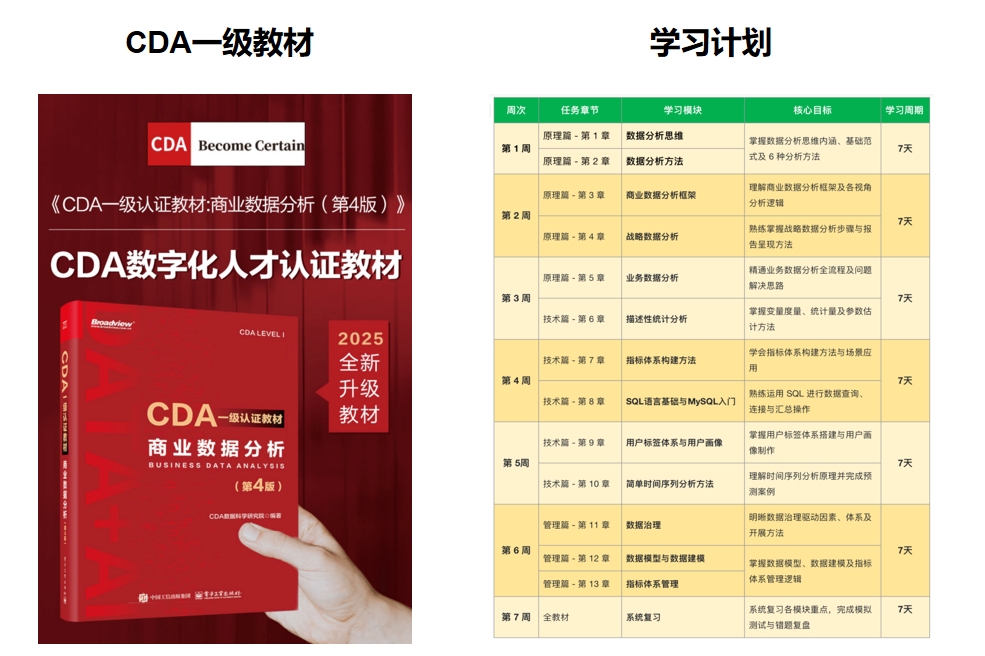
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





