关注CAIE,国内头部AI人才认证、培训体系,助你在职场升职加薪。CAIE,全称 Certifed Artifcial Intelligence Engineer(人工智能工程师),简称 CAIE(赛一) ,是人工智能领域的技能等级认证。旨在评估和培养具备
人工智能理论基础与实战能力的职业人士。
字节跳动联合多个机构开源了一个重磅模型BitDance,直接给自回归图像生成技术来了个大升级。
这模型最牛的地方就是不用传统的码本索引,转而预测二进制视觉token,靠三个核心组件解决了老问题,不仅生成质量拉满,速度还快得离谱。
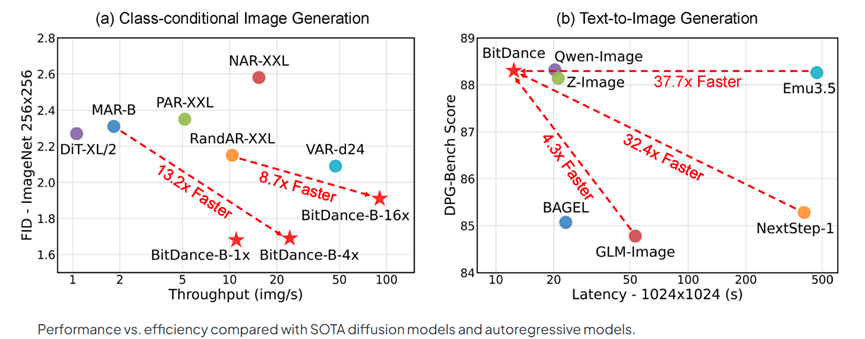
在ImageNet256×256数据集上拿到1.24的FID值,创下自回归模型的最好成绩,生成1024×1024高清图时比之前的自回归模型快30多倍,参数量还少了5.4倍。
开源地址:https://github.com/shallowdream204/BitDance
在线体验:https://huggingface.co/spaces/shallowdream204/BitDance-14B-64x
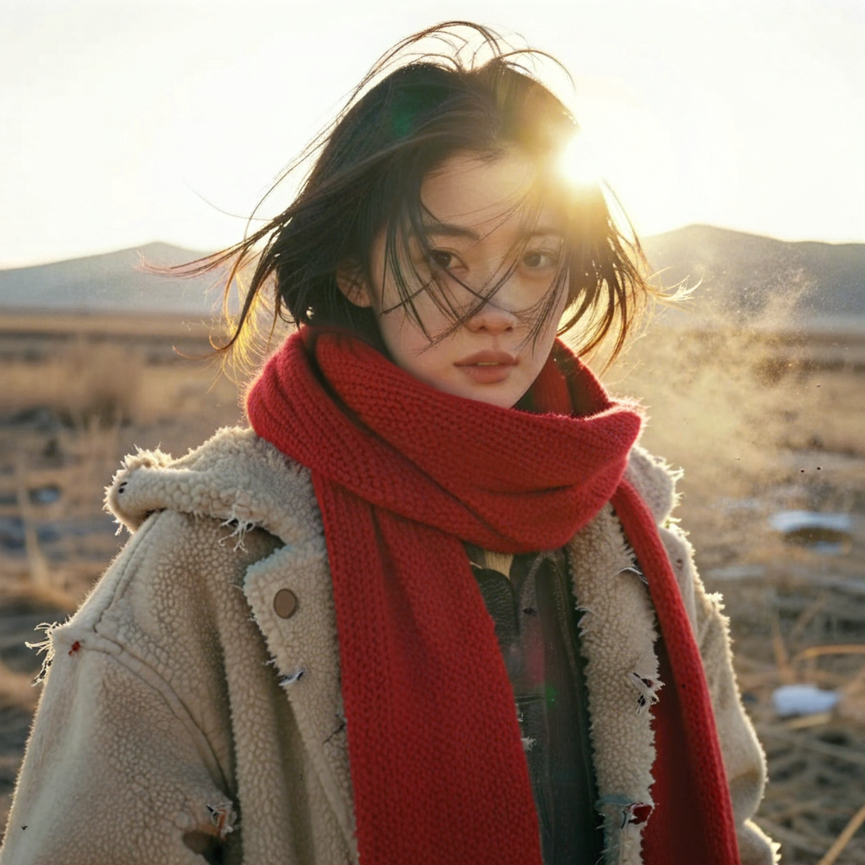
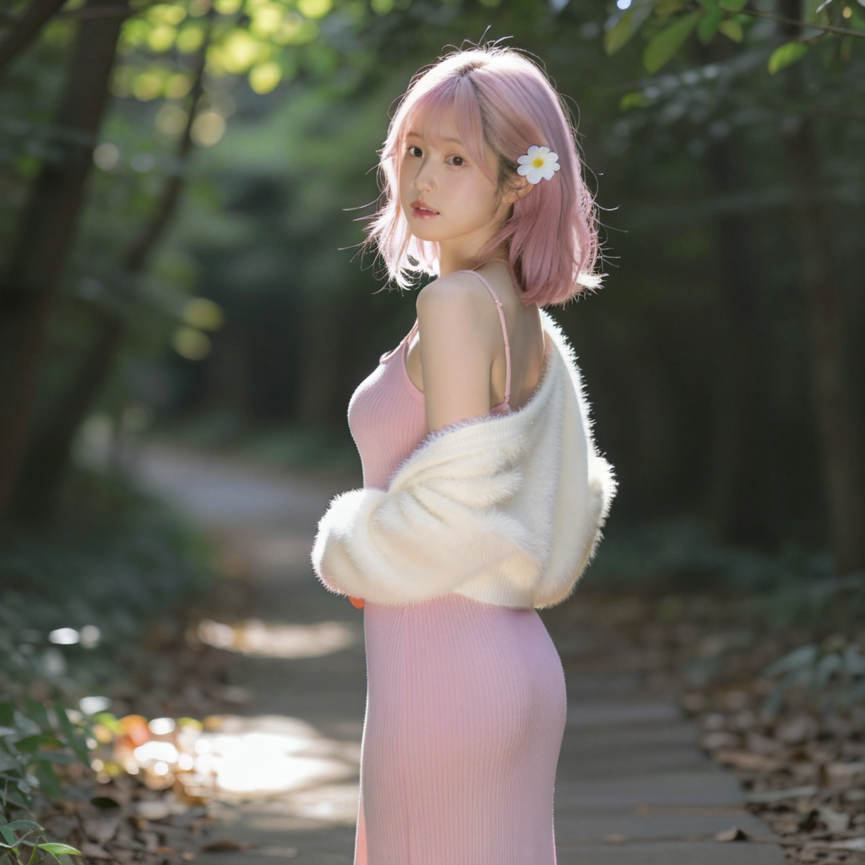
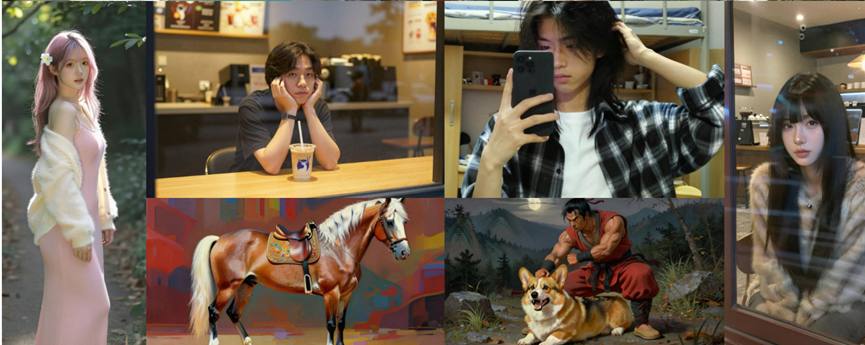
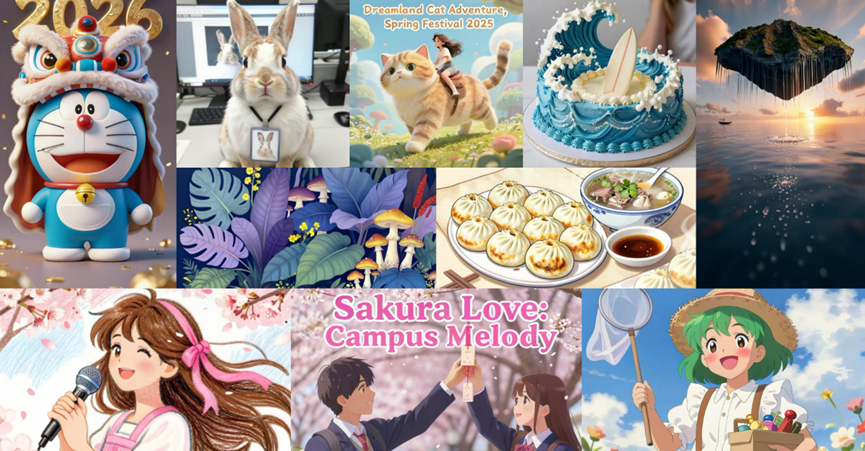
目前已经开放在线测试啦,生成效果那是相当逼真,是不是有小红书照片感觉了,并且去掉AI生成人物的油腻感。
先说说背景吧,不然有些朋友可能不知道这块儿有多难。自回归生成在文本领域那是混得风生水起,ChatGPT就是典型代表,一个字一个字往后预测,效果杠杠的。
可一到图像领域就蔫了,就像一个学霸突然换了个完全不擅长的科目,咋学都不对劲。
第一个是token设计的平衡问题。图像token得又能装下丰富细节,又不能在生成长序列时出错越来越多。
之前的离散模型用矢量量化,词汇表一扩大就容易出问题,重建出来的图糊里糊涂
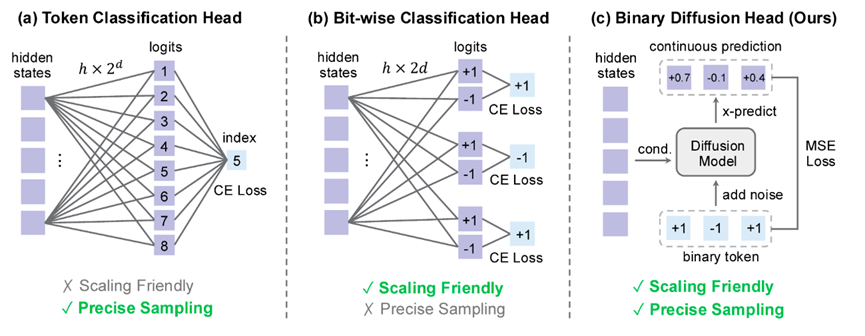
第二个是大词汇量采样的效率坑。想让token表达能力强,就得扩大词汇表,但传统分类头根本扛不住。
要么参数量暴增到硬件扛不住,要么假设比特独立忽略关联,采样出来的图质量暴跌,怎么选都不对。
第三个是推理速度慢得让人着急。自回归本来就是一个token一个token地生成,图像分辨率一高,序列变长,等生成完一张图得花老长时间。
后来有并行生成的方法,但都是独立采样token,生成的图要么结构乱,要么有伪影,速度和质量始终不能两全。
而BitDance正好对着这三个痛点下手,从token、采样、解码三个方面全革新,终于让自回归生成在表达力、精度和速度上都达标了。
以前的token器要么表达力不够,要么容易出错,BitDance直接用了二进制量化的思路,搞了个大词汇量的token器,把词汇表规模做到了2的256次方,比之前的离散token器大了好几个数量级。
它用的是无查找量化,不用复杂的码本学习,直接把每个通道的数值变成1或-1,形成二进制token。
词汇量上去了,怎么精准采样又成了问题,BitDance的二进制扩散头就是来解决这个的。
它不像传统分类头那样硬算,而是把二进制token当成连续空间里的超立方体顶点,用扩散模型来建模,既控制了参数量,又没丢采样精度。
举个例子,要是直接建模32通道的二进制token,传统分类头得要4.4万亿参数,根本不现实。
逐比特分类虽然参数少,但忽略了比特间的关联,采样出来的图质量差。
而二进制扩散头把离散token映射到连续空间,用整流流公式优化,加噪声再去噪声,最后再转成二进制,完美平衡了效率和精度。
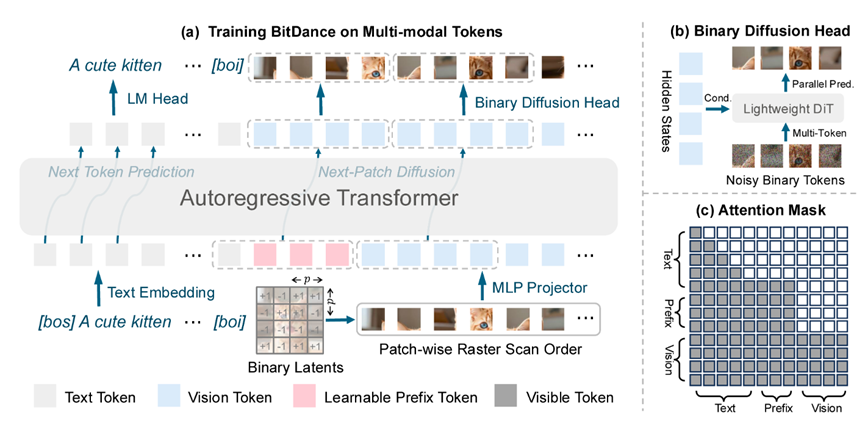
解决了token和采样问题,最后就是提升速度了。BitDance发现图像里局部块的token关联性很强,就像搭积木时相邻的积木总是配套的,所以可以把这些token分成块,一块一块地并行生成,而不是一个一个地来。
它把token序列分成多个块,每个块里有p×p个token,生成时逐块预测,块内的token可以互相参考。
为了让模型能处理这种结构,还用了块式因果注意力掩码,块内token能互相看见,块间保持顺序依赖,既保证了生成的连贯性,又提升了速度。
更关键的是,它把二进制扩散头扩展到多token预测,直接建模块内token的联合分布,解决了之前并行生成的训练推理偏差问题。
为了测试BitDance性能,研究团队在多个平台上进行了测试。在ImageNet256×256的类条件生成任务中,BitDance的表现让人惊艳。
10亿参数量的BitDance-H-1x拿到1.24的FID值,创下自回归模型最佳,比同量级的xAR-H、SphereAR-H都强,甚至比不少扩散模型表现还好。
在评测基准上,BitDance的表现相当能打。DPG-Bench拿到88.28的高分,和闭源的Seedream3.0持平;GenEval得分0.86,在自回归模型里排第一。
OneIG-EN和OneIG-ZH也都是自回归模型里的最佳,英文得分接近GPTImage1,中文超过了GLM-Image。
更难得的是,它只用了不到4.5亿图像文本对,比商业模型的训练数据少多了,样本效率超高。
生成效率方面也超高,生成1024×1024图像,在H100GPU上延迟才12.4秒,比NextStep-1快了30多倍,比GLM-Image也快不少。
甚至比Qwen-Image、Z-Image这些扩散模型都快。蒸馏后的模型质量几乎没降,速度还能再提升,高清图生成再也不用等半天了。
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏