按住下方图标,点击小程序
免费领取AI学习资料、精选提示词
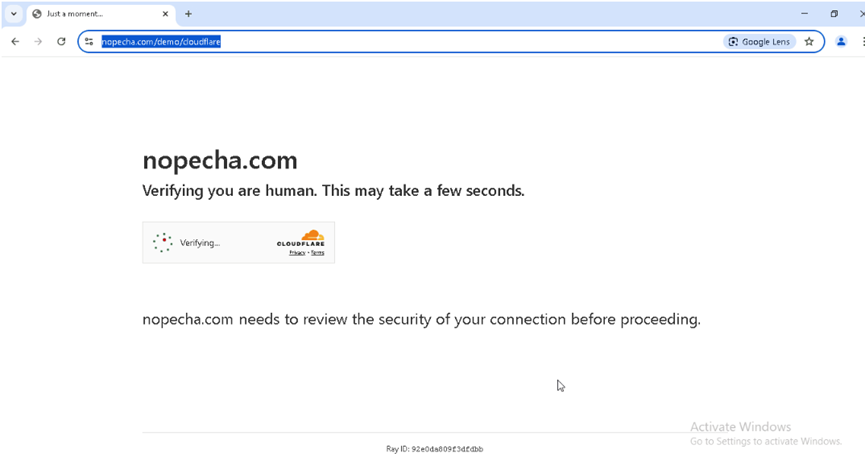
开发过爬虫的小伙伴估计有过这样经历,刚写好的爬虫就被Cloudflare的五秒盾拦截。
验证码弹出来冲你笑,浏览器指纹检测把你的Selenium和Playwright直接挂掉。
要命的是,脚本跑了两百页之后突然全被封了,你盯着屏幕一脸茫然,不知道哪一步出了问题。
今天介绍一个github超过5500星,可以反Cloudflare的全栈式开源爬虫botasaurus。
开源地址:https://github.com/omkarcloud/botasaurus
先聊聊这个框架最让我惊讶的一点,就是那种近乎无敌的防检测能力。Botasaurus的浏览器驱动是经过特殊优化的,能模拟出特别接近真实人类的浏览习惯。
例如,Cloudflare、Datadome这类出了名难搞的防护系统,在它面前基本就是形同虚设。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4586332998211584002" data-mpvid="wxv_4586332998211584002" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fmmbiz_jpg%2FjuxlRdXDvzHgH2FRX9Ux8y2Zo7JmVoZBlnAZ4xOh9yBVYuLmn4RhbdV0BCcx2ObQWQ2dbjE7DWeAYZKibbich07QZvhicQSGZms5eDPPNeRR90%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1920"></iframe>再说一个看着不起眼,但用好了能省大钱的缓存功能。大型爬虫项目里面,网络请求和浏览器渲染是最烧时间和金钱的。
而Botasaurus能轻松缓存请求结果,比如第一次爬某个页面要花十秒,第二次直接从缓存读取,眨眼功夫就完事了。
官方分享过一个真实案例,有个项目原本算下来要花1000多美金的费用,通过巧妙组合浏览器和缓存机制,最后只用了30美金。
这省下来的可都是真金白银啊,尤其当你需要反复调试或者定时跑任务的时候,效果特别明显。
爬取模式方面,Botasaurus提供了两种方法,分别是@browser和@request。
@browser模式会启动一个真实的、经过伪装的Chrome浏览器,最适合对付那些反爬特别严格或者需要执行复杂JavaScript的网站。
@request模式就轻量多了,发送模拟浏览器的HTTP请求,速度飞快,资源消耗也小,特别适合抓取传统的服务端渲染页面。
你在写项目的时候,完全可以根据目标网站的特点灵活选择,甚至混着用。这样一来,成功率有保障,效率也上去了。
Botasaurus还有一个很酷的能力,就是能把你的爬虫代码一键变成带界面的Web应用或者跨平台桌面软件。
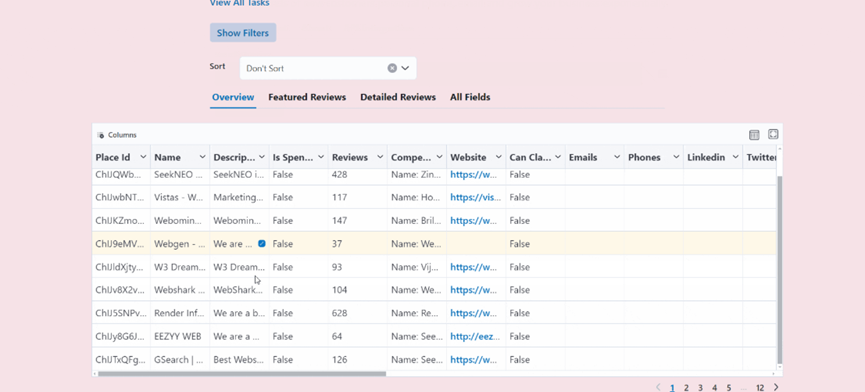
你只需要专注于写核心的爬取逻辑,然后用几行代码和简单的配置,就能生成一个漂亮的网页界面。非技术用户直接在里面输入关键词、点个按钮就能拿到数据。
甚至还可以把这个工具打包成Windows、Mac或者Linux上的独立应用,这样可以变成一个能交付给客户、甚至通过订阅制盈利的完整产品,价值一下子就上来了。
当然,这框架的能力远不止这些基础操作。例如,利用那个异步队列功能,你可以边滚动页面加载新内容,边在后台并发抓取每个详情页的数据,两者互不耽误。
这种高级玩法能帮你构建出效率极高的实时数据采集系统。
另外还有个sitemap解析功能,能帮你快速摸清大型网站的页面结构,不用手动一个一个找链接。
我觉得如果你想通过爬虫找一些数据进行研究或者整理什么的,经常遇到不顺、卡壳,可以试试这个框架。
企业、高校及渠道合作
请联系微信:FYLlaoshi




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏