很多数据分析 师写过无数个SELECT查询,但当被问到“如何新建一张表来固化中间数据”“创建视图和创建物理表有什么区别”“视图的优缺点分别是什么”时,却常常陷入支支吾吾的困境。其实,SELECT只是从表中“取”数据,而CREATE TABLE和CREATE VIEW才是主动“建”数据载体的能力 ——前者是“用数据”,后者是“造工具”。
” 引言:为什么“创建表或视图”是数据分析师的分水岭? 小林是刚进公司一年多的数据分析师,写复杂SQL是日常,颇受团队认可。在一次分析任务中,他发现业务系统导出的原始表中有大量重复订单、字段类型混乱、缺少日期索引,导致每次分析前都要重复做清洗和关联工作,效率大降。
技术主管建议:“你把清洗后的中间数据固化成一张表,下次直接用就行。”小林恍然:原来许多分析效率低下的根源,在于只会“取”不会“建”。而视图将复杂的查询逻辑封装为一张“虚拟表”,能极大简化上层取数。在CDA数据分析师的认证体系中,能否在实际工作中熟练创建和管理表与视图,正是“数据治理”和“商业洞察”能力的集中体现。
熟练掌握表和视图的创建,是CDA分析师从“被动取数人”走向“主动数据赋能”的必备技能。本文将聚焦于CDA一级大纲和实际工作中的核心要点,系统解析创建数据表和创建视图的本质差异、核心语法、实际应用与考试高频考点。
一、核心认知:表与视图的本质差异 对CDA分析师而言,表与视图并非“二选一”的工具,而是“分工不同、协同配合”的搭档。要高效使用两者,需先明确其本质差异。
1. 数据表(Table):数据的“实体容器” 数据表是数据库中用于物理存储数据 的实体结构。所有原始数据或经过处理的核心数据都以表的形式持久化存储。其核心特征是:
物理存储 :表的数据以文件形式存储在数据库服务器的磁盘中,占用实际存储空间独立存在 :表不依赖其他对象,可单独进行查询、插入、更新、删除(CRUD)操作数据可控 :分析师可通过INSERT插入新数据、UPDATE修改错误数据、DELETE清理冗余数据
对分析师而言,创建表的核心价值体现在三个方面:
规范数据结构 ,将杂乱的原始数据整理为符合分析需求的格式
分析师常用表类型包括:
中间表 :存储数据预处理后的中间结果,用于后续分析复用结果表 :存储最终分析结论,可直接用于可视化或业务汇报
2. 视图(View):数据的“虚拟窗口” 视图是基于一个或多个表的查询结果构建的虚拟表 ,本身不存储数据,仅保存查询逻辑。当分析师调用视图时,数据库会根据预设的查询逻辑,从原始数据表中实时提取数据并呈现。其核心特征是:
依赖基础表 :若基础表结构变更,视图可能失效,需同步调整数据只读性 :分析师可通过视图查询数据,但无法直接用INSERT/UPDATE/DELETE修改视图数据
分析师常用视图类型包括:
简化查询视图 :将复杂的多表关联、嵌套查询封装为视图数据筛选视图 :筛选特定业务场景的数据,聚焦目标分析范围权限控制视图 :隐藏敏感字段(如手机号、身份证号),保障数据安全
二、创建表(CREATE TABLE):从业务需求到数据实体 1. 创建表的完整语法 创建表的过程是设计其存储规则和业务结构。基本语法结构如下:
CREATE TABLE [IF NOT EXISTS ] 表名 (1 数据类型 [列级约束] [默认值],2 数据类型 [列级约束] [默认值],2. 数据类型与约束条件 在创建表时,需要为每个字段明确数据类型与约束条件。常见的约束类型包括:
约束类型
关键字
作用
主键约束 PRIMARY KEY
唯一标识表中的每一行,值非空且唯一
外键约束 FOREIGN KEY
维护表与表之间的数据一致性
唯一约束 UNIQUE
保证某列的值不会重复
非空约束 NOT NULL
强制某列不能为空
检查约束 CHECK
定义合法值范围或表达式
默认约束 DEFAULT
未显式赋值时提供默认值
3. 创建表的实战示例 假设某电商平台需要创建一张订单固化分析表,用于后续销售趋势计算:
CREATE TABLE order_analysis_base (VARCHAR (50 ) PRIMARY KEY , VARCHAR (50 ) NOT NULL , VARCHAR (50 ) DEFAULT '未知' , DECIMAL (10 ,2 ) NOT NULL , VARCHAR (20 ) CHECK (order_status IN ('已支付' ,'未支付' ,'已取消' )),TIMESTAMP NOT NULL ,VARCHAR (50 )4. 表结构的动态管理(ALTER / DROP) 在表创建后,可通过ALTER和DROP对表结构进行动态管理:
操作类型
语法示例
说明
修改表名 ALTER TABLE 旧表名 RENAME TO 新表名;确保下游依赖同步修改
新增字段 ALTER TABLE 表名 ADD 新字段名 数据类型;注意大批量表避免锁表
修改字段 ALTER TABLE 表名 MODIFY 字段名 新数据类型;确认原业务是否依赖旧类型
删除字段/表 ALTER TABLE 表名 DROP 字段名; / DROP TABLE 表名;操作不可逆,执行前做好备份
三、创建视图(CREATE VIEW):封装查询逻辑的“快捷窗口” 1. 创建视图的核心语法 视图的创建语法是将SELECT查询封装为可复用的虚拟表:
CREATE VIEW view_name AS SELECT column1, column2, ...FROM table_nameWHERE condition;视图的核心价值在于:
简化复杂查询 :将多表关联、条件筛选的复杂SQL封装为视图隐藏数据细节 :屏蔽无关字段和复杂关联逻辑,避免数据误操作确保数据一致性 :多人使用同一视图时,因查询逻辑固定可避免数据口径差异
2. 视图的优缺点(CDA高频考点) 视图的优点 :
简化复杂查询 :用户无需了解底层表结构,即可获取所需数据提高数据安全性 :通过视图隐藏敏感字段,实现权限控制逻辑数据独立性 :底层表结构变化时,可调整视图定义而不影响上层应用确保数据一致性 :固定查询逻辑,避免不同分析师口径差异
视图的缺点 :
性能损耗 :每次访问视图需动态执行查询,复杂视图可能影响性能
3. 创建视图的实战示例 假设某电商平台需要封装“用户消费画像”查询,方便分析师后续直接调用:
CREATE VIEW v_user_consumption AS SELECT SUM (o.order_amount) AS total_spent,COUNT (o.order_id) AS order_count,AVG (o.order_amount) AS avg_order_valueFROM users uINNER JOIN orders o ON u.user_id = o.user_idWHERE o.order_status = '已支付' GROUP BY u.user_id, u.user_name, u.city;创建成功后,分析师只需执行SELECT * FROM v_user_consumption WHERE city = '北京';即可获取北京地区的用户消费画像,无需重复编写多表关联和分组汇总的复杂SQL。
在CDA考试中,有一类典型考题是识别语句的功能:
create view v_t1 as select id,name from t1;
” 这个语句的功能是创建一个名为v_t1的视图 ,视图中包含t1表的id和name字段。视图是一个虚拟表 ,基于SQL查询的结果集,不是更新字段内容的操作 。这道题考察的是考生能否区分CREATE TABLE、CREATE VIEW与UPDATE等操作的不同功能。
四、表与视图的完整对比(CDA高频必考点)
对比维度
数据表(Table)
视图(View)
选择建议
数据存储 物理存储,占用磁盘空间
逻辑存储,仅保存查询语句
高频复用且数据稳定→表;实时性要求高→视图
数据独立性 独立存在,不依赖其他对象
依赖基础表,基础表变更可能导致失效
稳定结构→表;需动态适配→视图
数据操作 支持增删改查(CRUD)
数据只读,无法直接修改
需修改数据→表;仅查询→视图
查询效率 直接读取数据,效率高
每次访问需执行查询,效率依赖逻辑复杂度
大数据量分析→表;简单查询→视图
使用场景 中间数据固化、数据共享、二次加工
复杂查询简化、数据权限控制
长期分析项目→表;临时查询或复用查询→视图
五、实战演练:表与视图的协同使用 背景 某电商平台需要每日统计“各城市近30天已支付订单的GMV”,用于运营早报推送。
第一步:创建核心数据表(固化中间结果) 为避免每日反复跨业务订单表进行大规模连接,首先生成一张固化表作为中间存储:
CREATE TABLE daily_city_order (DATE NOT NULL ,VARCHAR (20 ) NOT NULL ,DECIMAL (12 ,2 ) NOT NULL ,KEY (stat_date, city_code)第二步:创建视图,封装业务逻辑 为了方便运营同学直接取数,创建一张视图封装核心业务口径:
CREATE VIEW v_city_gmv_30days AS SELECT SUM (total_gmv) AS gmv_last_30daysFROM daily_city_orderWHERE stat_date >= CURDATE () - INTERVAL 30 DAY GROUP BY city_code;第三步:分析师直接调用视图 后续运营早报系统直接查询视图即可稳定获取结果:
SELECT * FROM v_city_gmv_30days ORDER BY gmv_last_30days DESC ;
这就是一套完整的“创建表固化中间数据 → 创建视图封装业务逻辑 → 上层直接调用 ”的表与视图协同实战流程。
” 结尾 很多数据分析师能写复杂的SELECT和JOIN,但当被问到“为什么要建这张中间表”“视图是否可以随意修改里面的数据”“底层基表结构被改对视图有什么影响”时,往往答不上来。
会写SELECT是“用数据”,会建表和视图是“造工具”。 创建表是在为数据仓储打下坚实的地基;创建视图则是在地基上铺设高效取数的管道。只有掌握两者的创建与管理,才能让数据真正体系化、可管理化、可复用化,让分析师从“重复写长SQL”的低效困境中解放出来。
在2025年新考纲的背景下,CDA一级明确要求掌握创建表与视图的操作逻辑——这不仅是考试大纲的考核要求,更是每一位数据分析师在真实工作中将“数据资产”转化为“决策能力”的必备技能。
下一步行动 :
在你常用的数据库操作工具中,尝试建立一张包含主键和非空约束的简单表 基于多张业务表的复杂查询逻辑,创建一个视图,对比直接写多表JOIN的效率和代码维护成本 练习区分CREATE TABLE、CREATE VIEW与UPDATE等操作的不同功能定位
CREATE TABLE 和 CREATE VIEW 共同构成了数据分析师手中的“建设权”——构建稳健的数据骨架,封装可复用的分析逻辑,让数据真正成为资产。
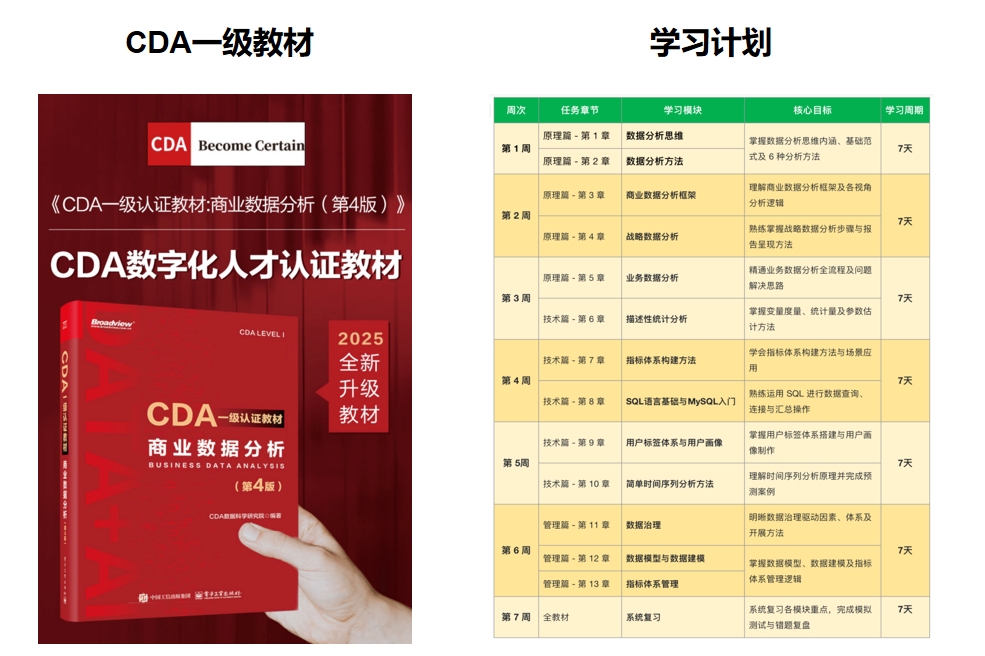
” 推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 



 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏