立即打开

一、数据简介
数据名称:中国大气重点控制区匹配结果数据。
时间范围:2010—2025年。
数据层级:城市(地区)—年度面板数据。
识别变量:地区与年份;所属省份用于辅助校验,行政区划代码为地区匹配辅助变量。
核心指标:大气重点控制区、长江经济带。
文件格式:Stata .dta、Excel .xlsx;计算代码、评估代码与本说明均为 UTF-8 编码,政策依据为 PDF 文件。
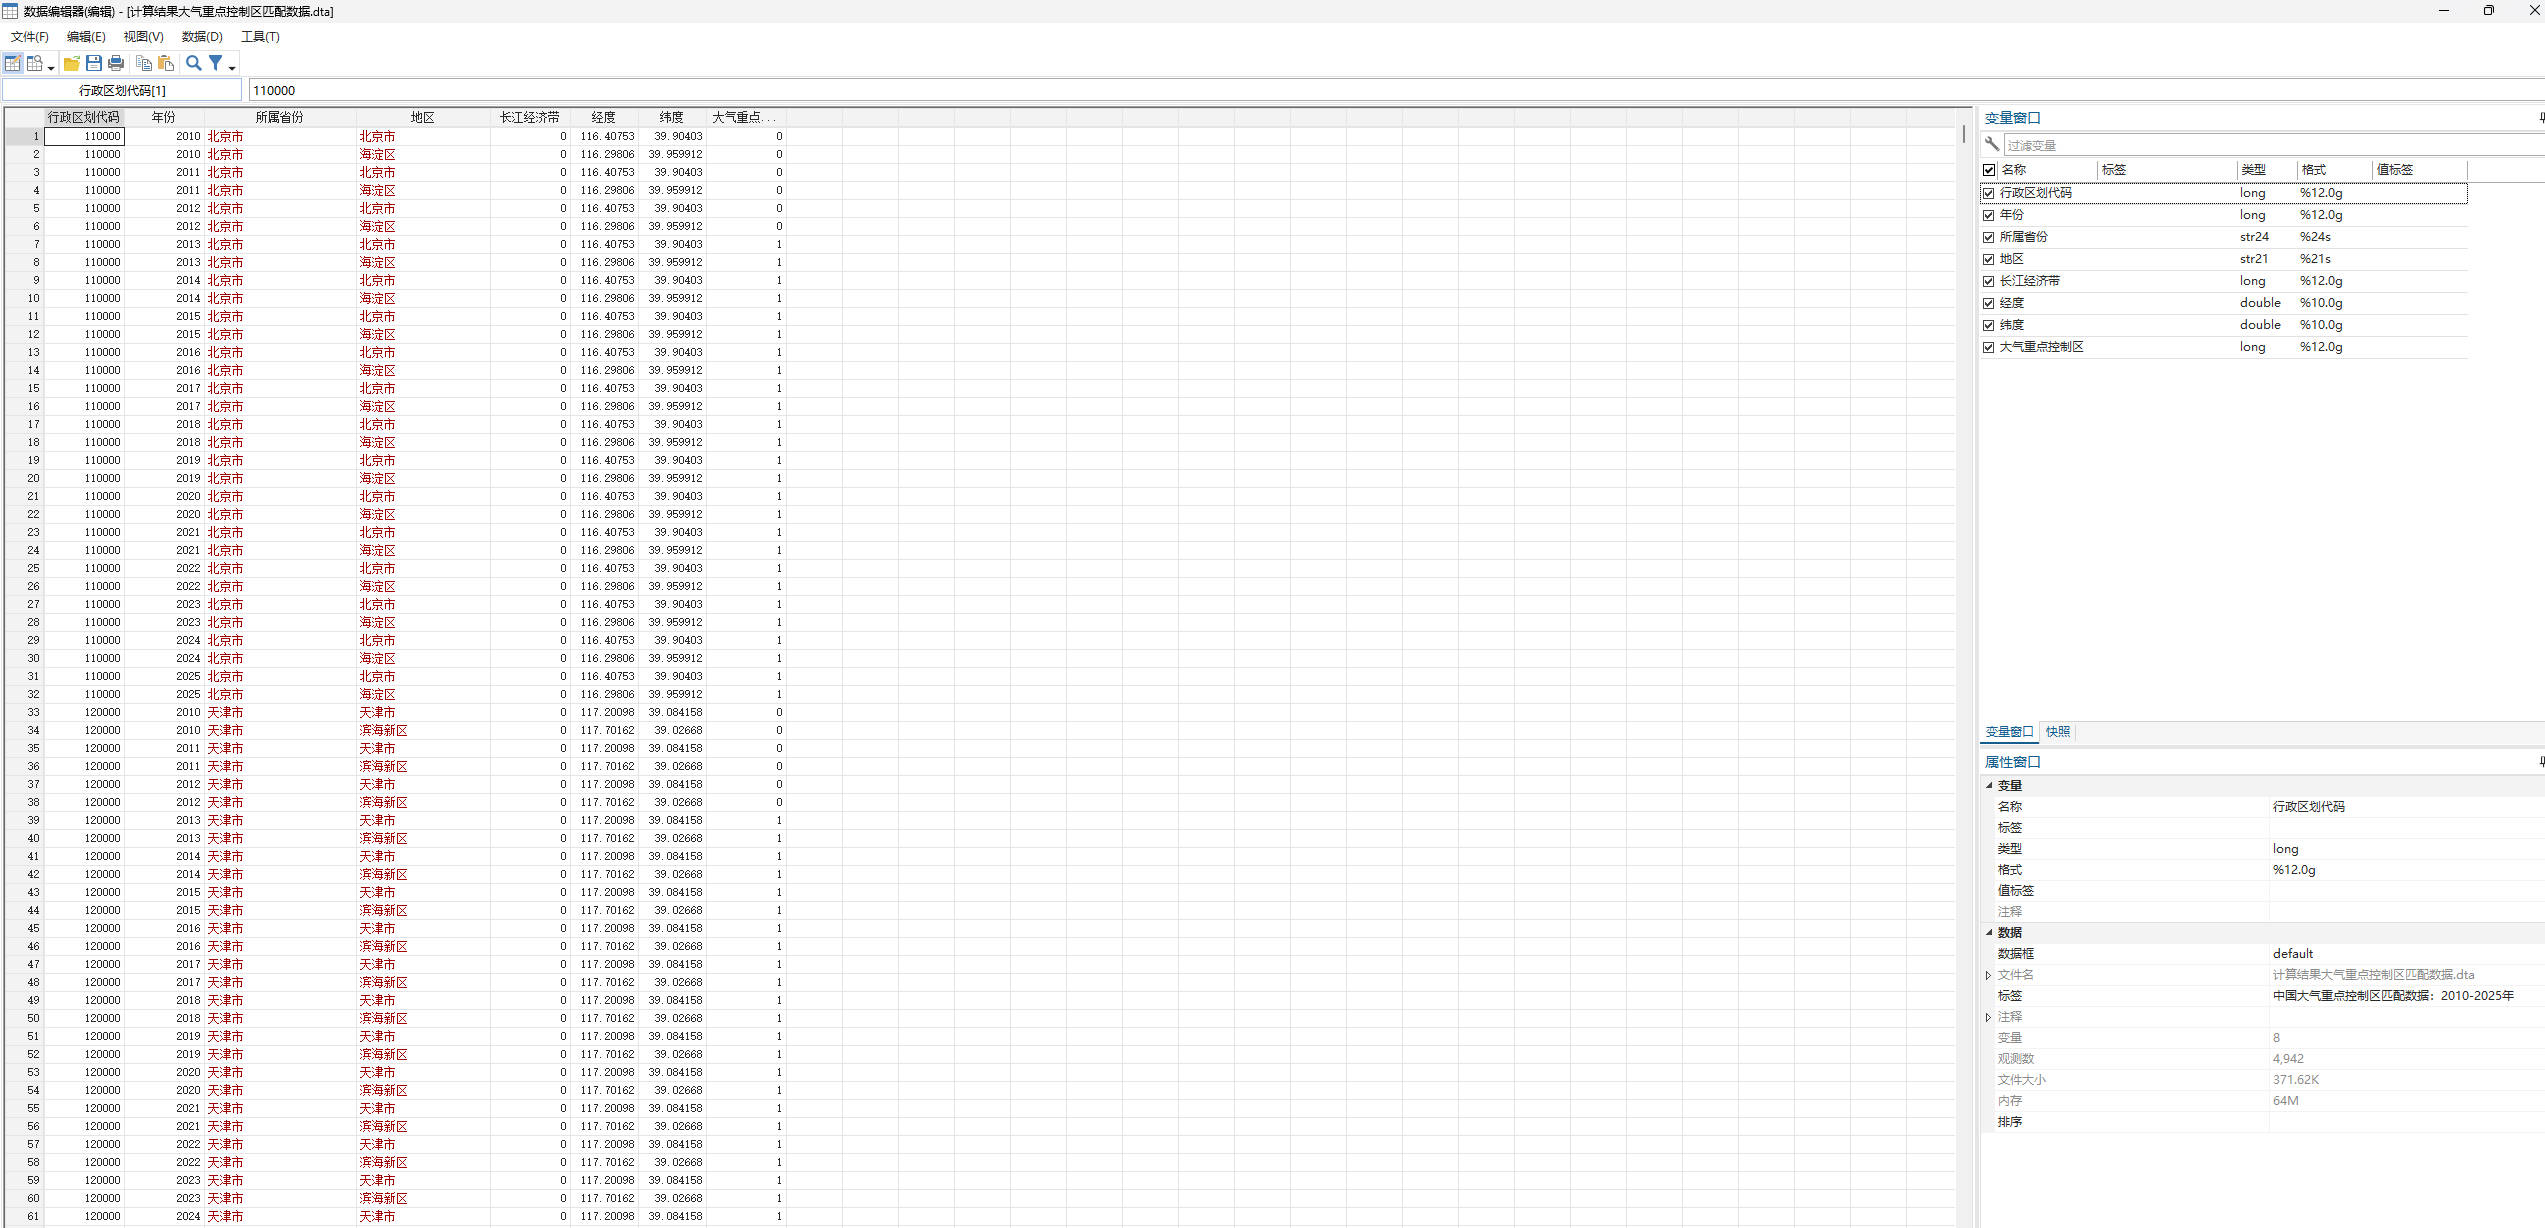
本数据依据生态环境部门和国务院公开发布的大气污染防治重点区域文件,将城市或地区逐年匹配为大气重点控制区或非重点控制区,并保留所属省份、行政区划代码、经纬度和长江经济带属性。结果覆盖2010—2025年,共4,942条地区—年度观测、8个字段,涉及309个地区名称和300个行政区划代码,可用于大气污染防治政策评估、环境规制研究、区域政策匹配、双重差分、空间计量以及上市公司注册地或经营地的城市层面匹配。

二、原始数据与政策依据
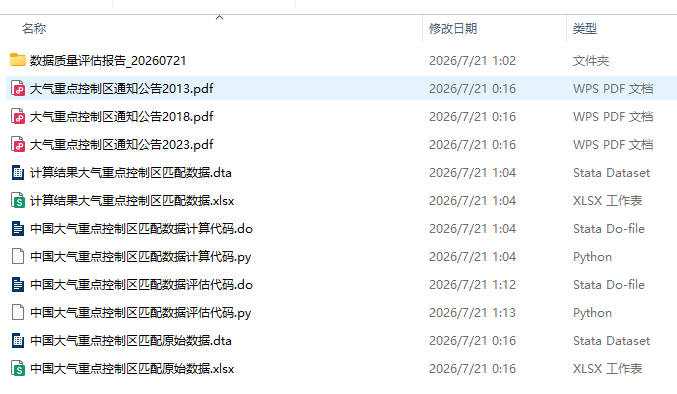
1. 中国大气重点控制区匹配原始数据.dta/.xlsx:共4,942条原始记录、8个字段,包含行政区划代码、年份、所属省份、地区、长江经济带、经度、纬度和大气重点控制区;DTA为计算代码的直接输入,XLSX用于人工查看和跨软件使用。
2. 大气重点控制区通知公告2013.pdf:用于核对2013年后重点控制区政策口径,重点区域通常概括为京津冀、长三角、珠三角等“三区十群”。
3. 大气重点控制区通知公告2018.pdf:用于核对《打赢蓝天保卫战三年行动计划》时期京津冀及周边地区、长三角地区和汾渭平原等重点区域范围。
4. 大气重点控制区通知公告2023.pdf:用于核对《空气质量持续改善行动计划》时期重点区域的调整口径。
三、核心指标计算说明
1. 大气重点控制区:二元虚拟变量,地区在对应年度属于数据采用的大气污染防治重点区域时取1,否则取0。变量按政策适用年度动态赋值,不能将单一年度的重点区域状态直接复制到全部年份。
2. 2010—2012年口径:保留原始数据中的年度匹配状态。2010年有2条重点控制区记录,2011年和2012年各有1条;该阶段不直接套用2013年后的“三区十群”范围。
3. 2013—2017年口径:主要依据2013年重点控制区相关公告进行匹配,本数据每年有49条地区记录的大气重点控制区取1。
4. 2018—2022年口径:主要依据《打赢蓝天保卫战三年行动计划》确定的重点区域进行匹配,本数据每年有84条地区记录的大气重点控制区取1。
5. 2023—2025年口径:主要依据《空气质量持续改善行动计划》等后续政策文件调整重点区域范围,本数据2023年有88条、2024年和2025年各有87条地区记录取1。
6. 长江经济带:二元区域属性变量,地区属于长江经济带覆盖范围时取1,否则取0。该变量可用于区域异质性、政策叠加效应或样本分组分析,但不参与大气重点控制区的判定。
7. 经度与纬度:地区中心点或代表性地理坐标,经度范围约为75.993936—131.159133,纬度范围约为16.831839—50.245329。坐标口径沿用原始数据,结果代码不重新地理编码,可用于地图展示、空间距离、邻接关系和空间权重矩阵构建。
8. 结果整理:Stata与Python计算代码均按“行政区划代码—年份”排序,并统一输出字段顺序为行政区划代码、年份、所属省份、地区、长江经济带、经度、纬度和大气重点控制区;由于代码不重新计算核心变量,整理前后关键变量观测数和均值保持不变。
四、结果数据文件与样本量
1. 计算结果大气重点控制区匹配数据.dta/.xlsx:保留原始4,942条地区—年度观测,不进行样本剔除或缩尾,共8个字段。2010—2023年每年309条记录,2024—2025年每年308条记录。
2. 大气重点控制区共有931条取1、4,011条取0,均值为0.18838526912181303;其中2013—2017年每年49条取1,2018—2022年每年84条取1,2023年88条取1,2024—2025年每年87条取1。
3. 长江经济带共有1,806条取1、3,136条取0,均值为0.3654390934844193。
4. 地区—年份无重复;行政区划代码—年份存在144条重复记录,原因是部分不同地区名称共用行政区划代码,不能在未核验地区名称的情况下按行政区划代码—年份强制去重。
结果DTA与XLSX均为4,942条数据记录、8个字段,内容和排序对应。项目只提供一套城市年度政策匹配结果,不适用上市公司项目的“未剔除金融ST未缩尾、剔除金融ST未缩尾、剔除金融ST缩尾”三版本处理,也不进行金融行业、ST/PT、退市公司筛选。
五、结果变量说明
1. 行政区划代码(int):地区行政区划匹配代码。部分不同地区名称可能共用同一代码,不能单独与年份组成唯一键。
2. 年份(int):政策匹配年度,范围为2010—2025年,共16个年度。
3. 所属省份(string):地区所属省级行政区名称,包括省、自治区或直辖市。
4. 地区(string):城市、直辖市辖区或其他地区名称;与年份组合后在本结果数据中唯一。
5. 长江经济带(int):长江经济带虚拟变量,属于长江经济带取1,否则取0。
6. 经度(double):地区中心点或代表性坐标的经度,数值越大表示位置越偏东。
7. 纬度(double):地区中心点或代表性坐标的纬度,数值越大表示位置越偏北。
8. 大气重点控制区(int):核心政策虚拟变量;对应年度属于大气污染防治重点区域取1,否则取0。

六、计算与评估代码
1. 中国大气重点控制区匹配数据计算代码.do:Stata 15+整理代码,读取原始DTA,统一变量顺序和标签,并输出DTA与XLSX结果。
2. 中国大气重点控制区匹配数据计算代码.py:与Stata版在数据读取、字段顺序、排序和结果命名上对等的Python脚本。
3. 中国大气重点控制区匹配数据评估代码.do:可独立运行的Stata数据质量评估代码,评估数值变量分布、缺失值、异常值和地区年度结构。
4. 中国大气重点控制区匹配数据评估代码.py:可独立运行的Python数据质量评估脚本,按运行日期创建评估报告目录并输出变量级总评估结论。
七、数据质量评估
评估程序读取计算结果DTA,自动识别地区和年份信息,区分数值变量与字符变量,并按运行日期创建“数据质量评估报告_YYYYMMDD”。报告含五个固定子文件夹:1 数据分布分析、2 分布图、3 异常值检验、4 逻辑合理性验证、5 稳健性测试。本次Python实跑报告为“数据质量评估报告_20260721”,总评估结论表位于报告根目录。
主要评估内容包括数值变量描述性统计、字符变量频数、直方图和核密度分布、Z-score与IQR异常值、缺失率、地区—年度重复、年度连续性以及二元指标取值范围。项目专属逻辑检验包括:大气重点控制区和长江经济带应仅取0或1,经度和纬度应处于合理地理范围,地区—年份应保持唯一,并重点提示行政区划代码—年份并非唯一键。
八、政策文件
1. 原环境保护部. 关于执行大气污染物特别排放限值的公告,2013年。
2. 国务院. 打赢蓝天保卫战三年行动计划,2018年。
3. 国务院. 空气质量持续改善行动计划,2023年。
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
栏目导航
热门文章
推荐文章
 扫码加好友,拉您进群



 全部版块
 我的主页


 收藏