附件内所有文件均包括xlsx、dta格式面板数据,无偿赠送您非常详细的参考文献原文(C刊高被引文献!!)、变量说明文件、非常详细的Stata指标测算全过程参考代码(真正实现数据真实且可复现,参考价值较高!)、非常详细的原始数据(包括上市公司基本信息(证券代码、证券简称、行业代码、所属省份城市等)、全国供应链创新与应用试点企业/城市名单(商务部 2018 年商贸函 165 号)、地级市基本信息(省份名称、城市名称、城市代码、所属区域等)等 DID 双重差分指标构建所需的全部原始字段,完整原始数据体量较大,指标来源有依据,充分保证数据真实性、准确性,绝对不同于市面上其他粗制滥造数据!!)以及2025 更新版本上市公司年度信息!!本数据集适用于所有涉及供应链创新与应用试点、供应链数字化、企业绩效、产业升级、城市经济等方向的实证研究与理论分析,更是非常适合在此基础上进行拓展研究,能够帮助大家高效上手,完成科研任务!
此外,本数据集已为您匹配完成2000-2025上市公司常用财务指标面板数据,包括行业名称、行业代码、注册具体地址、公司办公地址、统一社会信用代码、重大变更、办公地经度、办公地纬度、公司成立日期、注册资本、公司网址、经营范围、注册地经度、注册地纬度、首次上市日期、所属省份代码、所属省份、所属城市代码、所属城市、主营业务、上市状态、总资产、应收账款、存货、股东权益合计、主营业务收入、销售费用、应付普通股股利、经营活动产生的现金流量净额、资产负债率、营业毛利率、资产收益率、边际利润率、净资产收益率、每股收益、每股净资产、资本支出、实际税率、特殊项目利润、员工数目等60+关键变量,可与上市公司面板数据匹配用于回归,累计涵盖6.6w+观测值数量,约 5,600+样本企业!
本数据集来源正规,由我手动收集、整理,与同门多次核对,观测值数量全面。市面上的供应链创新与应用试点DID数据,大多仅以单一企业层名单粗糙匹配,缺乏规范的多层面(上市公司+地级市)双重差分结构,或仅覆盖较短年份、样本量有限,测算方法不透明、不可复现,更新到2025年,严格按照商务部 2018 年商贸函〔2018〕165 号文公布的全国供应链创新与应用试点城市和企业名单构建标准 DID 双重差分政策变量,分别覆盖 81 家试点企业(2000-2025 共 26 年,1,530 个公司-年度观测)与 55 个试点城市(2000-2025 共 26 年,1,274 个城市-年度观测),附完整 Stata 参考代码与样本原始数据,观测值无误差,亲测效果良好,不含拟合处理,均为基于原始上市公司基本信息与地级市基本信息的规范 DID 测算结果!
附件内容简介: 1、2000-2025年上市公司+地级市国家供应链创新与应用试点DID数据:基于商务部 2018 年公布的全国供应链创新与应用试点城市和企业名单(商贸函〔2018〕165 号),按 DID 双重差分方法学框架构建标准政策虚拟变量。首先对处理组虚拟变量 Treat 进行识别:上市公司层面,证券代码(stkcd)属于试点企业名单的取 1,否则取 0;地级市层面,所属城市代码属于试点城市名单的取 1,否则取 0。其次构建时点虚拟变量 Post = 1{年份 ≥ 2018}(以商务部 2018 年商贸函 165 号为政策冲击起点,全国统一时点)。最后生成交互项 DID = Treat × Post,直接捕捉政策对处理组在政策冲击后的净效应。核心变量包括:Treat(处理组虚拟变量)、Post(政策时点虚拟变量,2018年及之后取 1)、DID(Treat × Post 交互项,标准双重差分核心变量)以及公司-年度/城市-年度基础信息变量(证券代码、证券简称、行业代码D、所属省份/城市/省份名称/城市名称/所属城市代码/区域等)。上市公司层累计 7.4w+ 公司-年度观测,地级市层累计 9,204 城市-年度观测,横跨 2000-2025 年共 26 个年份,已整理好的双层面面板数据可直接用于 DID 回归分析,极具研究价值!
附件内包括非常详细的 Stata 指标测算参考代码、所有原始数据文件、参考文献原文、变量说明文件,可逐一核验准确性,大家可放心数据质量!
指标测度方法:参照商务部 2018 年商贸函〔2018〕165 号文与刘海建、胡化广、张树山等(2023)、张树山、胡化广、孙磊等(2021)的 DID 双重差分标准方法学框架,标准 DID 政策虚拟变量的测算分为以下两步:
第一,处理组虚拟变量 Treat 识别。对每个观测单元(公司 i 或城市 c)是否在商务部 2018 年公布的全国供应链创新与应用试点企业/城市名单上进行判定。在名单上取 1(处理组),不在名单上取 0(对照组)。上市公司层面按 stkcd 唯一识别,地级市层面按所属城市代码唯一识别。
(1)上市公司层处理组识别(按试点企业名单):
(2)地级市层处理组识别(按试点城市名单):
(3)政策时点虚拟变量 Post 识别:
第二,标准 DID 交互项测算。在第一阶段构建的处理组虚拟变量基础上,与政策冲击时点指示变量(年份 t ≥ 2018)交互,生成标准 DID 交互项 DID = Treat × Post,反映处理组在政策冲击后的净政策效应。
(4)标准 DID 双重差分交互项:
其中 Treat 为处理组虚拟变量(公司 i 或城市 c 属于试点企业/城市名单取 1,否则取 0),Post 为政策时点虚拟变量(年份 t ≥ 2018 取 1,否则取 0)。DID 取值 0/1,反映处理组在 2018 年政策冲击后的净政策效应。可直接用于 DID 回归分析。
(5)DID 回归设定(双向固定效应):
其中 Y 为因变量(公司层为企业绩效/TFP/数字化转型等,城市层为 GDP/产业结构等),β 为 DID 政策效应系数(核心估计量),X 为控制变量向量,μ_i 与 λ_t 分别为公司与年度固定效应(或城市与年度固定效应),ε 为随机扰动项。β 显著为正(负)即为政策对处理组的净正向(负向)效应。
2、2000-2025年国家供应链创新与应用试点DID数据原始数据:源于权威数据库与商务部公开文件,涵盖沪深A股上市公司基本信息(证券代码、证券简称、行业代码、所属省份/城市)、全国供应链创新与应用试点企业/城市名单(商务部 2018 年商贸函 165 号文)、地级市基本信息(省份名称、城市名称、城市代码、所属区域)等 DID 双重差分政策变量构建所需全部原始变量。样本数据涵盖指标构建所需的全部字段结构,可用于复现完整的 DID 测算流程,指标构建所需的各个变量都可直接查到,指标来源有依据,充分保证数据真实性、准确性!


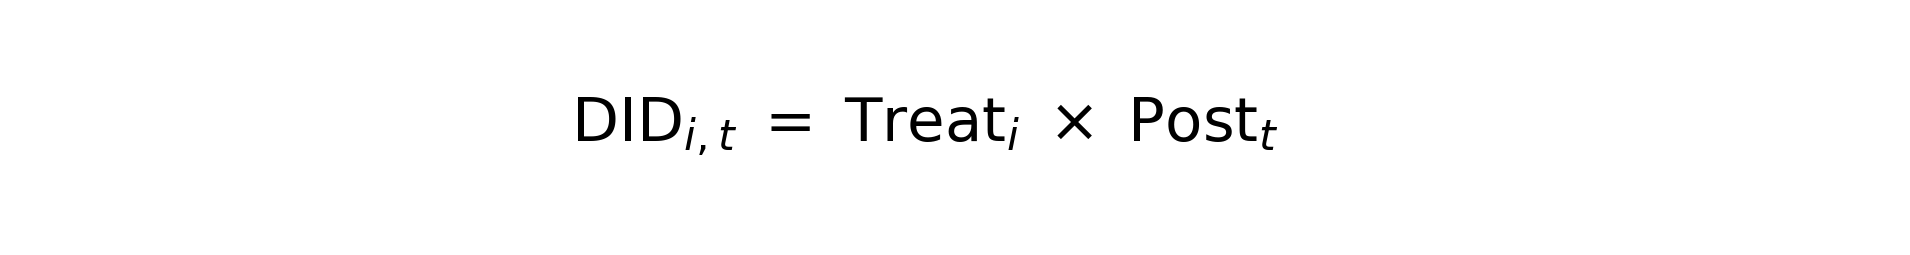
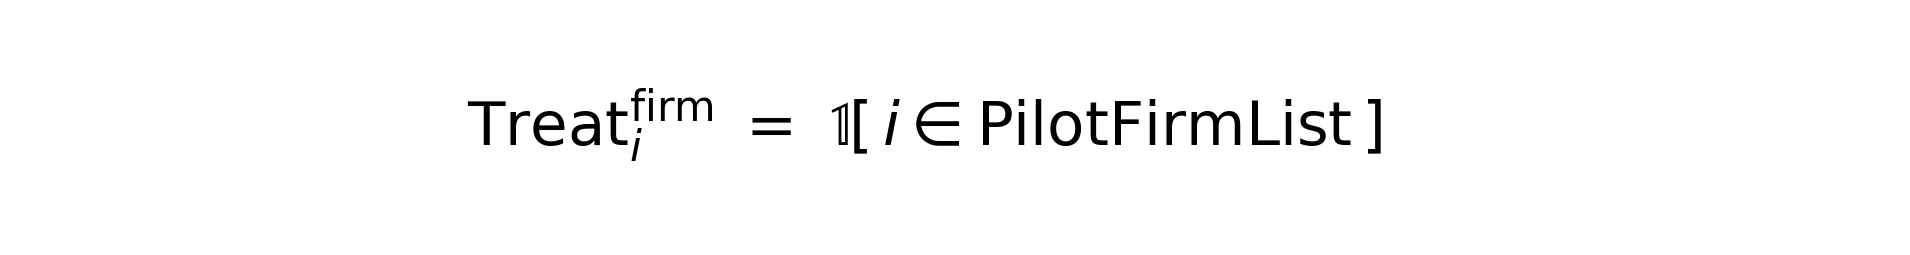

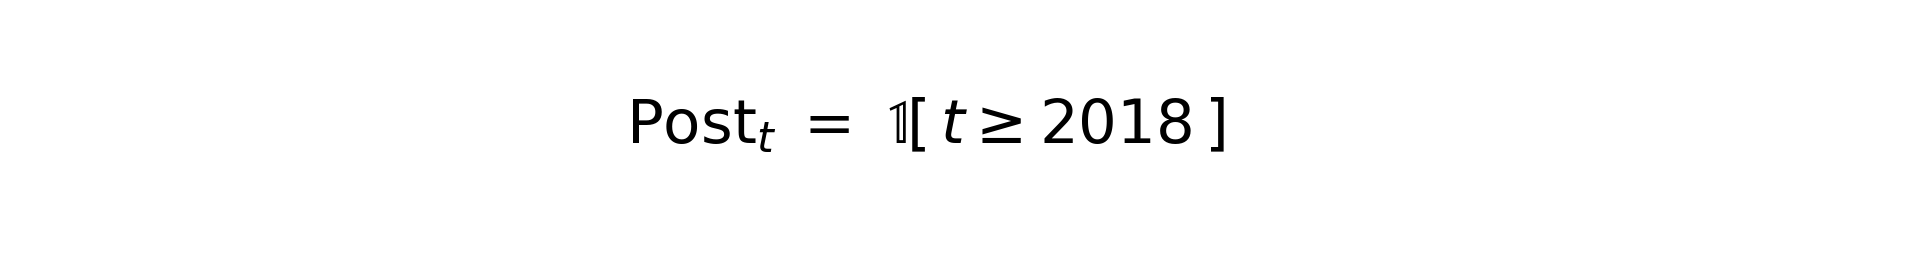
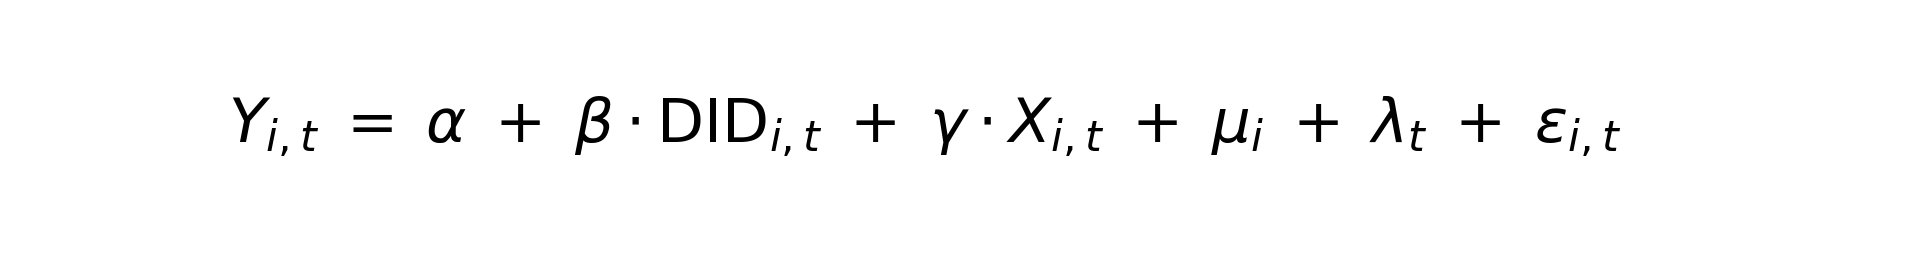


 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏