立即打开
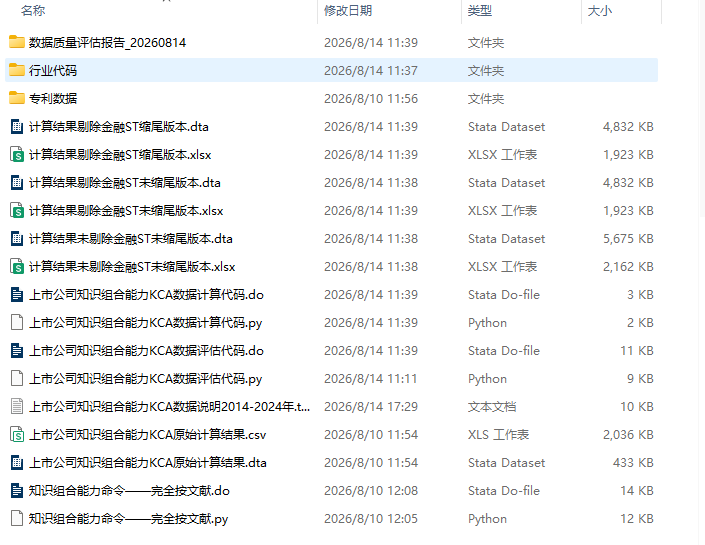
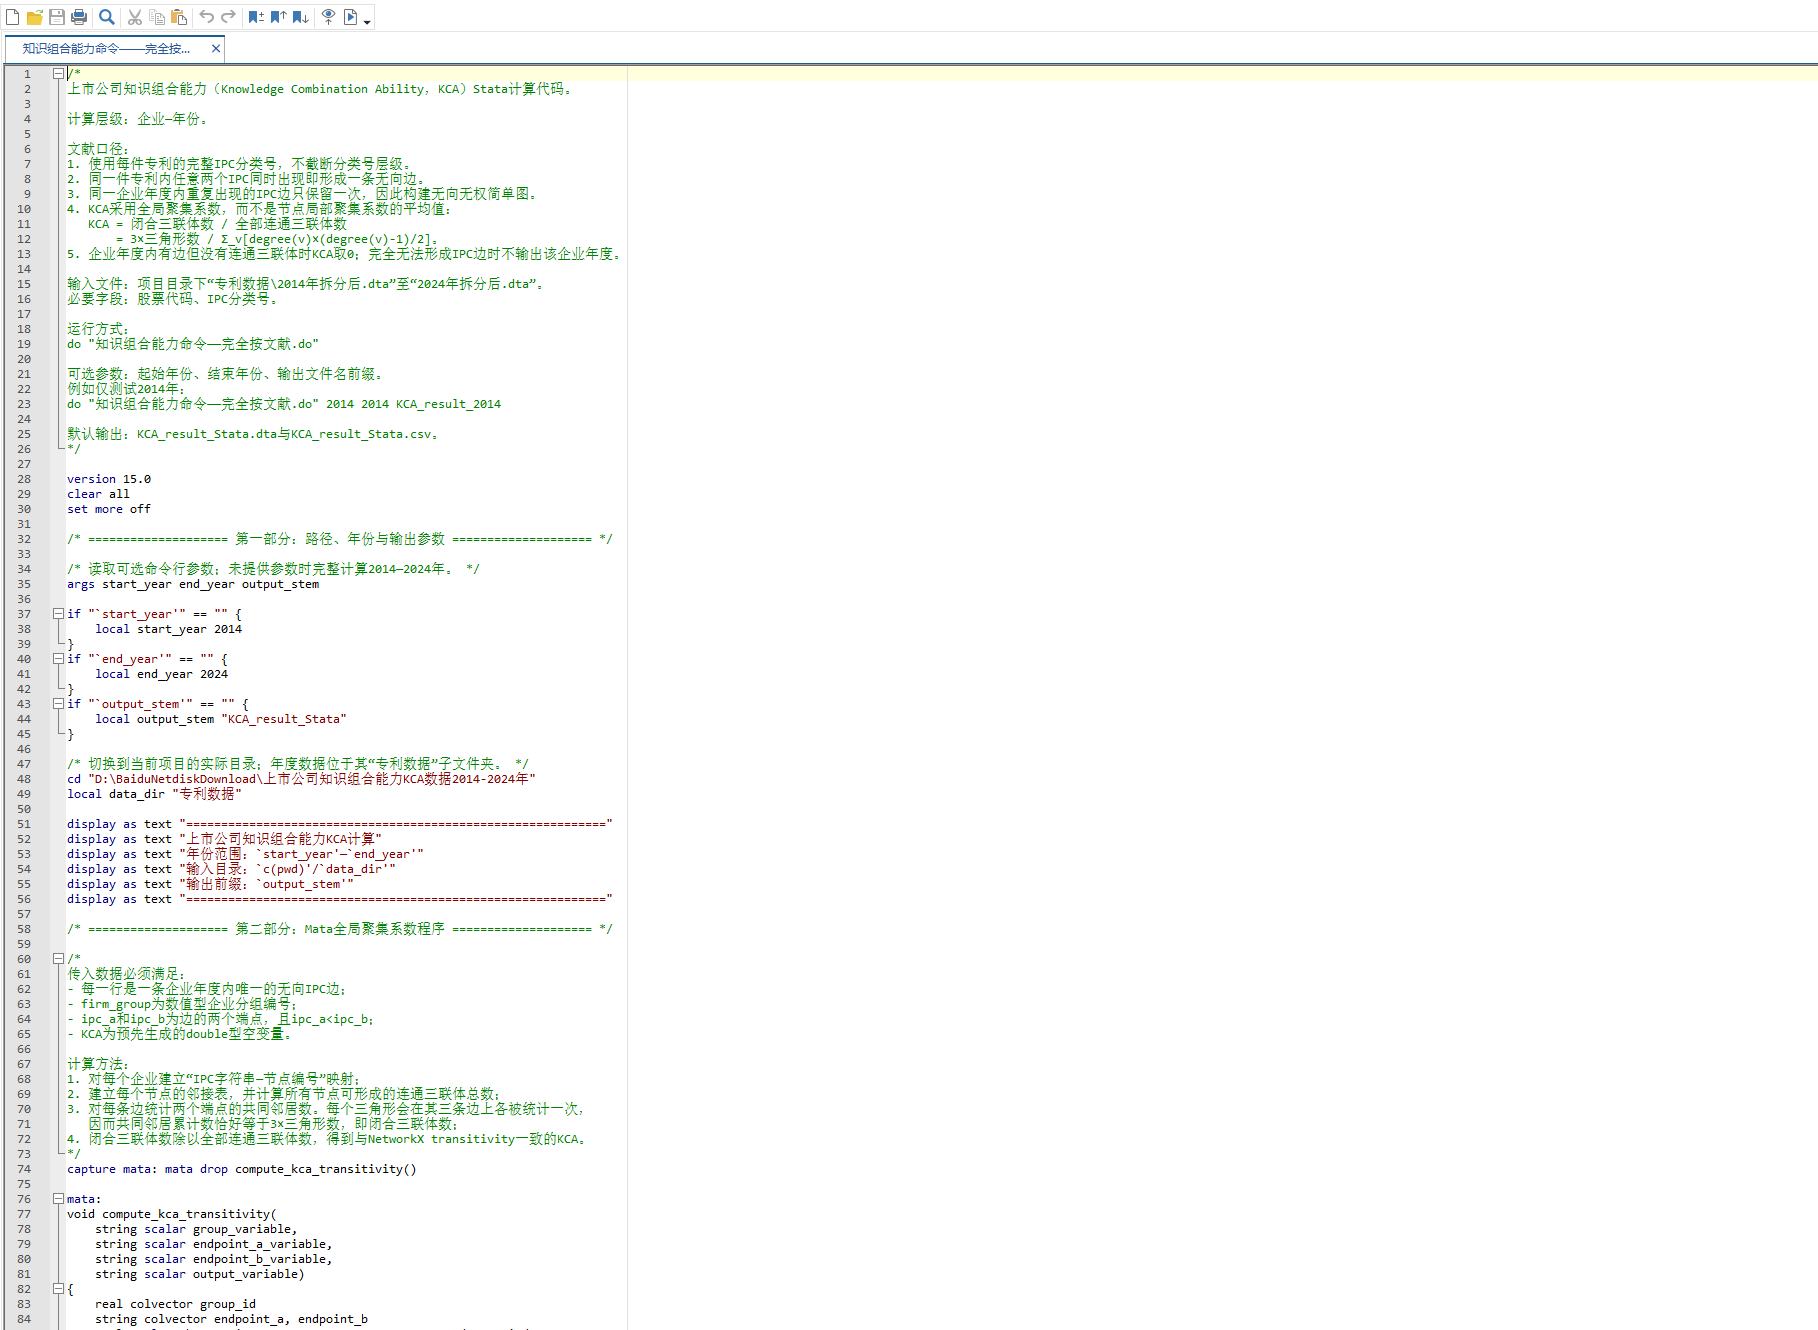
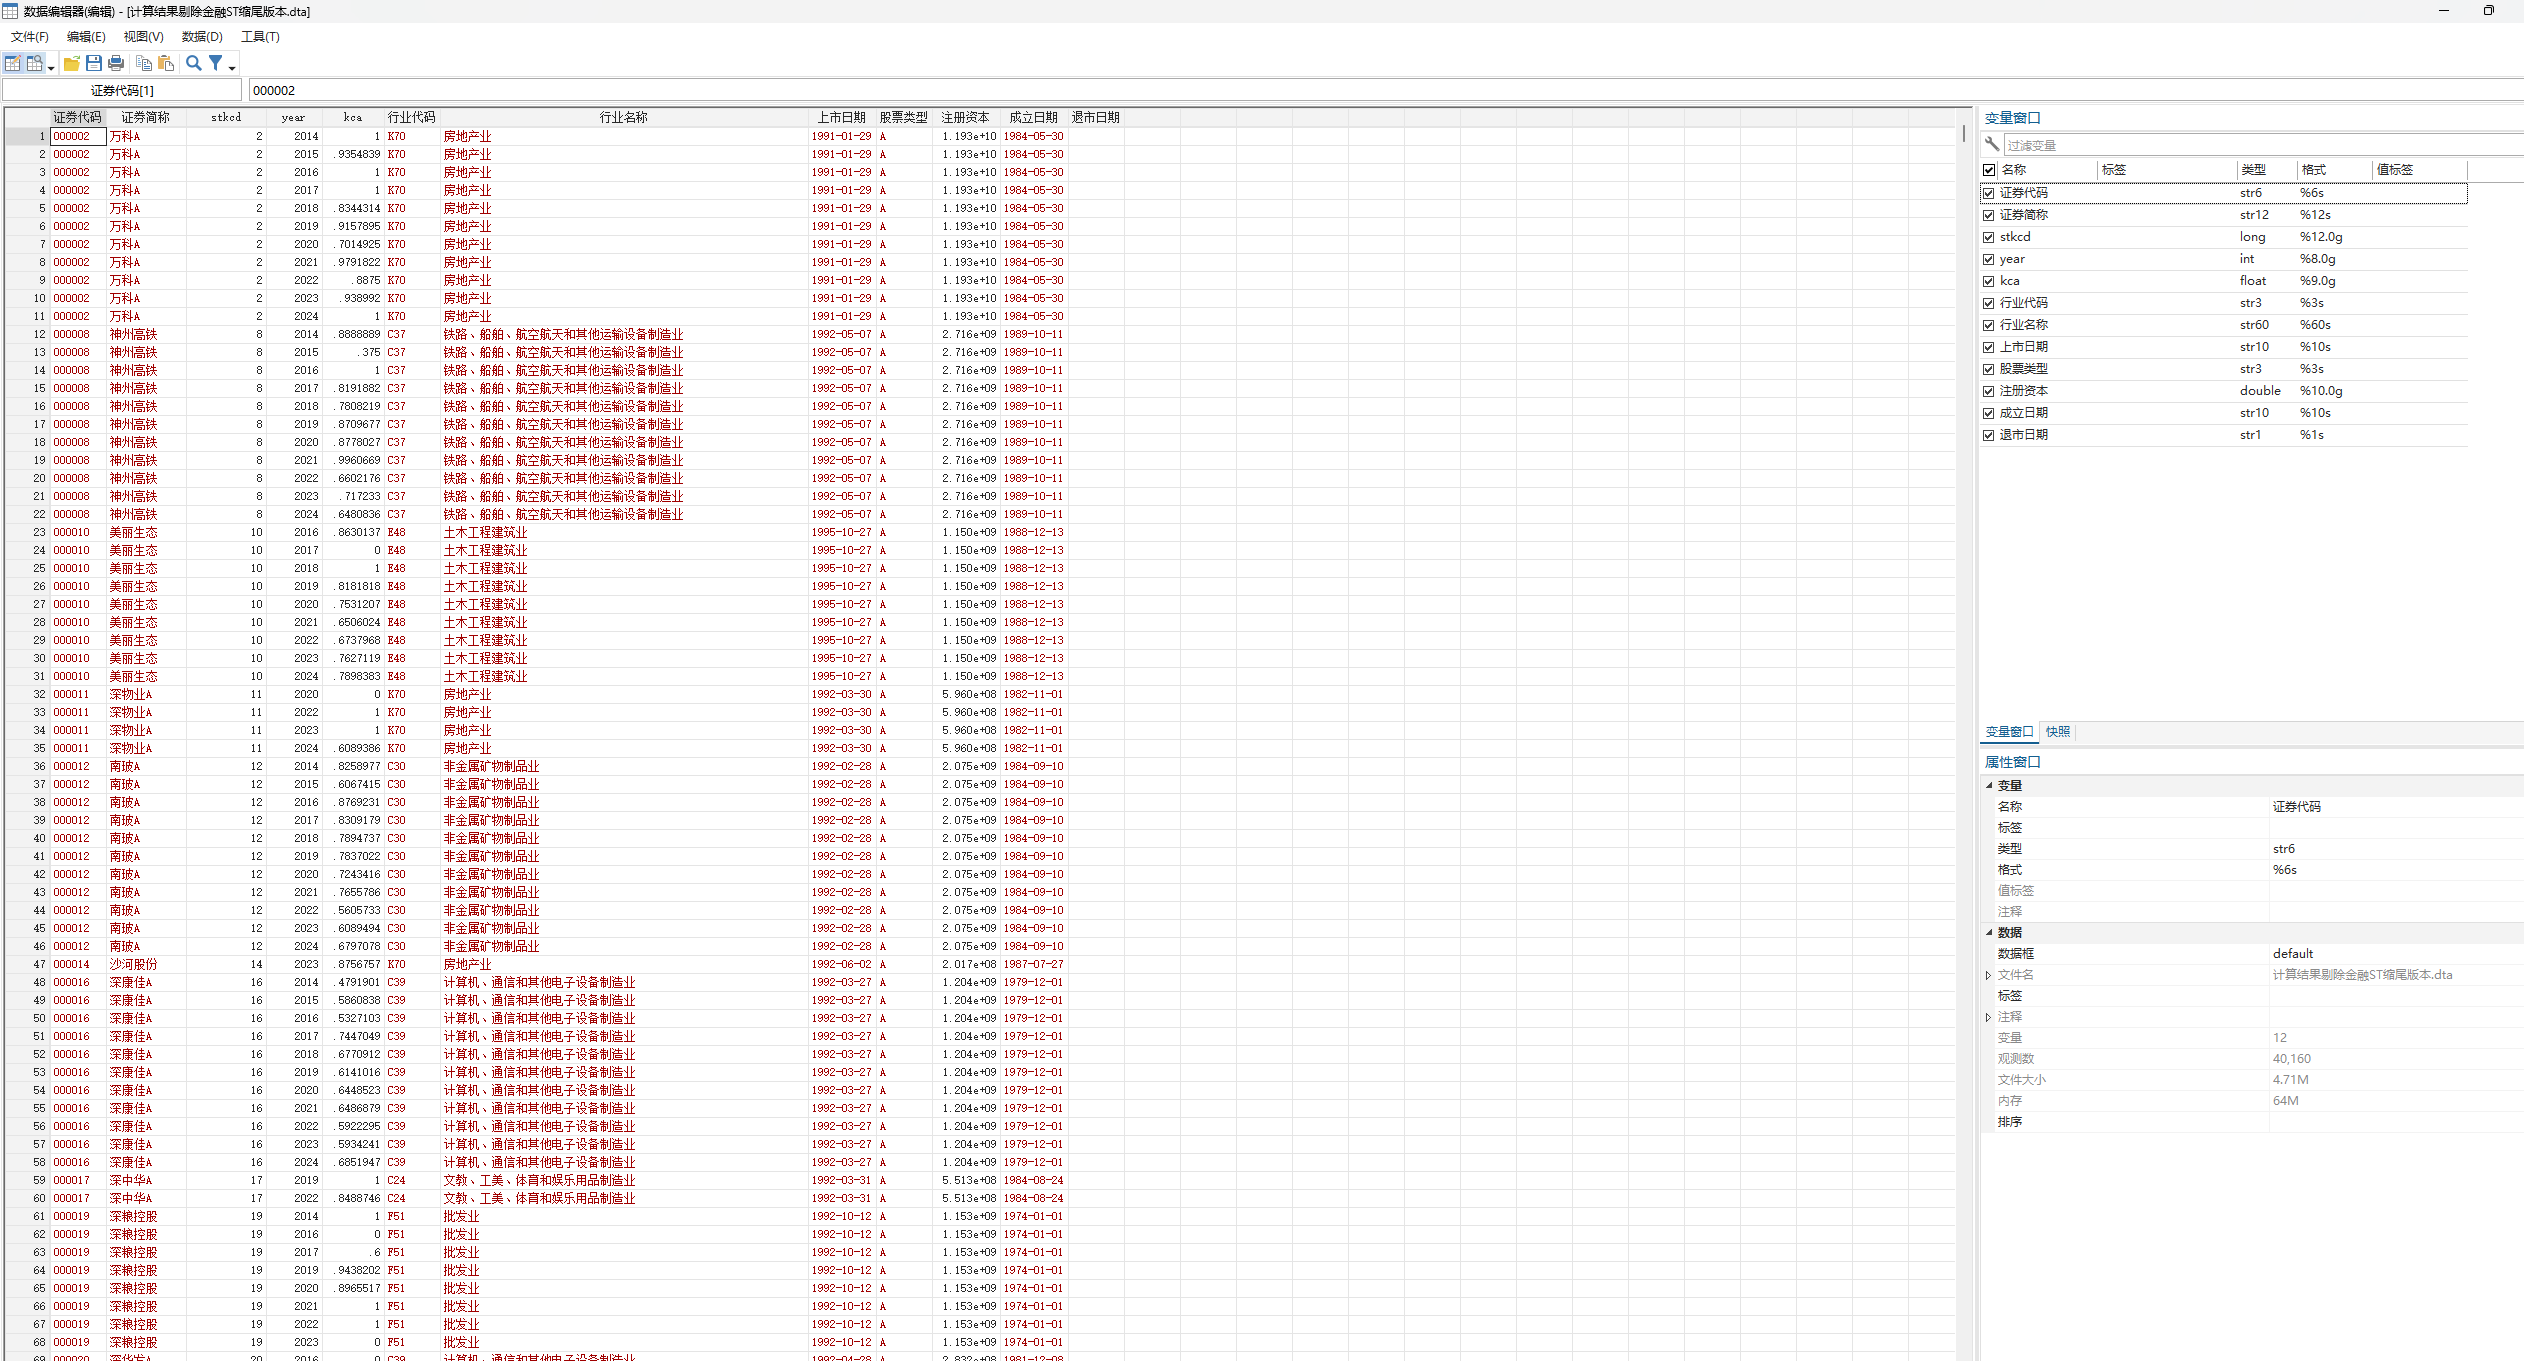
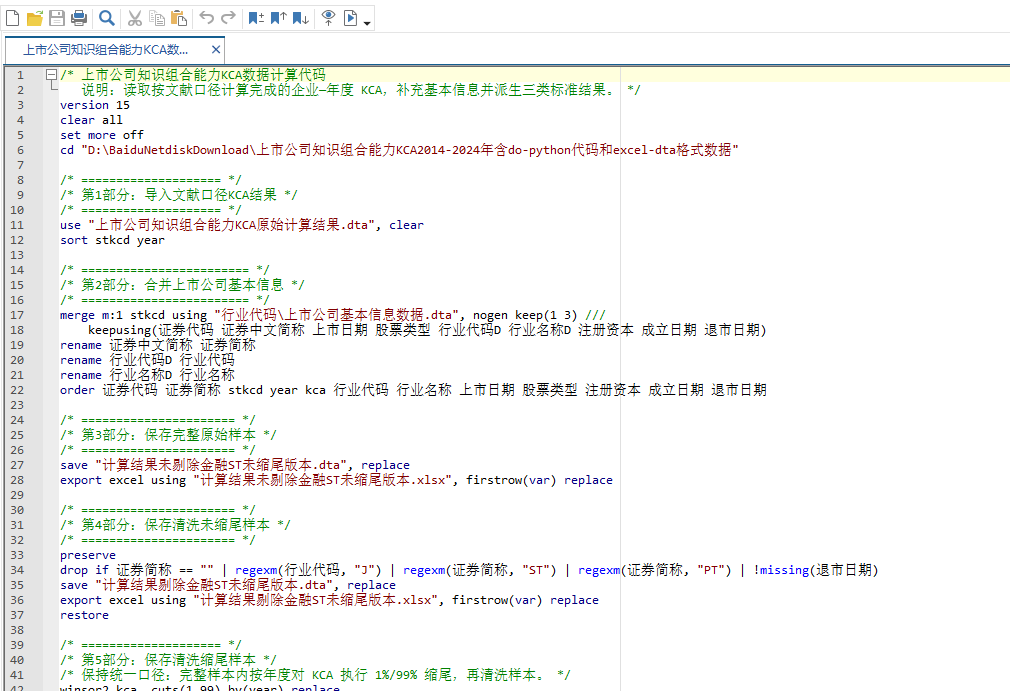
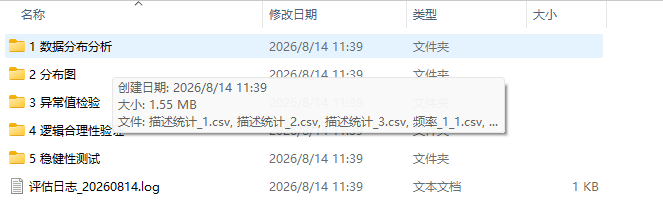
一、数据简介 数据名称:上市公司知识组合能力(Knowledge Combination Ability,KCA)数据 时间范围:2014—2024年 数据层级:上市公司—年度面板数据 核心指标:kca(知识组合能力)、IPC分类号、股票代码 识别变量:stkcd(公司识别变量)、year(专利申请年份);专利原始数据以股票代码、申请年份识别 文件格式:Stata .dta、Excel .xlsx、CSV .csv;计算代码提供Stata .do与Python .py版本 二、原始数据与基本信息合并 专利数据\2014年拆分后.dta至专利数据\2024年拆分后.dta:11个年度的上市公司关联专利明细,是KCA的直接输入数据;各文件有9—13个字段,合计2,447,822条记录,主要字段为 股票代码、IPC分类号、申请年份、专利申请号、专利公开号、申请日期、关联股票代码、专利状态、专利类型和IPC主分类号。计算时仅使用股票代码和IPC分类号;股票代码用于识别企业,IPC分类号用于构建知识共现边。 上市公司知识组合能力KCA原始计算结果.dta:专利数据计算得到的企业—年度中间结果,共43,958条观测,主要字段为 stkcd、year、kca;是标准结果派生代码的直接输入文件。 上市公司知识组合能力KCA原始计算结果.csv:与上述DTA中间结果对应的CSV查看版本,主要字段为 stkcd、year、kca。 行业代码\上市公司基本信息数据.dta:上市公司静态基本信息,共5,718家企业,stkcd无重复;主要字段为 证券代码、证券中文简称、上市日期、股票类型、行业代码D、行业名称D、注册资本、成立日期、退市日期、stkcd。 合并规则:以stkcd为公司级键进行m:1合并,不按年份匹配;保留KCA结果中的全部观测,并补充证券代码、证券简称、上市状态、行业分类及注册登记信息。完整样本中有176条观测未匹配到基本信息,相关字符字段为空、注册资本缺失;清洗版本因证券简称为空而不保留这些观测。 三、计算说明 【kca】知识组合能力,以企业在某一年度的IPC共现网络全局聚集系数衡量。对每件专利保留完整IPC分类号,将中文逗号统一为英文逗号后拆分;同一专利内任意两个不同IPC形成一条无向边,同一企业同一年度的重复IPC边仅保留一次,从而得到无向无权简单图。计算公式为 KCA = 闭合三联体数 / 全部连通三联体数 = 3×三角形数 / Σv[d(v)×(d(v)-1)/2],其中d(v)为节点v的度数。kca取值位于[0,1];数值越大表示企业年度内不同知识要素之间越容易形成闭合的组合关系,知识组合结构越紧密;企业年度存在IPC共现边但不存在连通三联体时取0,完全无法形成有效IPC共现边的企业—年度不生成观测。 【股票代码】原始专利记录中的企业代码。计算前去除缺失或空白代码,并以字符方式处理以保留前导零;计算结果中转换为与基本信息表对应的数值型stkcd。 【IPC分类号】国际专利分类号。计算时不截断至部、大类、小类或主组层级;同一专利内的重复IPC先去重,少于两个有效IPC的专利不形成共现边。 【year】结果中的专利申请年份,范围为2014—2024年。 【行业代码、行业名称】由上市公司基本信息数据提供的证监会行业门类D代码及名称;行业代码以J开头的金融业观测在“剔除金融ST”版本中被剔除。 四、结果数据文件 共有3套结果数据文件(每套同时保存.dta与.xlsx,共6个文件)。样本筛选步骤如下: (1) 在专利层面删除股票代码缺失或空白的记录,拆分并清理完整IPC分类号;仅保留能够形成至少一条有效IPC共现边的企业—年度,并计算kca; (2) 以stkcd将KCA中间结果与上市公司基本信息数据进行m:1合并,补充证券代码、证券简称、股票类型、行业、注册资本、成立日期和退市日期; (3) 清洗版本删除证券简称为空、行业代码以J开头的金融行业、证券简称包含ST或PT、以及退市日期非空的观测;缩尾代码先在完整样本内按year对kca实施1%和99%分位数缩尾,再执行相同清洗。 编号 文件名称 说明 1 计算结果未剔除金融ST未缩尾版本.dta/.xlsx 保留金融行业、ST/PT和退市公司且不缩尾的完整基础样本,43,958条观测、5,377家企业。 2 计算结果剔除金融ST未缩尾版本.dta/.xlsx 剔除金融行业、ST/PT、退市公司及证券简称缺失观测但不缩尾的清洗样本,40,160条观测、4,853家企业。 3 计算结果剔除金融ST缩尾版本.dta/.xlsx 按代码在完整样本内按年度对kca执行1%/99%缩尾后再清洗;实际与第2套样本的观测和kca数值一致,均为40,160条观测、4,853家企业。 五、变量说明 序号 变量名称 变量类型 变量说明 1 证券代码 str 上市公司证券代码,字符型保存以保留前导零。 2 证券简称 str 上市公司中文证券简称,来自基本信息数据。 3 stkcd int 上市公司数值型公司代码;与year共同构成结果数据的公司—年度识别键。 4 year int 专利申请年份,范围为2014—2024年。 5 kca float 知识组合能力,即IPC共现网络全局聚集系数;取值越大代表知识组合闭合程度越高。 6 行业代码 str 证监会行业门类D代码;以J开头表示金融业,并在清洗版本中剔除。 7 行业名称 str 与行业代码对应的证监会行业门类D名称。 8 上市日期 str 公司上市日期,来自基本信息数据。 9 股票类型 str 公司股票类型,来自基本信息数据。 10 注册资本 float 公司注册资本,来自基本信息数据;单位以源文件口径为准。 11 成立日期 str 公司成立日期,来自基本信息数据。 12 退市日期 str 公司退市日期;非空观测在“剔除金融ST”版本中被剔除。 六、代码文件 文件名称 语言 说明 知识组合能力命令——完全按文献.py Python 读取各年度专利DTA,清理完整IPC分类号,构建企业—年度无向无权IPC共现网络,并使用NetworkX全局聚集系数计算KCA,默认输出KCA_result.csv。 知识组合能力命令——完全按文献.do Stata 以Stata/Mata实现与Python版等价的IPC边构建和全局聚集系数计算,可按年份参数运行并输出KCA结果。 上市公司知识组合能力KCA数据计算代码.py Python 读取KCA原始计算结果,合并基本信息,并生成三套标准结果的DTA和Excel文件。 上市公司知识组合能力KCA数据计算代码.do Stata 执行与Python版对应的基本信息合并、样本筛选、年度1%/99%缩尾及三套结果导出。 上市公司知识组合能力KCA数据评估代码.py Python 对结果DTA执行分布、异常值、逻辑合理性和稳健性检验,并输出评估报告、图片、CSV表和运行日志。 上市公司知识组合能力KCA数据评估代码.do Stata 对结果DTA执行与Python版功能对应的数据质量评估并输出结果。 七、数据质量评估 评估结果存放于 数据质量评估报告_20260814 文件夹,运行日志为 评估日志_20260814.log。该报告按三套结果数据分别运行,日志记录运行环境、输入文件和评估过程;各子文件夹内容如下: 子文件夹名 内容说明 1 数据分布分析 各套结果的描述性统计表和变量频率分布CSV文件。 2 分布图 未剔除金融ST未缩尾版本的直方图、箱线图、核密度图、散点图矩阵和时间趋势图等JPG图形。 3 异常值检验 基于IQR法、Z-score法及缺失值统计形成的异常值检验CSV文件。 4 逻辑合理性验证 公司—年度时间连续性、重复和取值范围等逻辑核验结果。 5 稳健性测试 不同处理方式与不同样本期对比,以及总评估结论CSV文件。 总评估结论_20260814.csv 按数据版本和变量汇总缺失、异常值、范围及一致性检验结论。 八、参考文献 [1] Watts D J, Strogatz S H. Collective dynamics of ‘small-world’ networks[J]. Nature, 1998, 393(6684): 440-442. [2] Newman M E J. The structure and function of complex networks[J]. SIAM Review, 2003, 45(2): 167-256.
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
相关推荐
栏目导航
热门文章
推荐文章




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏