立即打开

一、数据简介
数据名称:上市公司高管超额在职消费数据
时间范围:原始数据为2006—2025年;结果数据因使用滞后资产,实际为2007—2025年
数据层级:上市公司—年度面板数据
核心指标:高管实际在职消费(万元)、高管正常在职消费(万元)、高管超额在职消费(万元)
识别变量:stkcd(公司代码)、year(年度);证券代码与证券简称为辅助识别变量
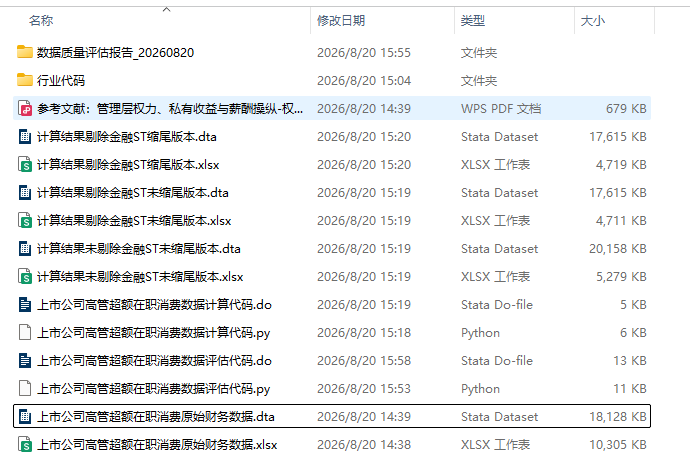
文件格式:Stata .dta、Excel .xlsx、Stata .do、Python .py、UTF-8 .txt

二、原始数据与基本信息合并
上市公司高管超额在职消费原始财务数据.dta:上市公司年度财务、费用、人员、行业及地区基础字段,共74,496条记录、20个字段;主要字段为 stkcd、year、管理费用、董事监事及高管年薪总额、无形资产摊销、坏账准备、存货跌价准备、资产总计、营业收入、固定资产净额、存货净额、员工人数、证券代码、证券简称、行业代码与行业名称。上市公司高管超额在职消费原始财务数据.xlsx 为该原始数据的 Excel 对照文件。
行业代码\上市公司基本信息数据.dta:公司静态基本信息,共5,718条记录、22个字段;主要字段为 stkcd、证券代码、证券中文简称、上市日期、股票类型、行业代码A—D、行业名称A—D、注册资本、成立日期、退市日期、公司名称及公司沿革。计算代码以 merge m:1 stkcd 合并该文件,基本信息文件的同名列优先更新结果数据,并将证券中文简称重命名为证券简称。
三、计算说明
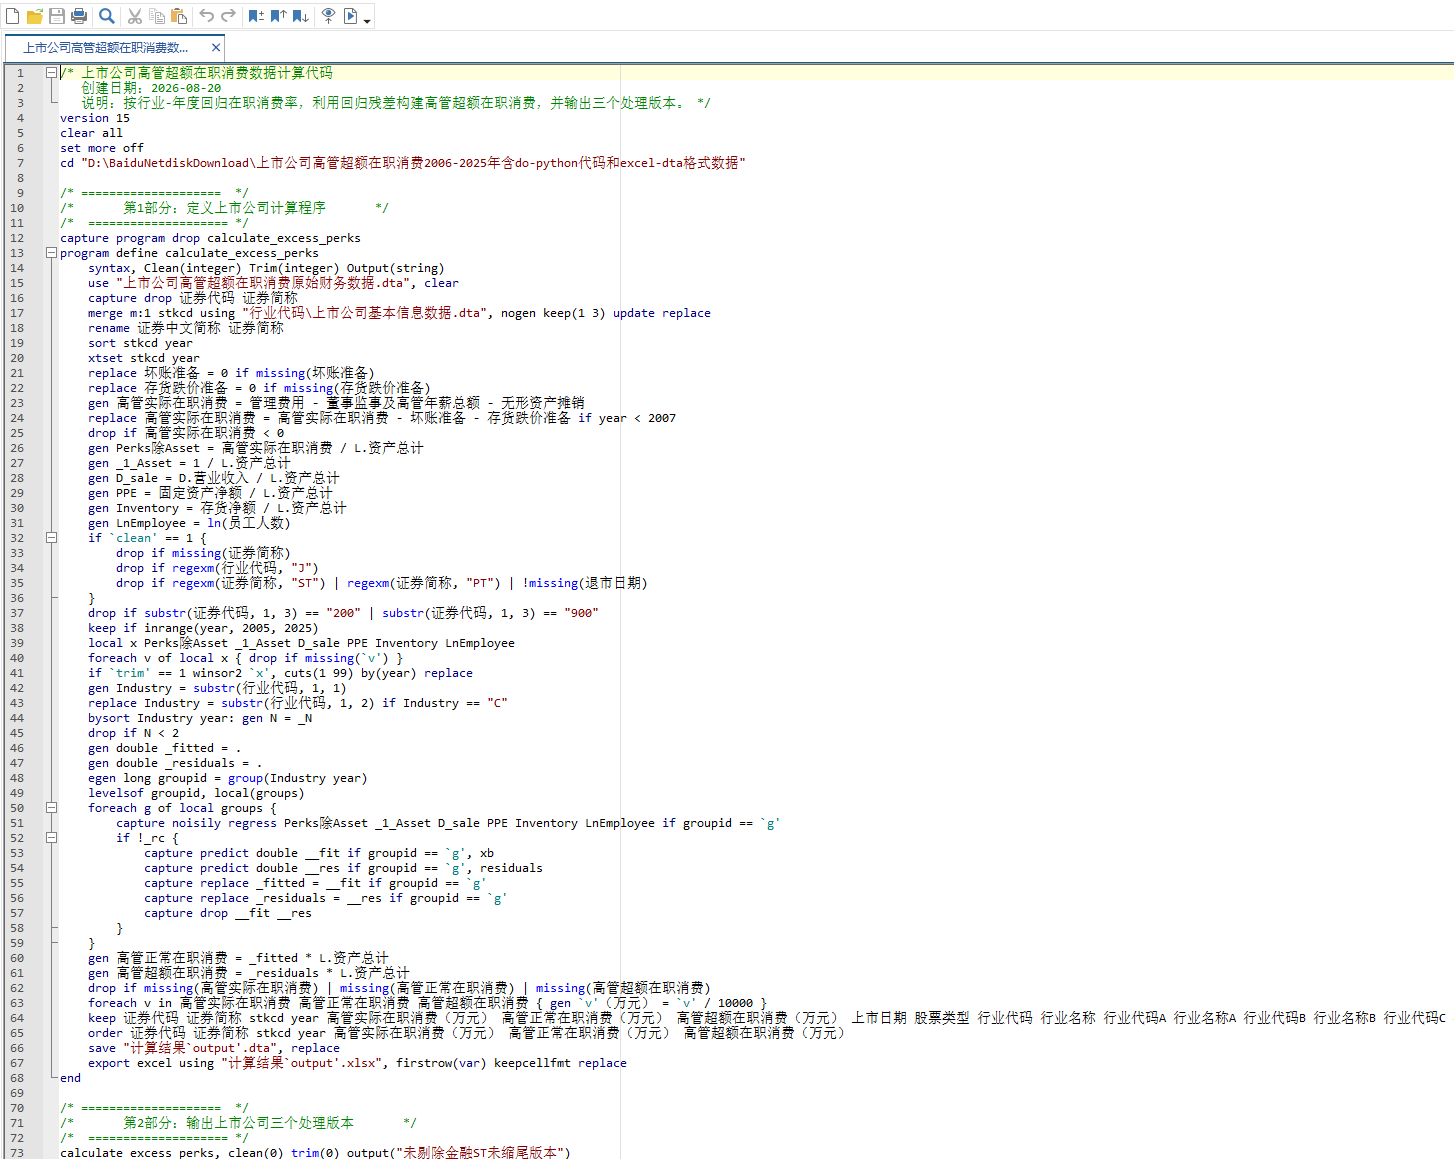
【高管实际在职消费(万元)】先计算高管实际在职消费=管理费用-董事监事及高管年薪总额-无形资产摊销;2007年以前的观测再扣除坏账准备和存货跌价准备,且将这两项准备的缺失值填为0;删除实际在职消费小于0的记录,最后除以10,000换算为万元。值越大表示可由该口径识别的实际在职消费越高。
【Perks除Asset】在职消费率=高管实际在职消费/L.资产总计,其中 L. 表示同一公司上一年度资产总计;该比率为行业—年度回归的被解释变量。
【回归控制变量】_1_Asset=1/L.资产总计,D_sale=D.营业收入/L.资产总计,PPE=固定资产净额/L.资产总计,Inventory=存货净额/L.资产总计,LnEmployee=ln(员工人数);这些变量用于控制规模、销售变动、资产结构和人员规模。
【行业—年度回归】先由行业代码生成 Industry:一般取首位,制造业C取前两位;每个 Industry—year 组样本数不足2时删除。对每个有效行业—年度组估计 Perks除Asset=α+β1×_1_Asset+β2×D_sale+β3×PPE+β4×Inventory+β5×LnEmployee+ε,并保存拟合值与残差。
【高管正常在职消费(万元)】=行业—年度回归拟合值×L.资产总计/10,000,表示由规模、成长、资产结构和员工规模等特征解释的正常在职消费水平。
【高管超额在职消费(万元)】=行业—年度回归残差×L.资产总计/10,000,表示未被模型解释的在职消费;值为正表示实际在职消费高于模型预测的正常水平,值为负表示低于模型预测的正常水平。

四、结果数据文件
共有3套结果数据文件,每套同时提供 .dta 与 .xlsx 格式。样本筛选步骤如下:
(1) 以 stkcd 合并基本信息,构造实际在职消费及滞后资产相关变量,删除实际在职消费为负、核心回归变量缺失、证券代码前三位为200或900、以及不在2005—2025年范围内的记录;
(2) 按行业—年度进行回归,删除组内样本数少于2或无法取得实际、正常、超额在职消费的记录;因使用滞后资产,最终结果从2007年开始;
(3) “剔除金融ST”版本另剔除行业代码含 J 的金融业公司、证券简称含 ST 或 PT 的公司和退市公司;“缩尾”版本在该清洗样本中对 Perks除Asset、_1_Asset、D_sale、PPE、Inventory、LnEmployee 按年度1%和99%分位数缩尾。
编号 文件名称 说明
1 计算结果未剔除金融ST未缩尾版本.dta/.xlsx 保留金融、ST/PT及退市公司且不缩尾的全样本留档版本,48,413条记录。
2 计算结果剔除金融ST未缩尾版本.dta/.xlsx 剔除金融、ST/PT及退市公司但不缩尾的清洗样本版本,43,214条记录。
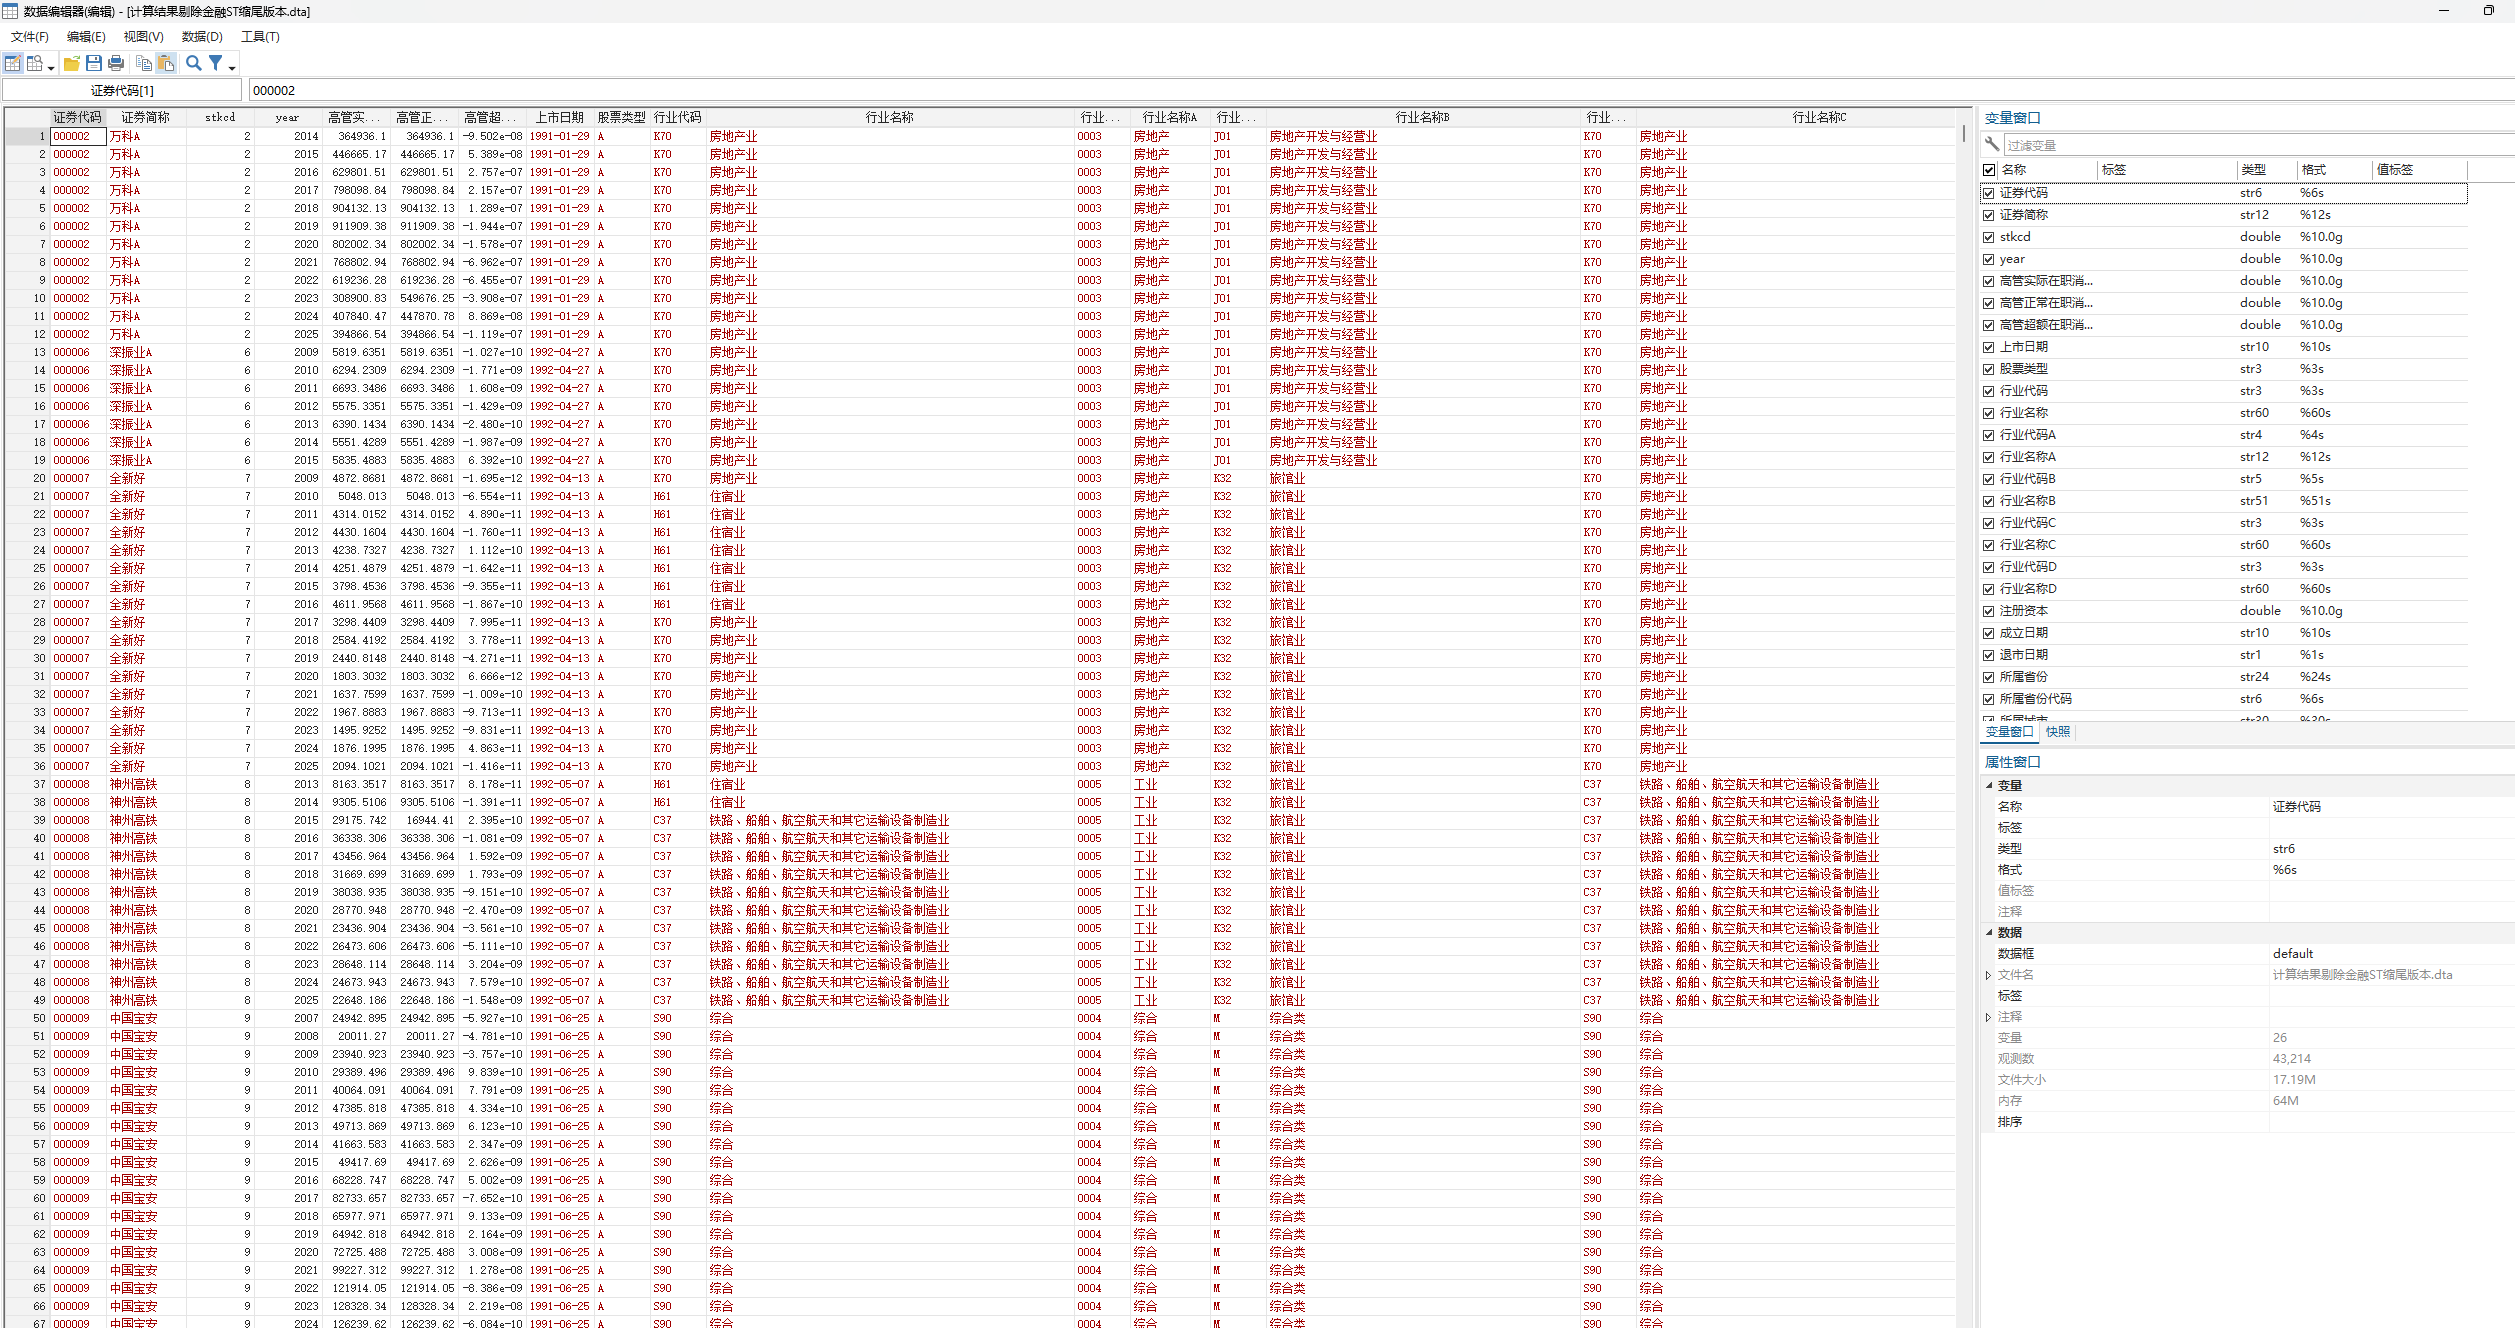
3 计算结果剔除金融ST缩尾版本.dta/.xlsx 在第2套样本基础上对回归核心连续变量年度1%/99%缩尾的常用回归版本,43,214条记录。
五、变量说明
序号 变量名称 变量类型 变量说明
1 证券代码 str 上市公司证券代码。
2 证券简称 str 上市公司证券中文简称,来自基本信息合并结果。
3 stkcd float 公司唯一识别代码,用于公司层面合并与面板识别。
4 year float 财务年度。
5 高管实际在职消费(万元) float 由管理费用扣减相关显性费用后得到的实际在职消费,单位为万元。
6 高管正常在职消费(万元) float 行业—年度回归拟合值还原后的正常在职消费,单位为万元。
7 高管超额在职消费(万元) float 行业—年度回归残差还原后的超额在职消费,单位为万元;正值表示高于模型预测。
8 上市日期 str 公司上市日期。
9 股票类型 str 股票类别。
10 行业代码 str 原始行业代码,也是行业—年度回归分组的基础。
11 行业名称 str 原始行业名称。
12 行业代码A str A级行业代码。
13 行业名称A str A级行业名称。
14 行业代码B str B级行业代码。
15 行业名称B str B级行业名称。
16 行业代码C str C级行业代码。
17 行业名称C str C级行业名称。
18 行业代码D str D级行业代码。
19 行业名称D str D级行业名称。
20 注册资本 float 公司注册资本。
21 成立日期 str 公司成立日期。
22 退市日期 str 公司退市日期;缺失通常表示未退市。
23 所属省份 str 公司注册地所属省份。
24 所属省份代码 str 公司注册地省份代码。
25 所属城市 str 公司注册地所属城市。
26 所属城市代码 str 公司注册地城市代码。

六、代码文件
文件名称 语言 说明
上市公司高管超额在职消费数据计算代码.py Python 读取原始财务数据、合并基本信息、按行业—年度回归计算在职消费并输出三套结果。
上市公司高管超额在职消费数据计算代码.do Stata 与 Python 版计算口径对应的 Stata 计算代码。
上市公司高管超额在职消费数据评估代码.py Python 独立评估结果数据的分布、缺失、异常值、逻辑连续性和稳健性并输出图表与CSV。
上市公司高管超额在职消费数据评估代码.do Stata 与 Python 评估功能对应的 Stata 数据质量评估代码。
七、数据质量评估
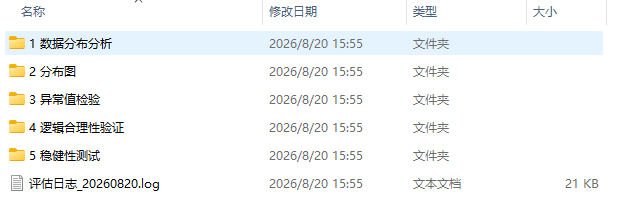
评估结果运行时存放于 数据质量评估报告_YYYYMMDD 文件夹(本次运行目录为数据质量评估报告_20260820),运行日志为 评估日志_YYYYMMDD.log。各子文件夹内容如下:
子文件夹名 内容说明
1 数据分布分析 各变量描述性统计、缺失情况与频率分布CSV。
2 分布图 未剔除金融ST未缩尾版本的直方图、箱线图、核密度图、散点图矩阵和时间趋势图,JPG为300dpi。
3 异常值检验 IQR法、Z-score法、缺失率和范围检验结果CSV。
4 逻辑合理性验证 自动识别 stkcd/year 后的重复公司—年度记录与年度断档检验CSV。
5 稳健性测试 不同样本期、不同处理版本对比及变量级总评估结论CSV。

八、参考文献
[1] 权小锋, 吴世农, 文芳. 管理层权力、私有收益与薪酬操纵[J]. 经济研究, 2010(11): 73-87.
[2] 陈冬华, 陈信元, 万华林. 国有企业中的薪酬管制与在职消费[J]. 经济研究, 2005(2).
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
栏目导航
热门文章
推荐文章
 扫码加好友,拉您进群



 全部版块
 我的主页


 收藏