AI系统不应仅凭能够生成预测结果,就直接执行自动化决策。决策系统必须评估预测结果的不确定性;一旦决策失误代价高昂,系统应当主动暂缓执行、交由人工复核。
一、生产级AI的普遍误区:点估计掩盖隐性风险
当前绝大多数落地的AI系统,优化目标均为“输出确定答案”:分类模型标记高风险客户、时序模型预测市场需求、智能分析agent自动推荐营销预算调配方案。模型最终输出往往是单一数值或固定类别,且时常直接触发自动化操作。
这种输出形式会人为放大模型确定性,掩盖真实不确定性:
8%的业务增长预测看似精准,但真实结果可能是负增长或远超预期的暴涨;
被标记为高风险的客户,可能只是刚好越过人工设定的任意阈值;
看似亏损的营销活动,可能只是转化存在延迟,长期具备盈利空间。
核心风险:当单一预测值直接驱动自动化动作,模型隐藏的不确定性,会直接转化为企业可落地的业务操作风险。
相较之下,贝叶斯方法不输出单点估值,而是通过概率分布完整刻画不确定性。但仅在数据看板展示宽泛的预测区间远远不够,系统必须基于不确定性建立决策规则:何时自主执行、何时人工审核、何时放弃决策。
二、自动化的本质问题:不确定性的代价被无限放大
所有分析系统都存在不确定性,区别仅在于是否被量化、是否被重视。
人工分析师查看数据看板时,会主动停顿核查:校验数据完整性、比对历史规律、跨团队确认业务上下文,规避异常值风险。但自动化流程彻底消除了人工缓冲校验环节。AI可在数秒内处理上千条业务案例,模型可靠时这是效率优势,但若模型“自信地输出错误结果”,自动化会批量放大失误,引发系统性风险。
美国国家标准与技术研究院 NIST AI风险管理框架 明确指出:AI风险具备场景依赖性,企业必须全程量化、持续管控系统全生命周期风险。
同一预测结果,风险等级完全不同:展示给分析师参考的推荐几乎无业务风险,但直接调控定价、库存、信贷额度、营销预算、人力规划的同款推荐,会产生极高的落地影响。
因此,模型准确率不足以支撑自动化决策。只有当剩余不确定性低于业务可承受阈值时,系统才能安全执行动作。
三、单点预测的致命缺陷:缺失决策关键信息
基于多源营销分析场景可直观体现单点估值的弊端:
企业AI模型给出预算调优建议:上调某营销活动预算,预计转化率提升7%。从单点预测来看,决策逻辑清晰、可直接执行。
但真实概率分布往往更加复杂:模型可能存在“小概率大幅增收、中概率持平、一定概率盈利下滑”的多重结果。即便平均预测值为正向增长,亏损风险依然可能超出业务承受阈值,此时自动化调优预算具备极高风险。
单点预测仅能回答一个问题:模型的核心预测值是什么。它完全隐藏了三类决策关键信息:
而这些信息,恰恰是预测结果需要直接驱动业务动作时,最核心的判断依据。
四、贝叶斯模型的核心价值:从单点估值到概率分布
贝叶斯模型结合先验知识与观测数据,输出参数的后验分布,而非固定数值。针对未来业务预测,后验预测分布是核心输出:同时囊括模型参数不确定性与未来数据的自然波动,真实还原模型可预期的结果区间。
作者在经济政策不确定性研究中证实:建模的核心目标不是输出单一估值,而是量化不确定性、展示不同业务场景下的预测波动规律。
该逻辑完全适配企业AI自动化场景:
智能分析agent披露每一条业务推荐的证据稳健性。
五、两类核心不确定性:随机不确定性与认知不确定性
工程落地中,模型预测不确定性可划分为两类,定位问题、指导优化的价值极高:
5.1 随机不确定性(Aleatoric Uncertainty)
源于数据本身与业务流程的自然波动:客户行为随机变化、传感器数据噪声、转化事件延迟、同类用户对同一营销动作反馈差异。这类不确定性无法通过增加样本彻底消除,必须纳入决策考量。
5.2 认知不确定性(Epistemic Uncertainty)
源于模型认知局限:新客群、新市场、新产品、新经济周期场景下,模型有效证据不足、参数拟合不完善、场景适配性差。这类不确定性可通过补充数据、优化模型、场景测试降低。
5.3 落地指导意义
两类不确定性无法绝对割裂,但可精准指导迭代方向:
高随机不确定性:场景本身不可预测,需收紧自动化决策阈值、降低动作幅度;
高认知不确定性:模型认知不足,需补充场景数据、前置测试、迭代模型结构,禁止贸然自动化。
六、置信度≠安全防护:常见认知误区
多数AI输出的置信度分数,未经校准则不具备概率意义。分类模型输出90%置信度,不代表同类场景90%结果正确。大量研究证实:高精度神经网络普遍存在置信度校准偏差问题。
同时,贝叶斯模型并非天然安全:后验分布受先验假设、模型结构、似然函数、数据质量、推理流程影响。不合理的模型假设会生成虚假的窄区间预测,看似精准、实则严重失真。
真正的决策防护机制,必须包含三步:量化不确定性 → 校验校准精度 → 基于业务制定分级决策规则。无落地规则的不确定性数值,仅为看板数据,无法约束系统行为。
七、贝叶斯决策防护:将不确定性转化为可执行规则
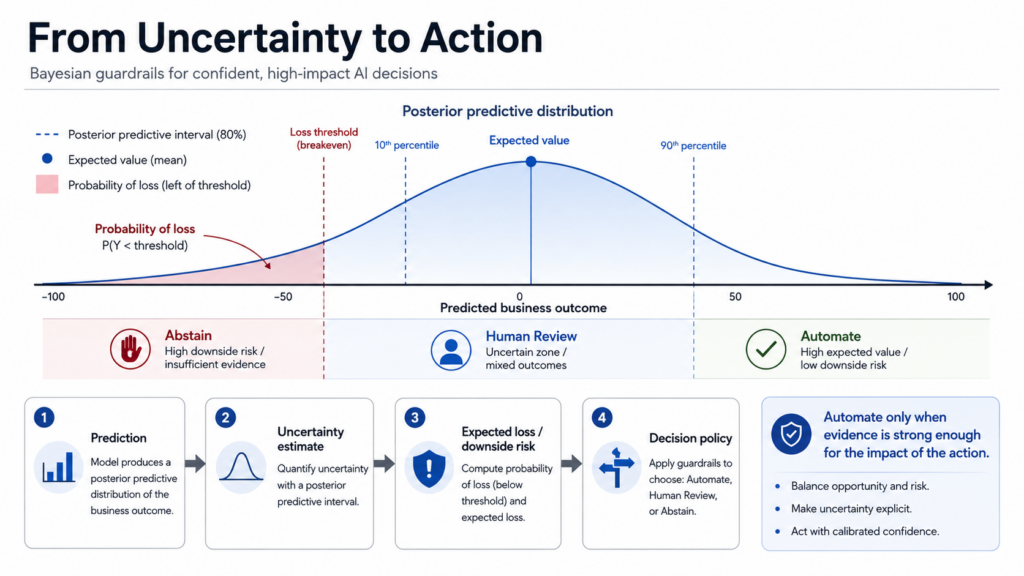
核心逻辑:决策不能仅看预期收益是否为正,必须综合全量结果概率分布与失误代价。贝叶斯最优决策的本质是:最大化后验分布下的预期收益,或最小化预期损失。最优预期结果,不代表最优决策。
7.1 基于业务代价的动态决策阈值
决策阈值不统一固化,完全匹配业务影响:
小额、可逆、有上限的预算调整:可容忍更高不确定性;
大促节点、大额资金调配:极低不确定性也需强制人工复核。
7.2 三级决策机制(核心落地规范)
自动执行区:预期收益为正、预测区间宽度合规、负面损失概率低于业务阈值;
人工复核区:预期收益为正,但不确定性偏高、历史数据支撑不足、业务影响较大;
暂停决策区:证据不足、下行风险超标、超出适用场景、核心数据缺失。
阈值由业务损失程度、动作可逆性决定,而非全局统一的固定置信度分数。
7.3 重视尾部风险,而非仅优化均值收益
均值最优策略往往隐藏致命尾部风险:部分方案平均收益最高,但存在小概率巨额亏损;另一些方案平均收益略低,但风险波动极小。仅优化均值的自动化系统,会优先选择高风险方案;而贝叶斯防护机制可兼顾收益均值与极端尾部风险概率、损失量级。
该机制对金融风险、合规管控、用户权益、业务稳定性类决策至关重要,核心不是消除风险,而是让企业显性化、可控化地接纳已知风险。
八、生产级贝叶斯防护架构(四层可落地架构)
防护机制部署于预测层与执行层之间,实现解耦管控,全程可追溯。
8.1 预测层
摒弃单点输出,统一输出后验预测分布。可通过贝叶斯分层建模、概率编程、神经网络贝叶斯近似、集成概率模型等方式实现,核心要求是:不确定性量化结果可针对决策场景校验有效。
8.2 决策层 & 策略层
决策层将概率分布转化为业务可用指标:负面结果概率、预期损失、超限风险概率、场景敏感性波动。
策略层基于业务阈值判定:自动执行、人工审核、暂停决策。风险容忍度由企业业务规则定义,不由模型自主决定。
8.3 执行层 & 可观测层
执行层仅在校验通过、审批完成后执行动作,与预测模型完全解耦。
可观测层全程日志记录:预测分布、区间宽度、决策阈值、风险指标、策略判定、人工干预记录、最终执行结果。精准定位故障来源:模型偏差、不确定性估算失效、数据问题、策略不合理、执行异常。
九、落地案例:营销预算自动化调配
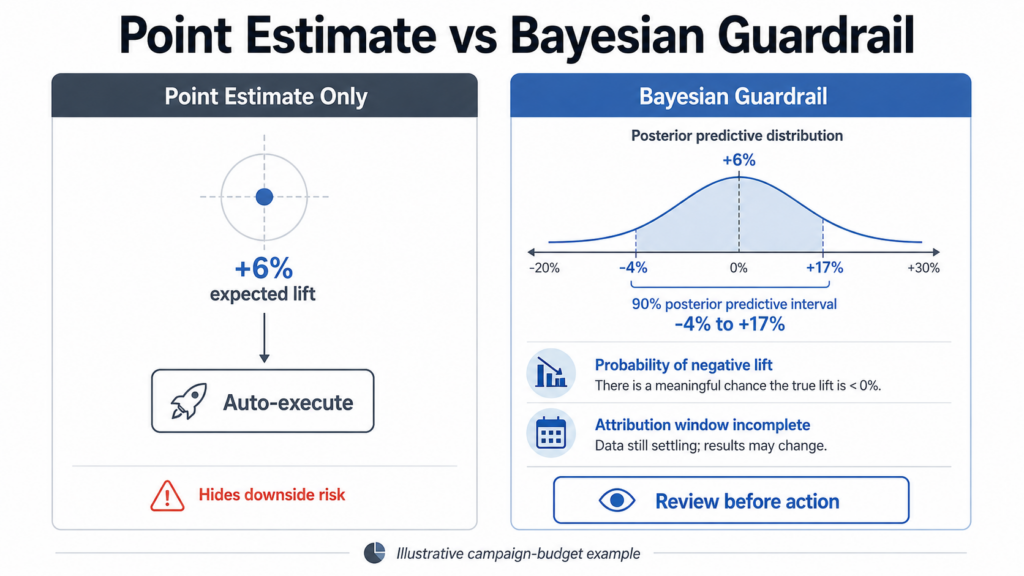
模型推荐:将A活动15%预算调配至B活动,预期整体转化率提升6%。
贝叶斯后验区间:90%预测区间为转化下降4% ~ 增长17%,存在不可忽视的负面收益概率。
传统AI系统:仅参考正向均值收益,直接执行预算调整。
贝叶斯防护系统:校验下行风险是否超标、核查归因数据完整性、核验目标场景数据充足度。
若风险超标,系统不会直接否决,而是输出柔性方案:缩小调整幅度、改为人工复核、等待补充转化数据后再决策。随着线上数据累积、不确定性收敛,系统可在风险可控后自动执行同类操作,实现动态自适应防护。
十、弃权机制:高风险场景的核心生产能力
传统AI追求全量响应、零空缺回答;生产级高风险自动化的核心准则是:证据不足时,不决策远优于乱决策。
贝叶斯防护机制支持主动弃权场景:
主动弃权不是系统故障,是规避弱证据误决策、保障业务安全的核心能力。研究表明,带不确定性筛选的弃权机制,可显著提升最终落地决策的准确率与可靠性。
十一、上线后持续监控:避免不确定性估算失效
模型上线后,业务环境、用户行为、产品形态、数据链路均会迭代变化,历史有效的不确定性估算会逐渐变得过度自信、脱离实际,必须持续监控校准。
11.1 预测区间覆盖率校验
核心校验标准:真实业务结果是否稳定落在对应置信度的预测区间内(如90%结果落入90%预测区间)。
覆盖率不足:预测区间过窄、模型拟合失真、低估风险;
需结合区间宽度、弃权率、决策损失、细分客群表现综合评估,避免整体达标、高危细分场景失效的问题。
11.2 后验预测校验
基于拟合模型生成复刻数据,比对决策依赖的核心业务特征与真实数据是否匹配,校验模型是否精准复现业务核心规律(延迟转化、波动极值、区域差异等)。即便整体均值拟合良好,若无法复刻风险特征,模型仍不具备自动化决策资质。
11.3 持续校验防护策略本身
决策阈值、防护规则需动态迭代:小流量试点有效的阈值,大流量落地后可能风险失控;过高弃权率代表数据不足、模型不确定性过高;过低弃权率代表策略过于宽松、风险准入失控。需将防护机制作为完整决策系统迭代优化,而非仅监控模型精度。
十二、贝叶斯防护的局限性与互补方案
贝叶斯方法提供了不确定性决策的数理基础,但无法彻底消除模型风险:先验选择不当、似然函数配置错误、关键特征缺失,都会导致虚假精准的预测分布;高延迟业务场景下,完整贝叶斯推理算力成本过高,近似算法需单独校验不确定性精度。
同时,贝叶斯机制无法天然防御对抗样本、数据分布偏移、劣质数据问题。
共形预测(Conformal Prediction)互补能力
共形预测可在有限样本下提供边际覆盖率保障,但无法保证单一样本、细分场景的精准覆盖,且对时序营销、季节性、延迟转化等动态业务场景的适配性有限。
最优工程方案:融合贝叶斯不确定性量化、共形校准、人工复核、持续监控、动态策略阈值,构建多层防护体系,不依赖单一技术。
十三、核心结论:真正的防护是决策边界,而非置信分数
AI系统的可信性,从来不取决于是否输出置信度分数,而取决于是否建立「不确定性-决策边界」的强绑定关系:明确模型可自主执行、仅建议、必须暂停的边界条件。
当下多数自动化流程存在致命漏洞:跳过不确定性校验,直接从预测值跳转业务动作,将模型分数等同于最终决策。
安全的AI自动化范式:
观测完整的结果概率分布、评估尾部风险、匹配企业风险容忍度,仅在证据充足、风险可控时,才执行自动化决策。
评判AI系统的核心标准,不是预测准确率,而是:能否做出正确决策、能否自知认知不足并主动规避风险。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





