普通回归无法回答的问题
有这样一份数据集:432名刑满释放人员,为期一年随访,观测唯一结局事件:再次被捕。一部分人在第8周、第30周再度被捕;大多数人(318人)在研究结束时从未被捕。
研究核心问题:犯人再次犯罪需要经历多长时间?
我们不能直接对被捕时间求平均值:四分之三的样本从未被捕,没有对应的被捕时间。也不能直接剔除这部分样本——只分析发生事件的样本,会错误得出“所有人最终都会再犯罪”的结论,该结论既不符合事实也非常片面。同样,也不能把未被捕人员粗暴标记为第52周被捕,现实中他们要么是52周之后才被捕(未观测到),要么永远不会被捕。
以上情形:我们只知道样本至少存活这么久,但不知道确切的事件发生时间,这就叫删失(Censoring)。生存分析这门学科正是为处理删失问题而生。普通线性回归只能接收确定数值,无法表达“至少52周”这类信息。而生存分析专门应对大量样本在观测终止时,事件仍未发生的场景。
本文围绕删失这一核心问题展开,首先介绍生存分析三大基础概念,之后完成三项实操:
- 使用Kaplan‑Meier法,直接基于数据估计生存曲线
生存分析三大核心概念
生存分析几乎全部建立在下面三个基础要素之上:
事件与时间:选定一个明确定义的结局事件,可以是死亡、再次被捕、设备故障、订阅流失、贷款违约。对每个样本记录两项信息:观测时长;观测终止原因,即事件标识变量(二元,1代表发生事件,0代表删失)。时间、事件标识两列是所有生存模型的核心输入。
生存函数 S(t):样本存活超过时间t、尚未发生目标事件的概率。初始时刻t=0,S(t)=1;随着时间推移逐步下降趋近于0。
示例:12个月生存概率等于0.7,代表70%样本在一年后仍未发生目标事件。
”
- 风险函数 h(t):在已经存活至
t时刻的前提下,样本在t瞬间发生事件的瞬时速率。通俗理解:活到此刻的人群当中,有多大比例会在当下发生事件。
需要分清S(t)与h(t):生存函数是累积结果,风险函数是瞬时速率。人活到80岁的总概率很低(生存值小),但人刚满80岁那一刹那的瞬时风险是完全不同的指标。
可以打比方:生存函数代表水箱剩余水量;风险函数代表此刻水箱的出水速度。二者通过微积分关联:风险等于事件密度除以生存函数;对风险函数积分,又可以还原得到生存函数。
为什么重点研究风险,而不是直接对生存函数建模?
因为协变量天然适合作用于风险。例如“经济补助可以将再被捕的瞬时风险每时每刻乘以0.68”,这句话描述的就是风险,也正是Cox模型输出的结果。
Kaplan‑Meier:无假设生存曲线估计
建模之前,可以直接由数据估计生存函数S(t)。Kaplan‑Meier估计量(1958),统计学领域引用量极高的经典论文,它不需要预先假设生存曲线的函数形态。
原理很直观:顺着时间向前遍历;每当有事件真实发生,统计发生事件前一刻仍处于风险集合的总人数,以及实际发生事件的人数;不断把“本时刻继续存活的比例”连乘。
删失样本在离开研究之前,始终计入风险人群;退出之后安静离开,不会让生存曲线向下跳变。
下面使用Rossi再犯罪数据集,该数据集内置在Python lifelines库,来自Rossi、Berk、Lenihan1980年随机对照实验:跟踪432名释放囚犯一年,记录是否再次被捕,同时包含种族、教育等协变量。实验将受试者随机分为两组:出狱后获得经济补助组、无补助组,分组随机,对比具备可比性。
from lifelines import KaplanMeierFitter
from lifelines.datasets import load_rossi
import matplotlib.pyplot as plt
df = load_rossi()
kmf = KaplanMeierFitter()
for value, label in [(0, "无经济补助"), (1, "获得经济补助")]:
g = df[df.fin == value]
kmf.fit(g["week"], g["arrest"], label=label)
kmf.plot_survival_function()
plt.ylabel("S(t):保持未被捕状态概率")
plt.show()
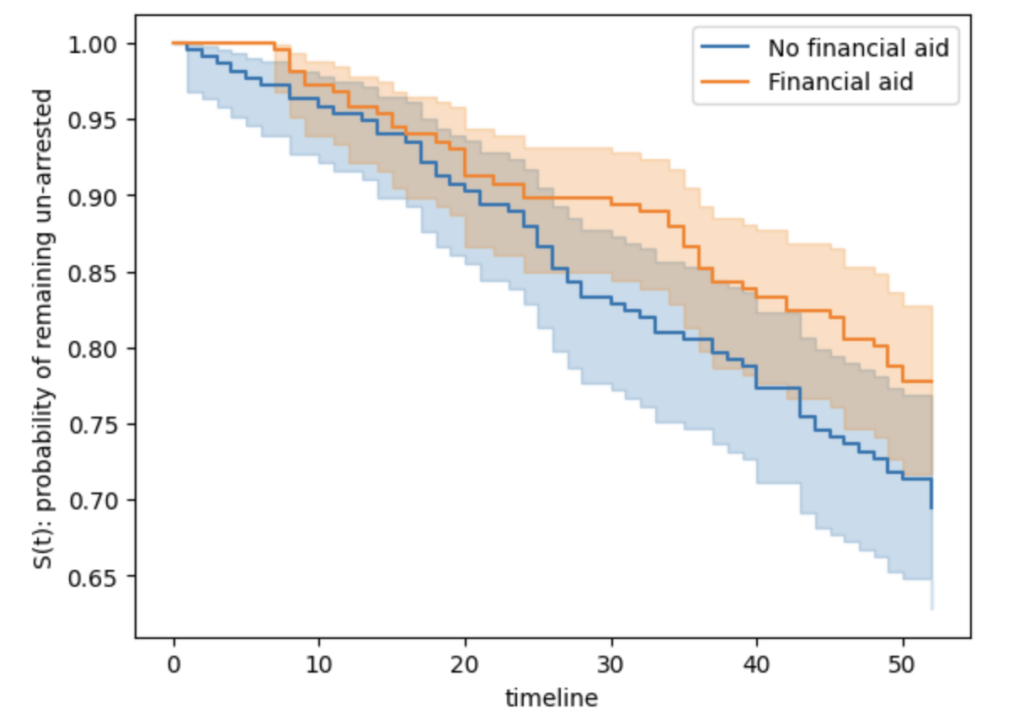
图1:按经济补助分组的Kaplan‑Meier曲线。每一处向下台阶代表有人再次被捕;阴影带为95%置信区间。补助组(蓝色)全程生存曲线位置更高。第52周,补助组再被捕约22%;无补助组约31%。
”
判断两组曲线差异是否属于随机波动,使用对数秩检验(log‑rank test):对比每组实际事件数,和假设两条曲线完全相同时的理论期望事件数。
from lifelines.statistics import logrank_test

results = logrank_test(
    df[df["fin"] == 1]["week"],
    df[df["fin"] == 0]["week"],
    event_observed_A=df[df["fin"] == 1]["arrest"],
    event_observed_B=df[df["fin"] == 0]["arrest"],
)
results.p_value
本数据集得到p≈0.05,处于显著性临界值。
注意:Kaplan‑Meier+对数秩检验只能做单变量分析,无法校正年龄、前科等混淆因素。想要控制协变量,就要使用Cox模型。
Cox模型:对风险做回归
当我们需要类似回归的能力:输入协变量,输出变量效应,但目标对象是风险。
朴素思路是完整写出h(t)函数表达式全部参数。但现实中我们往往不知道风险随时间变化的函数形态,也不想强行指定。
Cox的核心洞见:不需要指定基线风险的具体形态,依旧可以估计协变量的效应。
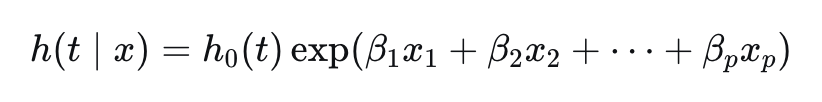
模型表达式由两部分相乘:
- :基线风险,所有协变量全部取0的假想样本随时间变化的风险。形态完全不做限定,可以是任意曲线,属于模型的非参数部分。
- :协变量效应项,根据个体特征,对基线风险做整体放大或缩小,属于参数部分。
所以Cox是半参数模型。
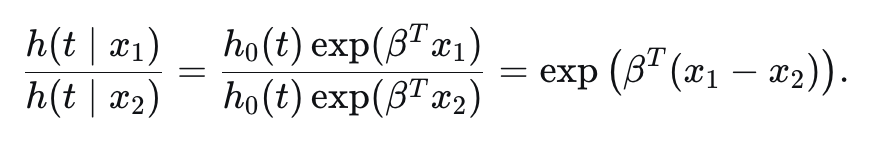
Cox模型的巧妙之处:取两个样本风险的比值。基线风险对两者完全一样,做比值时分子分母抵消。
最终风险比表达式不再含有时间t。第1周、第20周、第52周的风险比完全相等,无需知道基线风险的形状——这就是Cox模型的核心。
Cox进一步提出偏似然函数:在每一个事件发生时刻,提出问题:
当前所有仍处于风险集合的人当中,为什么偏偏是这个人发生事件,而不是其他人?
”
删失样本适配这套机制:在退出研究之前留在风险集合,之后退出,不发生事件;但提供了“截止删失时刻仍然没有出事”的信息。
拟合前两个概念:
- 结(Ties):偏似然假设事件可以严格排序;同一时间点发生多个事件时,软件需要校正,现代默认采用Efron方法,精度优于Breslow方法。
- 即为风险比(Hazard Ratio, HR)。系数,则,无效应;,,保护性因素,降低风险;升高风险。论文报告一律输出指数化后的风险比。
Python拟合Cox模型并解读风险比
lifelines库实现Cox模型非常简便:
from lifelines import CoxPHFitter

cph = CoxPHFitter()
cph.fit(df, duration_col="week", event_col="arrest")
cph.print_summary()
输出结果汇总:
| 协变量 |
风险比(\exp(\beta)) |
95%置信区间 |
p‑value |
| 经济补助 |
0.68 |
0.47‑1.00 |
0.047 |
| 年龄(每增长一岁) |
0.94 |
0.90‑0.99 |
0.009 |
| 前科次数(每一次) |
1.10 |
1.04‑1.16 |
0.001 |
| 种族 |
1.37 |
0.75‑2.50 |
0.31 |
| 工作经历 |
0.86 |
0.57‑1.31 |
0.48 |
| 已婚 |
0.65 |
0.31‑1.37 |
0.26 |
| 处于假释期 |
0.92 |
0.63‑1.35 |
0.67 |
解读:
- 经济补助 HR=0.68:任意时刻,领取补助会让再被捕瞬时风险降低32%,也是原始实验想要验证的处理效应。
- 年龄 HR=0.94:年龄每增加一岁,再犯罪风险下降约6%;年纪更大的释放人员犯罪速率更低。
- 前科 HR=1.10:每多一次前科,风险上升10%,效应是相乘形式;5次前科,风险大约为 倍。
⚠️风险比不等于生存概率差值。风险比是瞬时事件速率的倍数,假设随访全程倍数恒定。引出关键问题:倍数真的恒定吗?
”
模型名称背后的假设:比例风险假设
模型之所以叫比例风险模型,根源就在于风险比不随时间t变化:任意两个个体之间的风险比值全程不变。
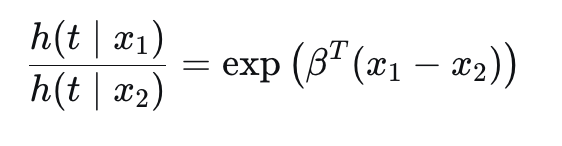
经济补助在第2周降低32%风险,到第50周依旧降低32%。两组风险同步升降,一组始终是另一组的固定倍数;两条生存曲线不能相交。
现实情况未必满足:干预措施初期效果极强,后期衰减;风险因素只在长期随访才显现危害。一旦真实风险比随时间漂移,普通Cox模型给出的单一系数,在早期、晚期都会出现偏差。因此必须检验比例风险假设。
主流检验基于Schoenfeld残差(Schoenfeld 1982;Grambsch & Therneau 1994提供缩放残差与正式检验)。每个事件发生时刻,Schoenfeld残差衡量发生事件样本的协变量取值,对比此刻风险集合内协变量平均值的偏差。
比例风险假设成立,则残差相对时间没有趋势;残差出现明显斜率,代表效应随时间改变,比例性假设破坏。
cph.check_assumptions(df, p_value_threshold=0.05, show_plots=True)
本数据集检验发现两个变量违反假设:age年龄、wexp工作经历,p值分别0.0007、0.0063。
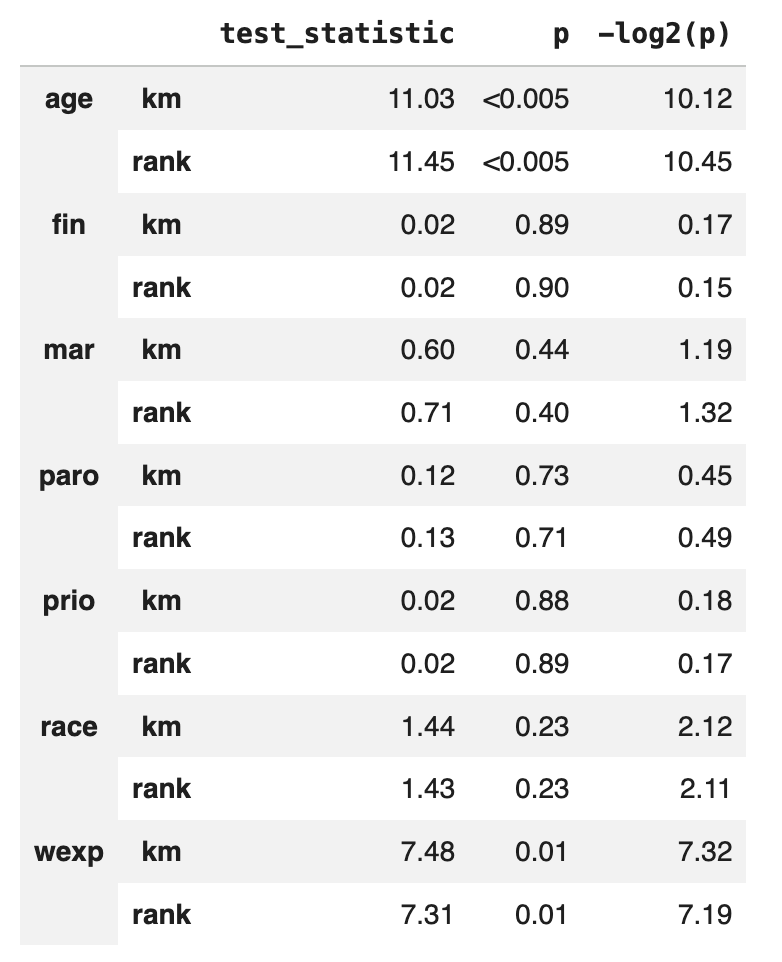
这是真实数据集暴露的典型问题:如果只看模型系数p值就结束分析,问题会被完全掩盖。年龄HR=0.94本身不算错误,但不够完整,模型把随时间变化的效应强行压缩成单一常数。
比例风险假设不满足时如何处理
假设检验不通过不等于分析作废,往往反而是分析最有价值的发现,三种常用解决方案:
- 分层(Stratify):变量违反比例风险,但我们只需要做混杂校正,不需要估计该变量本身效应,则使用分层。分层会为该变量每一个类别拟合独立基线风险,不再强制效应比例恒定。
cph_strat = CoxPHFitter()
cph_strat.fit(
    df,
    duration_col="week",
    event_col="arrest",
    strata=["wexp"]
)
cph_strat.print_summary()
对工作经历分层修复比例风险问题之后,核心结果保持稳定:经济补助HR=0.68;年龄每岁HR=0.94;前科HR=1.09依旧统计显著。种族、婚姻、假释无显著性。模型一致性指数0.61,说明模型对“谁会更早被捕”具备中等排序能力。
允许效应随时间变化:如果希望研究效应如何随时间改变,增加协变量与时间函数的交互项,得到时变系数。lifelines中使用CoxTimeVaryingFitter,需要把数据按事件时刻拆分。
优先检查变量函数形式:Schoenfeld检验对协变量函数形式错误很敏感。年龄的真实效应是非线性(风险快速下降之后趋于平稳),直接以线性形式放入模型,即便风险本身满足比例,也会触发检验报错。在使用时变模型前,可以尝试给违规变量增加平方项。
核心要点总结
- 删失不是缺失值,是有效信息。生存分析方法的目标就是正确使用删失样本携带的部分信息。千万不要直接删掉未发生事件的样本,这恰恰会引入生存分析要规避的偏差。
- Kaplan‑Meier用于探索,Cox模型用于校正混杂。优先绘制KM曲线,假设条件少,建立生存形态直观认知;需要控制协变量再切换Cox回归。报告输出风险比带上置信区间,不只输出p值。
- 风险比是风险的倍数,不是加减法。HR=0.68代表补助把瞬时再被捕速率变为原来三分之二;并不直接告诉我们多少人免于被捕,也不告诉我们延长多久无罪时间。并且默认倍数全程不变,该假设必须检验。
- 务必检验比例风险假设,仅几行代码,是一份严谨生存分析和脆弱分析的分水岭。不满足假设时,可以分层建模、拟合时变效应、修正协变量函数形式。
- 模型拟合优度看一致性指数 Concordance,不要用R²。一致性指数衡量模型对事件发生先后顺序的排序能力。
生存分析本质上就是一套回归,坦然接纳“部分结局我们尚未观测到”。吃透风险比,重视比例风险假设,你的分析结论才能经得起时间检验。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





