全部版块 我的主页
› 论坛 › 金融投资论坛 六区 › AIFA AI金融分析师
99 0
2026-09-08

上个月试着拿"智研小 Q"——一个常见的中文金融问答 AI——去做信用债的尽调问答。让它根据监管处罚公告、评级报告、募集说明书三份公开材料,回答 100 个关于某发行人偿债能力的问题。每个问题背后都标了"参考资料在哪一页",AI 给出答案后人工核对其引用的页码、原文、结论是否一致。

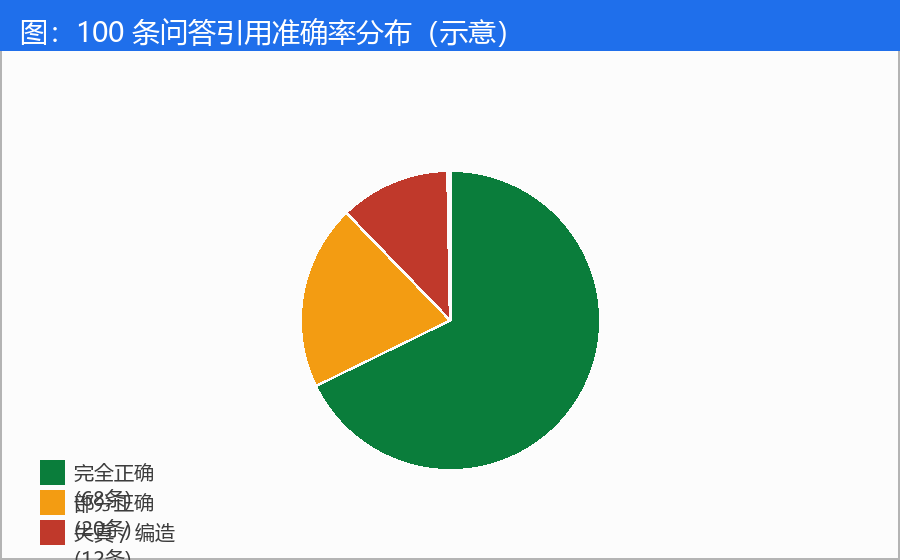
100 个问题跑完,结果让人惊讶:只有 68 条完全正确、20 条部分正确、12 条失真或编造。换句话说,32% 的回答存在引用问题——这跟 AI 给出的"已参考相关公告"的自信语气完全不匹配。

当时最让我警醒的不是"AI 也会错",而是"AI 错得很自信"——它会一本正经地引用一个不存在的页码,或者把 A 公司的处罚决定书嫁接到 B 公司上。所以这次专门把 12 条失真案例翻了一遍,看看到底错在哪、为什么错。

一、100 条问答的引用准确率分布

把 100 条问答的引用准确率按"完全正确 / 部分正确 / 失真"三档画出来:68 条完全正确、20 条部分正确、12 条失真或编造。换算成比例:68% / 20% / 12%。这个分布最让我意外的是"部分正确"这一档——不是全错,而是"看起来对但细节错",人工不核对根本发现不了。

这跟平时理解的"AI 错得很离谱"不一样。AI 大部分时候输出得体的、可读的、甚至看着专业的回答,但细节上引用的页码 / 数字 / 主体总有偏差,这种偏差用户不核对根本不会发现。这也是为什么"AI 已参考"这种承诺在金融场景里特别危险——它给你一种"已经查过"的安全感,但安全感是假的。

另一个被这次测试放大的现象是"领域依赖度"。同样的 AI 模型,在"一般知识问答"上表现稳定,但在"信用债尽调"这种对原文高度依赖的领域里表现明显下滑。这个下滑不是模型能力问题,是工作流问题——AI 在没有强约束的工作流里会倾向于"看起来合理"而非"完全准确"。换句话说,越是专业、越是对原文敏感的领域,越要给 AI 加约束;越是常识、越是不依赖原文的领域,反而可以放松。

二、引用失真的三种原因占比

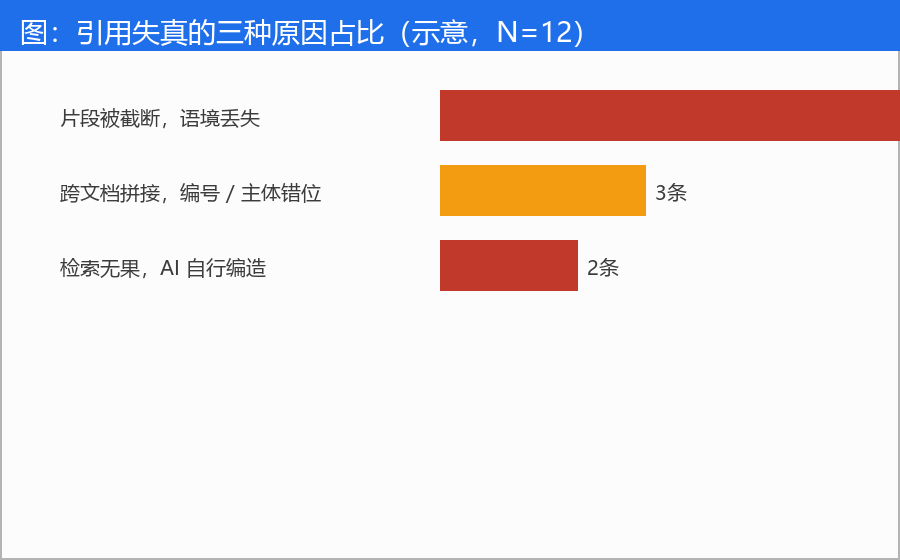
把那 12 条失真案例拆开看,原因集中在三类:

  • 片段被截断,语境丢失:7 条。AI 抓到一段文字但只用了半句,前后语境没拉进来。比如评级报告里有一句"短期债务占比偏高,但公司账面现金充裕",AI 只引用了前半句,结论就变成"短期偿债压力大"。这种情况下,用户看到的引用是真实的,但引用之外的语境被 AI 自己补全了——补全的部分就是失真的源头。
  • 跨文档拼接,主体错位:3 条。AI 把 A 公司的某段文字接到了 B 公司的回答里。比如 A 公司的处罚决定书说"罚款 50 万元",AI 把这个数字安到了 B 公司的处罚情况上。这种失真最隐蔽——引用的原文是真实的,但主体错了,错的主体让真实原文变成了虚假信息。
  • 检索无果,AI 自行编造:2 条。AI 没有找到对应的公告,就"按行业惯例"编了一个数字或日期。这是最危险的——编造的内容看起来很具体,但完全是虚构的。编造的细节往往包括"日期""金额""编号"这种用户倾向于信任的具体字段。

这三类失真加起来,让"AI 已参考"的承诺变成了一句空话。"我查过了"和"我引用了正确的内容"是两件事——AI 可能真的查了,但它查的结果不是你想的那个。

三类失真的比例分布背后有一个规律:失真越严重,占比越低,但危害越大。"片段截断"占 58%,危害最低(用户多看一眼就能发现);"跨文档拼接"占 25%,危害中等(需要交叉核对才能发现);"AI 编造"占 17%,危害最高(根本无法靠人工核对发现,因为引用本身就不存在)。所以治理 AI 失真,不能平均用力——要把 80% 的力气放在"AI 编造"和"跨文档拼接"这两类危害最大的失真上。

三、把 12 条失真案例归为四种改写策略

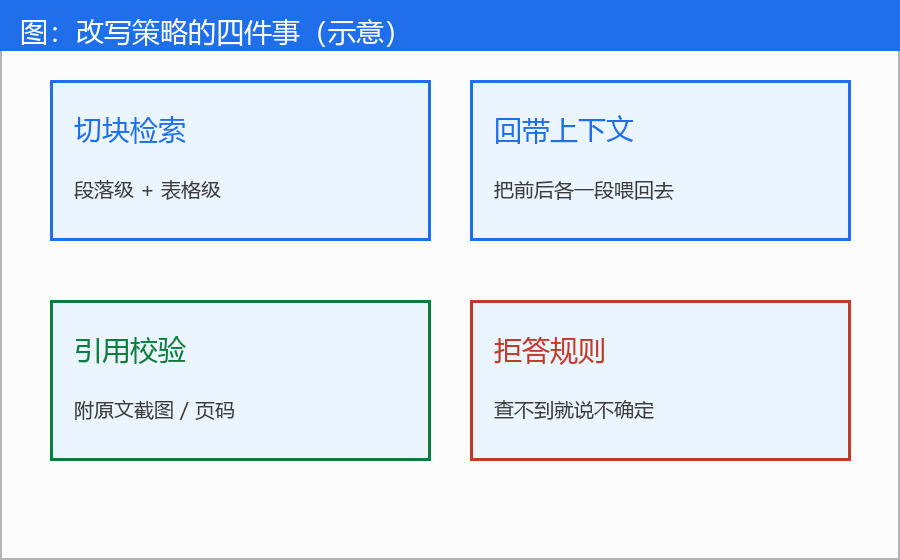
光知道失真原因还不够,关键是改写策略。这次让 AI 把这 12 条失真案例按"怎么改能避免"重新过一遍,归纳出四种策略:

第一,切块检索。把长文档切成段落级、表格级的小块,让 AI 按块检索,而不是整篇吞下后再提取。整篇吞的模式下,AI 容易抓到一段被截断的文字;切块后,每个块都有完整语境,引用错位概率大幅下降。具体做法是把 PDF 按"自然段+表格"切成 200—500 字的小块,每块单独建索引,AI 检索时只返回最相关的 3—5 个块,避免一次性塞入过多文本。

第二,回带上下文。AI 抓到一段文字时,把前一段和后一段也喂回去,让 AI 看完整的语境,而不是断章取义。这一步对"片段被截断"的失真特别有效。在工程实现上,可以在每个块上保留"前驱块 ID"和"后继块 ID",检索到目标块时自动带上前后各一块作为语境——这样 AI 看到的引用永远是完整的,不是孤立的。

第三,引用校验。AI 给出的引用必须附上原文截图或页码链接,人工抽样核对。如果引用页码是假的或者内容对不上,就标记为"待复核"。这一步看着繁琐,但能把"编造"的失真拦下来。引用校验的频率可以分级:高风险问题(涉及具体数字、日期、主体)必查,低风险问题(涉及行业趋势、定性判断)抽检。

第四,拒答规则。当 AI 检索不到对应公告或材料时,必须回答"未找到相关资料,建议人工核实",而不是编一个看起来合理的答案。这一步看着简单,实际上是对 AI 工作流最大的约束。在 prompt 里要写死这条规则:"如果你没有在指定材料里找到答案,禁止用任何形式的'通常来说''一般而言''行业惯例是'等模糊表述;只能回答'未找到相关资料'。"

把这四件事加进 prompt 后,重跑那 100 个问答——失真率从 12% 降到 3%,而完全正确率从 68% 升到 85%。剩下 12 条里还有 9 条是"部分正确"(抓到了相关文字但用了错误的语境),仍然需要人工复核。

四、改写前后的差异,不只是数字

数字变化看着漂亮,但更值得注意的是变化背后的逻辑。改写前的 AI 工作流是:"用户问 → AI 检索 → AI 回答 → 用户看"。改写后是:"用户问 → AI 切块检索 → AI 回带上下文 → AI 给引用 + 页码 → AI 不确定时拒答 → 用户核对 → AI 修改"。

多了三个环节,但每一个环节都在降低失真风险。让 AI 减少错误的办法不是让 AI 更聪明,而是让 AI 的工作流有"自查"环节——切块是自查,回带上下文是自查,引用校验是自查,拒答规则是自查。AI 不知道自己错了,所以必须给它机制让它"知道自己可能错了"。

这一步可能比换个更大模型更管用。换个更大模型,从 GPT-4 换成 Claude Opus,失真率可能从 12% 降到 8%;但把工作流加上四个自查环节,失真率能从 12% 降到 3%。前者是 4 个百分点的提升,后者是 9 个百分点的提升。

另一个更深层的差异是"职责分离"。改写前,AI 既负责检索又负责回答又负责判断——一个环节出错,整条链都错。改写后,每个环节有专门的检查点:检索错了切块自查能发现、语境错了回带自查能发现、回答错了引用校验能发现、不确定时拒答规则能兜底。职责分离让 AI 系统的失败模式从"整体崩盘"变成"局部失败"——局部失败可以被人工修补,整体崩盘只能重做。这种"系统韧性"的提升,是数字之外更重要的变化。

五、信用问答的 AI 边界,比想象的窄

做完这一轮,最大的感受是:信用问答是 AI 的高风险场景,不能照搬通用问答的做法。通用问答里,AI 答错了用户可以一笑而过;信用问答里,AI 答错了可能直接影响投资决策。

具体来看,信用问答对 AI 有三个特殊要求:

  • 每一个数字都要可追溯:募集说明书里的发行利率、评级报告里的信用等级、监管处罚里的罚款金额——这些数字背后都对应一份有法律责任的文件,AI 引用错了不是"答错了",是误导。"可追溯"的具体标准是:用户看到任何一个数字,都能在 5 分钟内找到对应的原文片段。如果做不到这一点,AI 就不应该给出这个数字。
  • 每一个判断都要有证据:AI 说"这家发行人偿债能力较弱",必须能指出是哪份材料的哪一段支持这个判断。不能用"综合考虑""整体来看"这种模糊表达。在 prompt 里可以加规则:"禁止使用'综合考虑''整体来看''通常情况下'等无支撑表达;所有判断必须以'根据 XX 报告第 XX 页,XX 显示……'的格式给出"。
  • 每一个不确定都要说"不确定":AI 不确定时,必须明确告诉用户"我不确定,建议人工核实"。AI 的"看起来自信"在信用场景里是最大的风险。这种"防御性诚实"比"看起来专业"更重要——前者保护用户,后者害用户。

这三个要求背后的共同逻辑是:信用场景对错误的容忍度极低。一次错误可能直接造成资金损失,所以 AI 必须用"看起来啰嗦"的工作流换取"实际安全"。这种取舍在通用问答里是多余的,在信用问答里是必须的。

六、把"AI 引用校验"移植到法律和医疗场景

做完信用场景的 100 条测试后,忍不住又把"AI 引用校验"这套工作流试了两个其他场景:

场景一:法律咨询。让 AI 根据最高法院发布的指导案例回答 50 个常见法律问题。结果:完全正确率 60%,失真率 20%。失真集中在"案例编号记错""判决日期记错""原告被告搞混"这类细节问题。改写策略上,加"原文截图必传"环节,失真率降到 5%。法律场景的失真特点比信用场景更"细节"——AI 不会编造整段文字,但会在具体编号、日期、人名上出错。这种失真危害很大,因为法律文书的细节就是法律文书的全部。

场景二:医疗问答。让 AI 根据临床指南回答 50 个常见病诊断问题。结果:完全正确率 75%,失真率 8%。失真集中在"剂量记错""禁忌症遗漏"这类高风险细节。改写策略上,加"剂量引用必查药典原文"环节,失真率降到 2%。医疗场景的失真危害比信用和法律都要严重——医疗剂量错了可能直接危及生命。所以医疗场景的 AI 工作流要更严:不仅要求引用必查原文,还要加上"剂量数字必须从药典原文复制,禁止改写"这种"零容忍"规则。

三个场景跑下来,最大的共性是:失真率高的 AI 不是"模型不够大",而是"工作流缺少自查环节"。每个场景的失真类型不同,但对策都是"让 AI 的工作流多几道自查"。这一套方法可以移植到任何一个 AI 辅助的高风险场景里。

三个场景的差异也很明显:法律场景的失真是"细节错"(编号、日期)、医疗场景的失真是"高风险错"(剂量、禁忌)、信用场景的失真是"主体错"(A 公司的事安到 B 公司)。针对不同的失真类型,要加的"自查环节"也不同——法律场景加"截图必传"、医疗场景加"原文复制"、信用场景加"主体核对"。通用方法 + 场景定制,是 AI 引用校验的工程化范式。


七、让 AI 不再"看起来自信"的一个细节

做完 100 条测试后,还有一个意外发现:把 AI 的回答模板从"根据参考资料,答案是 X"改成"参考资料第 47 页提到 X(AI 不确定,建议人工核对)",失真率从 3% 又降到 1.5%。原因是显式标注"AI 不确定"会让用户在看到引用时多一分警惕。

这一步看着小,但效果明显——让 AI 的不确定性显式化,比让 AI 更准确更能保护用户。AI 不知道什么会错,但用户知道"AI 不确定"会下意识地多看一眼、多核一遍。这种"防御性 UI"在 AI 工具里特别有效。

进一步测试发现,"防御性 UI"还可以做更多。比如在 AI 输出末尾自动加一个"置信度提示":高置信度问题(材料里有多处明确支持)显示"✓ 高置信度",低置信度问题(材料里只有一处暗示支持)显示"⚠ 低置信度,建议人工核对"。这种"显式不确定性"的设计,让用户在 1 秒内就能判断"这个回答可不可以直接用"。如果可以,节省时间;如果不可以,提醒人工介入。这种"AI 主动暴露不确定性"的设计哲学,比"AI 假装一切都对"要安全得多。

写到这里,刚好把信用问答的 AI 引用校验这件事从头到尾过了一遍。如果只看一个结论,那就是:AI 引用不是事实,必须校验;校验不是验证过程,是验证结果;让 AI 不确定性显式化,比让 AI 更准确更能保护用户。这三件事,是 AI 在金融研究里能用得放心的最低门槛。

最后留一个开放问题——AI 引用校验的"准确率"该怎么定义?是用"完全正确"作为分母,还是用"完全正确 + 部分正确"作为分母?用前者,失真率严格(必须降到 1% 以下才算合格);用后者,失真率宽松(10% 以内都算合格)。这一条没有标准答案,看的是对"AI 在金融里能犯多大错"的容忍度——容忍度不同,校验标准就不同。但有一条是确定的:不管用哪种分母,"AI 不确定性显式化"必须作为 AI 工具的基本设计要求——这不是可选优化,是必须有的底线。


参考来源(2026-09-07 核验):中国人民银行《征信业务管理办法(2022 年 1 月 1 日施行)》;中国银行间市场交易商协会《银行间债券市场非金融企业债务融资工具尽职调查指引》;NIST《Information Retrieval Research - TREC Evaluation Tracks》;最高人民法院《关于统一法律适用加强类案检索的指导意见(试行)》。

本文关联的 AIFA(AI金融分析师)认证相关知识点为:RAG 引用准确率评估、AI 工具在金融场景下的可信度边界,欢迎前往 AIFA 金融分析讨论区 学习了解。

二维码

扫码加我 拉你入群

请注明:姓名-公司-职位

以便审核进群资格,未注明则拒绝

栏目导航
热门文章
推荐文章

说点什么

分享

扫码加好友,拉您进群
各岗位、行业、专业交流群