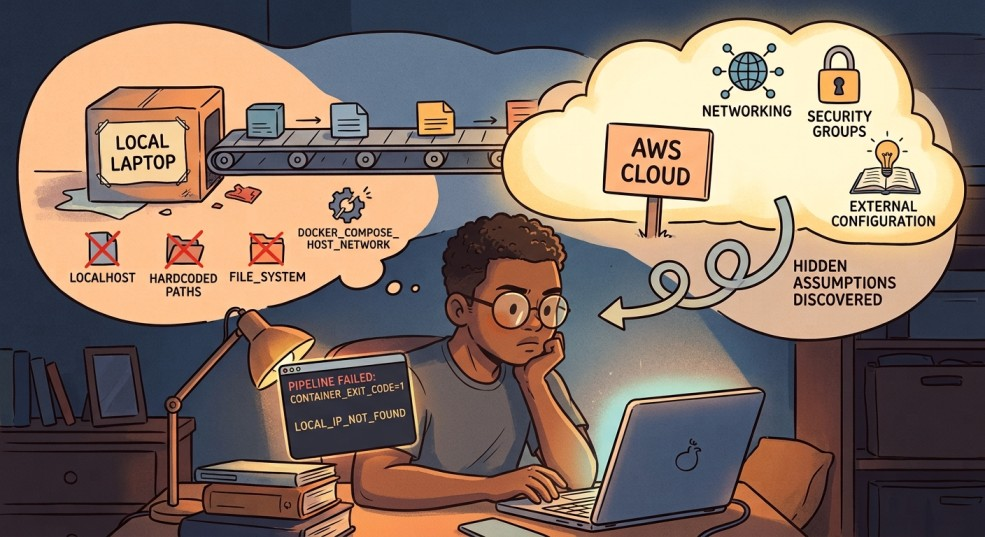
过去几个月,我一直在 Windows 电脑上搭建一套小型数据流水线:WSL2 运行 RSS 数据源抓取程序,Docker 部署 Postgres,Kestra 负责整体工作流编排,dbt 完成数据转换。整套组件在本地全部正常工作:血缘关系图表完好、单元测试全部通过,定时任务可以抓取文章并存入数据库。
一切能跑,仅仅因为所有服务都运行在同一台机器 —— 我的笔记本。
本文记录我只通过命令行,把整套系统迁移到真实云服务器时遇到的各种问题。我原本以为最难的会是 AWS 本身:账号配置、EC2 实例、网络设置。但事实并非如此。真正棘手的,是那些我不知不觉建立在 “全部服务运行于同一台主机” 之上的隐性假设。这些隐含前提默默支撑着整套系统,一旦环境改变,各种故障接踵而至,从中收获的教训远比最初开发这套流水线更多。
配置云服务器
说实话,把服务器跑起来反而是最简单的环节。
我注册 AWS,使用新用户 100 美元免费额度;创建用于 CLI 操作的 IAM 用户,不直接使用 root 账号(这个好习惯帮我避开不少风险),启动一台 Ubuntu 22.04 系统的 t3.small EC2 实例。
过程遇到几个小坑,不算严重,但提醒我:云服务器并不是 “换个地方的本地电脑”。
默认 8G 磁盘空间不足,我还没正式干活磁盘就告急。扩容需要执行growpart与resize2fs。网上教程都提到设备名xvda,但我的实例没有这个设备。新版 EC2 Nitro 实例磁盘命名是nvme0n1。仅仅一个命名差异,就会让第一条命令直接找不到磁盘,你会开始怀疑后面所有指令是否还能生效。
Kestra 第一次拉取 Docker 镜像的时候,实例状态变成 “受损(impaired)”。我判断是内存耗尽,于是创建 1GB 交换文件作为内存缓冲,之后就没有再复现该故障。交换分区利用磁盘充当低速内存后备,内存吃紧时可以把数据置换出去。这件事让我意识到:云租用服务器的内存余量,远不如我的笔记本电脑。
我绑定弹性公网 IP,保证实例启停后外网地址不变;配置安全组,仅允许我自己的 IP 访问 22 (SSH)、8080 (Kestra 网页 UI)、5432 (Postgres) 端口。但家里宽带没有固定公网 IP,每次工作会话开始,我都要先更新安全组放行当前 IP,否则页面完全打不开。
这些操作本身都不难,但充斥大量特定于云主机的细碎知识点,在本地开发时完全接触不到。
迁移数据流水线
服务器安装 Docker。因为代码仓库是公开的,.env里面存放真实密钥,所以我不用 git,改用rsync把项目文件传到服务器,执行docker compose up -d。Postgres 容器正常启动,Kestra 容器也成功运行。
这里踩第一个认知坑:Kestra 的工作流并不保存在同步拷贝的项目文件里,而是存放在 Kestra 的内置数据库中。我写好的fetch_rss工作流,传到服务器之后并不存在,必须手动在 Web 界面粘贴 YAML 定义。
这是后续一系列问题的先兆:我们以为属于 “项目” 的内容,其实分成两类:一类是可以复制传输的项目文件;另一类是运行时系统内部状态,只存活在容器内部。
我点击执行,任务立刻失败。
不存在的工具包
工作流使用 Process 任务执行器完成业务逻辑:构建 Python 虚拟环境、安装依赖、运行 ETL 脚本。这套逻辑在本地笔记本运行毫无问题。
报错提示找不到python3.12‑venv软件包。排查之后我才恍然大悟:Process 任务并不是在 EC2 宿主机运行,而是跑在 Kestra 自身容器内部。容器里虽然有 Python,但是缺少构建虚拟环境的 venv 组件。
我临时进入容器执行apt‑get install -y python3.12‑venv,问题暂时解决。但容器重启之后修改就会丢失,治标不治本。
这时候我得到一条重要经验:编排调度器和实际工作负载不应该混在一起。Kestra 的职责是调度任务、记录状态,不应该还要手动在容器内部安装各种 Python 依赖。如果后续每新增一种依赖,都要重新构建 Kestra 镜像,这会给编排器强加本不属于它的负担。
于是我不再修改 Kestra 本体,改用 Kestra 的Docker 任务执行器。Kestra 会为 Python 作业单独拉起一个临时容器,执行 ETL 脚本,任务结束就销毁容器。思路很合理,但新的麻烦接踵而至。
给调度器一把它未必有权限使用的钥匙
想要 Kestra 拉起独立的工作容器,它必须能够和宿主机上的 Docker 守护进程通信。实现方式是把宿主机的 Docker 套接字挂载进 Kestra 容器:
kestra:
  volumes:
    - /var/run/docker.sock:/var/run/docker.sock
这里有个值得深思的安全权衡:拥有该套接字访问权限,就几乎拥有宿主机上 Docker 的全部权限,可以创建高权限容器。在本地笔记本,我从来没认真思考过风险;但部署在公网服务器上,这是实打实的安全风险。对于本学习项目、低风险单工作流尚可接受,但这种选择应当主动权衡,而不是调试到一半被动撞上。
挂载套接字之后,我修改工作流使用 Docker 任务,指定python:3.12‑slim镜像。第一次测试直接报错:权限拒绝。
虽然套接字已经挂载,但 Kestra 容器内部进程不以 root 身份运行,而该套接字只允许 root 访问。拿到钥匙不等于拥有开门权限。
我在 Kestra 服务配置增加user: "0:0"使用 root 用户运行。踩坑点:仅仅修改 compose 配置文件并不会自动重建容器,必须执行docker compose up -d --force‑recreate kestra才会生效;单纯执行up -d会判定配置没有重大变更,什么都不做。
看似生效、实际无效的数据卷挂载
权限问题解决,任务可以继续往下跑,但又报出新错误:Could not open requirements file: No such file or directory。
我配置把项目目录挂载到工作容器,在宿主机手动执行一模一样的docker run命令,挂载完全正常。但是 Kestra 调用时就找不到文件。这是整个项目耗时最久、也最让人恼火的排错过程。
问题是静默失败:没有报错,没有警告,配置被直接无视。
我先是写错配置项volume‑enabled,之后改成正确驼峰命名volumeEnabled,放到plugins.configurations下,指向 Docker 任务插件完整类名。依旧毫无反应。
最后查明真相:Docker 任务执行器的宿主机文件夹挂载功能,仅 Kestra 企业版可用。我使用的免费开源版本根本不支持该特性。并不是语法写错,而是这个功能版本就没有提供,系统却不会抛出任何提示,直接忽略配置。
⚠️给做同类迁移的开发者提醒:当配置无论怎么检查都完全不生效,先不要怀疑自己语法,确认该功能在你使用的版本中是否存在。
”
真正的正确方案:不要再尝试挂载宿主机目录。Kestra 提供命名空间文件(Namespace Files),是内置小型文件存储。把项目文件一次性上传进去,运行时 Kestra 自动把文件下发给工作容器,不需要访问宿主机文件夹。这才是官方原生支持的方案。
上传文件的过程又踩一堆小坑:我一开始直接发 PUT 请求,但 API 需要 POST 请求,并且把文件作为 multipart 表单上传。提交之后没有返回提示,我以为成功了,实际返回 401 未授权。浏览器已经保存登录凭证,curl 命令却没有;每次 curl 调用都必须带上‑u 用户名:密码。
上传完成后我还要逐个校验文件,曾经出现过文件大小和文件名不匹配的诡异 bug。虽然麻烦,但可以提前发现错误,避免后续脚本运行才爆出莫名其妙的异常。
确认 6 个业务文件全部上传无误,改写工作流,开启namespaceFiles: enabled: true,把绝对路径/workspace/python/…改成相对路径python/…(命名空间文件直接落在容器工作目录)。
脚本终于开始执行,成功抓取 25 篇文章、完成解析,随即报错:
psycopg.OperationalError: connection failed: connection to server at "127.0.0.1", port 5432 failed: Connection refused
这个问题修复最简单,却戳破一个我从未怀疑过的固有认知。
数据库配置写的是DB_HOST=localhost。本地环境一切正常,所有服务在同一台主机,localhost就代表本机数据库。
但 AWS 云环境中,Kestra 的工作任务跑在独立容器内部。当脚本访问localhost,访问的是当前工作容器自己,Postgres 运行在另外一个容器。需要使用 Docker Compose 创建的共享网络,直接用服务名postgres访问数据库。
我把数据库连接信息以环境变量传入工作容器,配置networkMode: rss‑pipeline_default,和 Postgres、Kestra 使用同一个 Docker 网络。至此整条流水线可以从头到尾完整执行:抓取文章、存入数据库,任务圆满跑完。
收尾优化:数据库密码明文写在配置里不安全。Kestra 自带 KV 密钥存储,密码存一次,工作流通过{{ kv('DB_PASSWORD') }}引用,不再明文暴露。项目跑通之后立刻审视安全性,这点非常重要。
故障根源与启示
复盘整个迁移过程,所有故障归根结底分为两大类:
本地能跑,跨容器环境直接失效
数据库就在localhost本机、“我手动装好的 Python 环境一直都在”。在单机本地环境,很多东西被默默隐式处理,你不会把它们当成硬性依赖。一旦拆分成多个隔离容器,这些隐性假设全部失效,问题才暴露出来。
静默失败,没有显式报错
配置参数拼写错误、开源版不支持该功能、接口请求鉴权失败,系统不会直接崩溃,只是默默少做一部分工作。这种情况比直接崩溃更难调试,没有堆栈跟踪,你只能观察业务行为异常,一点点排查哪里没有按预期发生。
给初次做本地项目上云的开发者一条忠告:
把你所有 “本来就该如此” 的本地环境预设,全部当成待验证的命题,不要当成天然成立的事实。如果修改配置后完全看不到任何效果,反复核对语法依旧无效,优先怀疑:你所用的软件版本,根本不支持该功能。
”
后续计划
流水线已经部署完成,可以持续把真实数据写入云端数据库,这是本文最初的目标。
至于下一步怎么做,我还没有完全想好。一个想法是完成闭环,把 dbt 数据转换项目接入云端数据库,实现从原始 RSS 源到清洗完成测试数据集的完整端到端链路。
但说实话,这个项目已经教会我绝大多数想要学习的内容。我从 “搞不懂 Docker 容器”,成长到可以在真实云服务器上排查 Docker 套接字权限、静默配置 bug、容器网络问题。这正是我启动该项目的初衷。再继续压榨同一个项目获取更多知识点,有点像是待在已经不再适合自己的舒适区。
所以我并不确定后续方向。下一篇文章也许会写 dbt 上云,把这个系列收尾;也可能开启全新项目,接触新领域,重新做回新手。与其编造一套自己未必会执行的漂亮路线图,不如坦诚把现状写出来。
无论如何,后续我依旧会如实记录项目,包括踩过的所有坑。
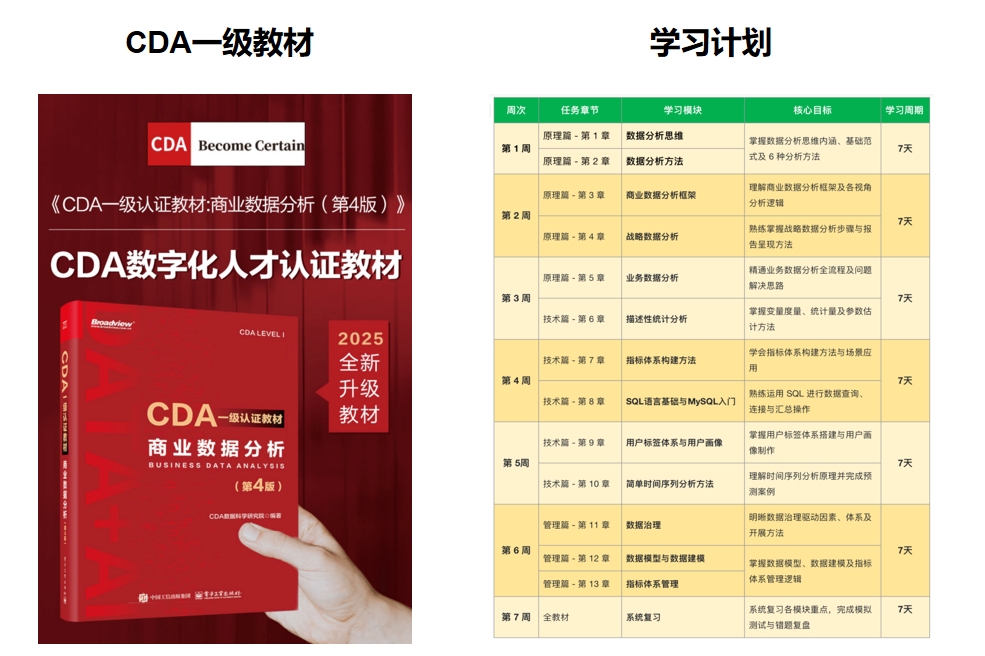
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





