立即打开

一、数据介绍
数据名称:《经济研究》复刻:客户环境关注、压力传导与供应商企业绿色创新。
数据范围:上市公司企业。
时间范围:2012—2025年。
有效样本:供应商企业—客户配对原始样本11,843条。
数据来源:上市公司年报、国家知识产权局、地方统计局及统计年鉴等。
数据内容:本数据以供应商企业—客户关系为切入点,将客户环境关注视为来自市场端的需求信号,考察其如何通过供应链压力传导影响供应商企业绿色创新,并进一步检验客户环境关注驱动的绿色创新能否转化为企业经济绩效。数据依据王红建等(2026)的研究设计和指标构建方法整理,包含原始数据、Stata处理与回归代码,以及完整回归结果。

二、核心研究变量
客户环境关注:以客户所在城市的公众环境关注衡量。客户所在地公众环境关注能够在一定程度上反映当地企业内部人员及其所处社会环境的整体环境关注程度;数值越大,表示客户环境关注越强。
供应商企业绿色创新:以供应商企业绿色专利申请量衡量,包括下一期集团绿色专利申请总量、下一期集团绿色发明专利申请量和下一期集团绿色实用新型专利申请量;专利申请量越大,表示绿色创新活动越多。
压力传导:通过客户集中度、低行业赫芬达尔指数、供应商—客户关系年限、第一大客户身份等变量及其与客户环境关注的交互项,检验客户环境关注沿供应链向供应商企业传导压力的机制。
经济后果:以供应商企业下一期净资产收益率和下一期托宾Q衡量客户环境关注驱动绿色创新后的财务与市场绩效。
三、数据指标
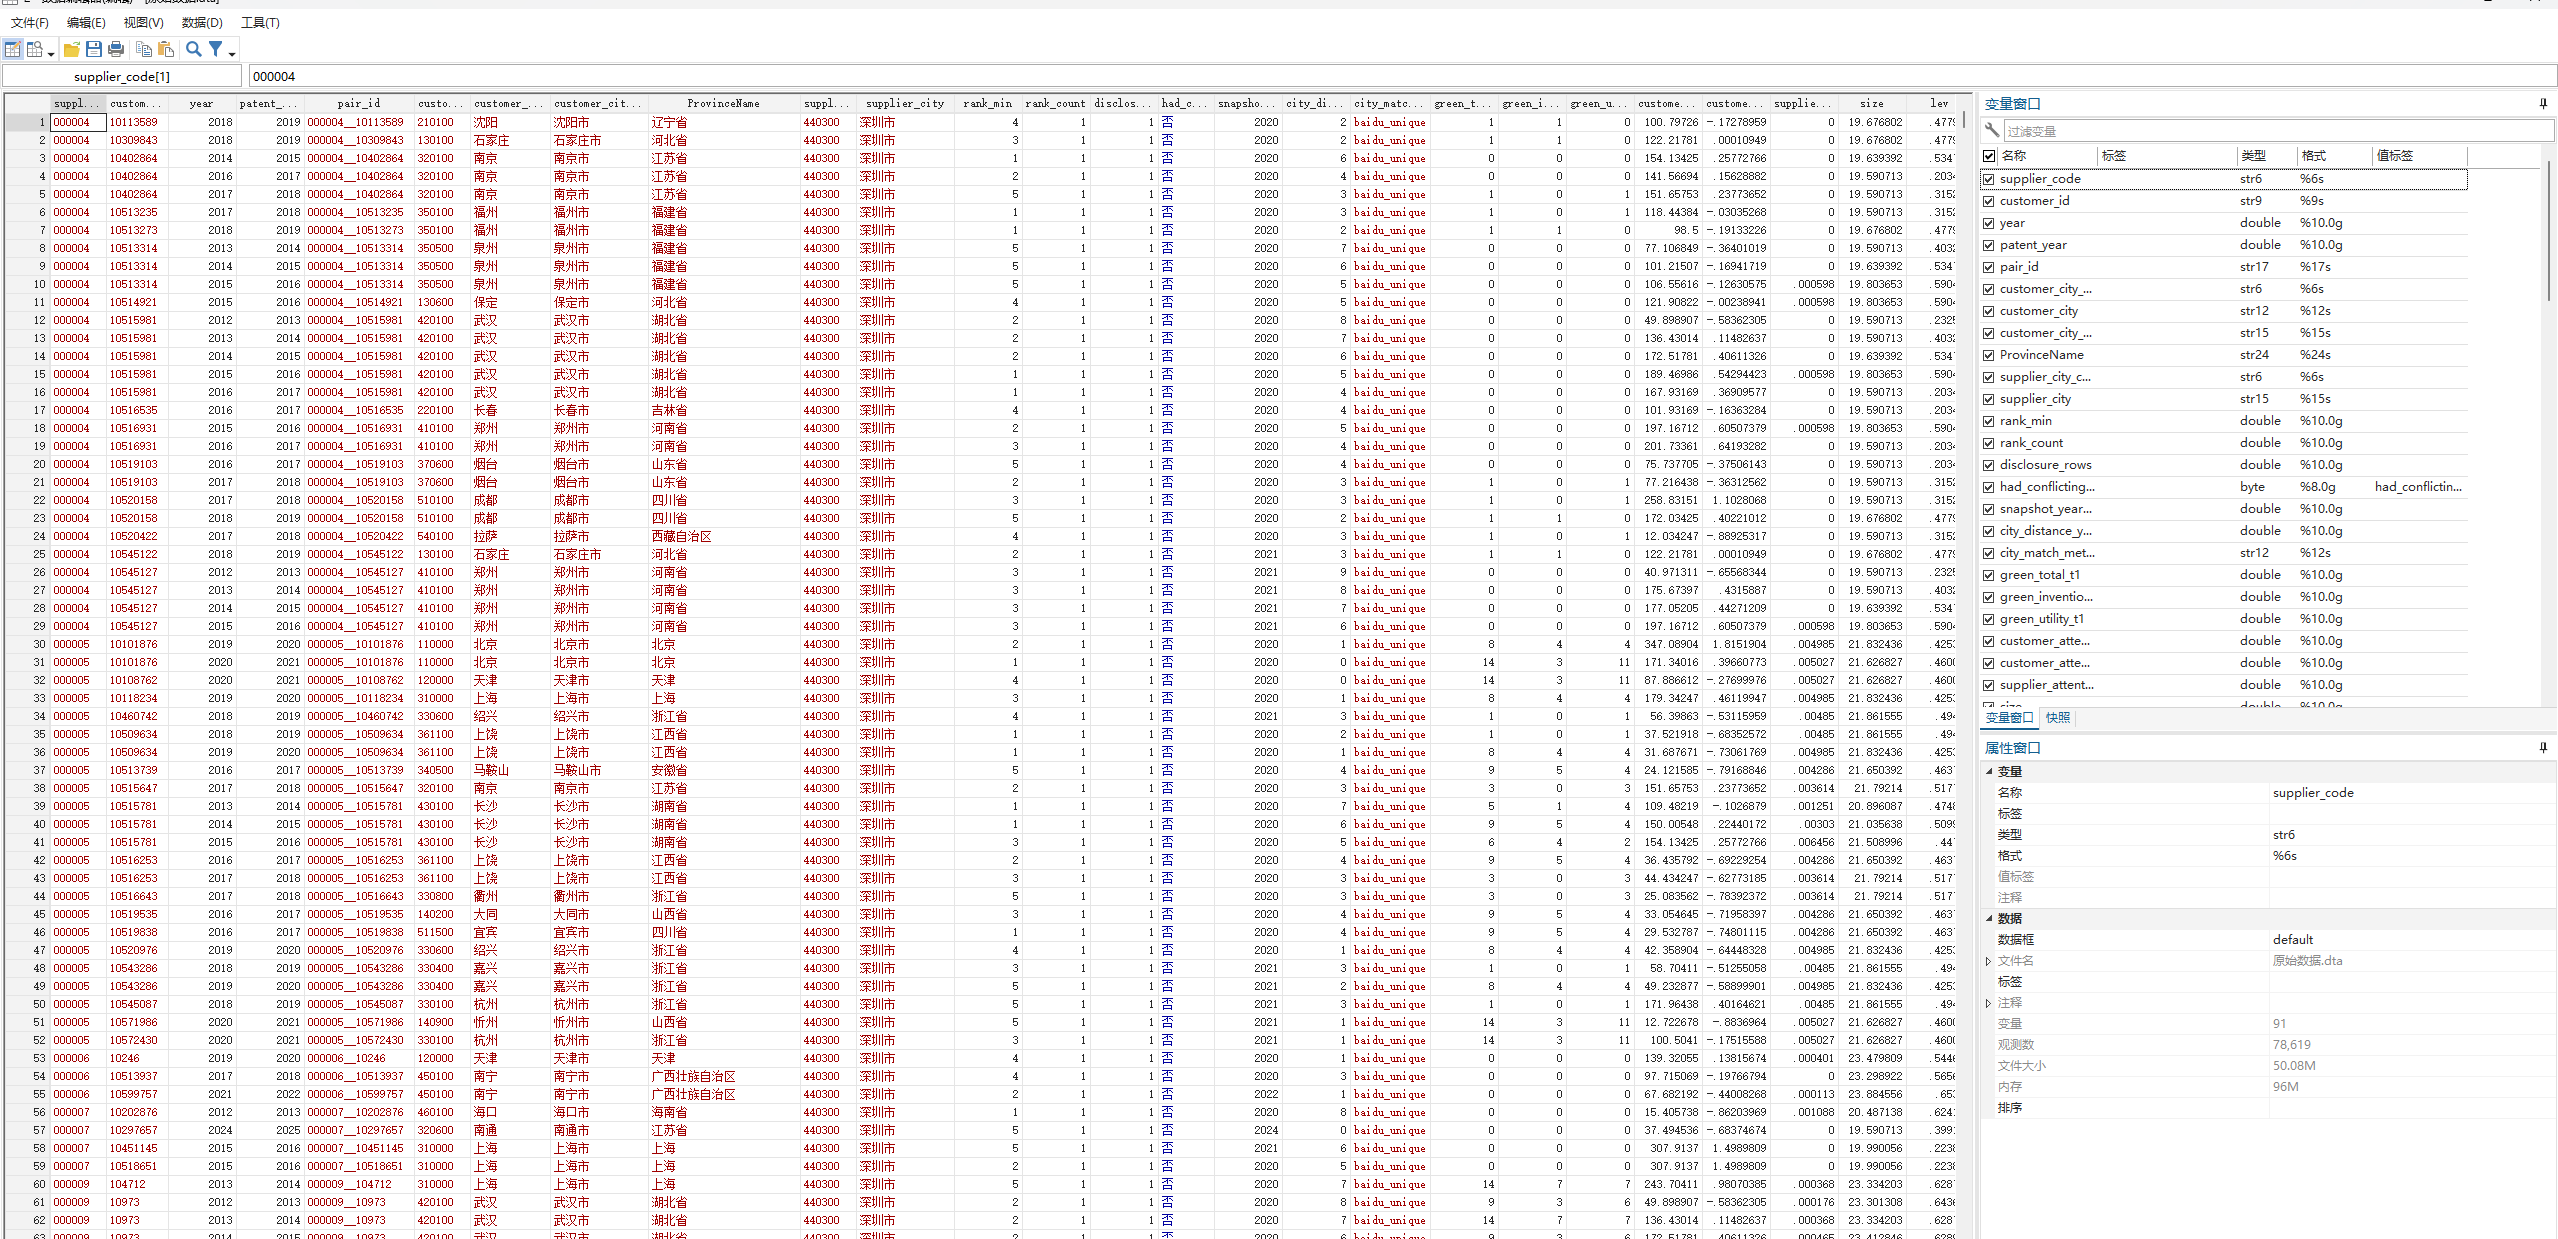
供应商上市公司代码:supplier_code,供应商企业证券代码。
客户机构识别码:customer_id,客户机构标识。
年度:year,供应商—客户关系当期年度。
专利结果年份:patent_year,绿色专利结果的匹配年度;配对样本中为year+1。
供应商客户配对ID:pair_id,供应商企业与客户的配对标识。
客户城市代码、客户标准城市名、客户原始城市名、客户省份:客户所在地地理信息。
供应商城市代码、供应商城市:供应商所在地地理信息。
客户披露最小排名、客户披露排名数、合并前披露行数、披露是否存在冲突:前五大客户披露信息整理字段。
客户城市快照年、城市快照年距、客户城市匹配方式:客户所在城市识别与匹配信息。
下一期集团绿色专利申请总量、下一期集团绿色发明专利申请量、下一期集团绿色实用新型申请量:供应商企业下一期绿色创新结果变量。
客户环境关注原始代理、客户环境关注标准化值、客户环境关注、下一期客户城市环境关注:客户环境关注及其变换、滞后/前瞻指标。
供应商自身环境关注、供应商企业环境关注:供应商环境关注控制与替代机制检验变量。
企业规模、资产负债率、总资产收益率、固定资产比例、经营现金流、营业收入、成长能力、资本密集度、企业成立年限、机构投资者持股比例、第一大股东持股比例、董事会规模、董事长总经理两职合一:供应商企业财务与治理控制变量。
供应商城市人均GDP(对数)、供应商城市第二产业比重、供应商城市环境规制、客户城市环境规制、客户城市互联网发展代理、客户城市教育水平:供应商和客户所在地经济社会控制变量。
工具变量:孔庙数乘以ln(1+省级光缆长度),对应变量temple_fiber_iv,用于客户环境关注的工具变量与控制函数检验。
客户集中度、供应商—客户关系年限、客户为上市公司、客户股票代码、客户当期绿色专利申请总量、供应商行业代码、低行业赫芬达尔指数、供应商与客户同省、供应商属于重污染行业、客户属于重污染行业:机制、异质性与替代性解释检验变量。
下一期净资产收益率、下一期托宾Q:经济效应结果变量。
上市客户企业规模、上市客户资产负债率、上市客户总资产收益率、上市客户固定资产比例、上市客户经营现金流、上市客户营业收入、上市客户成长能力、上市客户资本密集度、上市客户企业成立年限、上市客户机构投资者持股比例、上市客户第一大股东持股比例、上市客户董事会规模、上市客户董事长总经理两职合一:上市客户样本扩展检验的客户特征变量。
样本类型、该类样本原始行序、金融行业标记、ST状态标记、供应商简称、行业来源可观测标记、行业来源年份:数据存储、样本识别与清洗字段。
企业所在城市环境关注原值、企业所在城市教育水平、城市环境规制、企业所在城市互联网代理、企业所在城市人均GDP对数、企业所在城市第二产业比重、城市公众环境关注、至少披露一名前五大客户的名称、当期集团绿色专利申请总量、当期集团绿色发明专利申请量、当期集团绿色实用新型申请量:指标有效性、样本选择与反向因果检验字段。

四、文件说明
原始数据.dta:包含供应商企业—客户配对、供应商企业—年度和供应商企业—年度绿色专利三类逻辑样本的Stata数据文件。当前文件共78,619条记录,使用sample_type区分不同逻辑样本;其中供应商企业—客户配对样本为11,843条。
计算代码.do:Stata 18复刻代码。代码从原始数据.dta恢复三类逻辑样本,依次执行基准回归、指标有效性、反向因果、双重差分、工具变量控制函数、双重机器学习、高维固定效应、样本选择、机制、替代性解释和经济效应检验。
回归结果\描述统计.csv:主要变量的描述性统计结果。
回归结果\全部回归系数.csv/.dta:全部模型的系数、标准误、p值、样本量及拟合指标汇总。
回归结果\模型状态与拟合优度.csv/.dta:各模型的估计方法、运行状态、样本量、固定效应、聚类和覆盖年份信息。
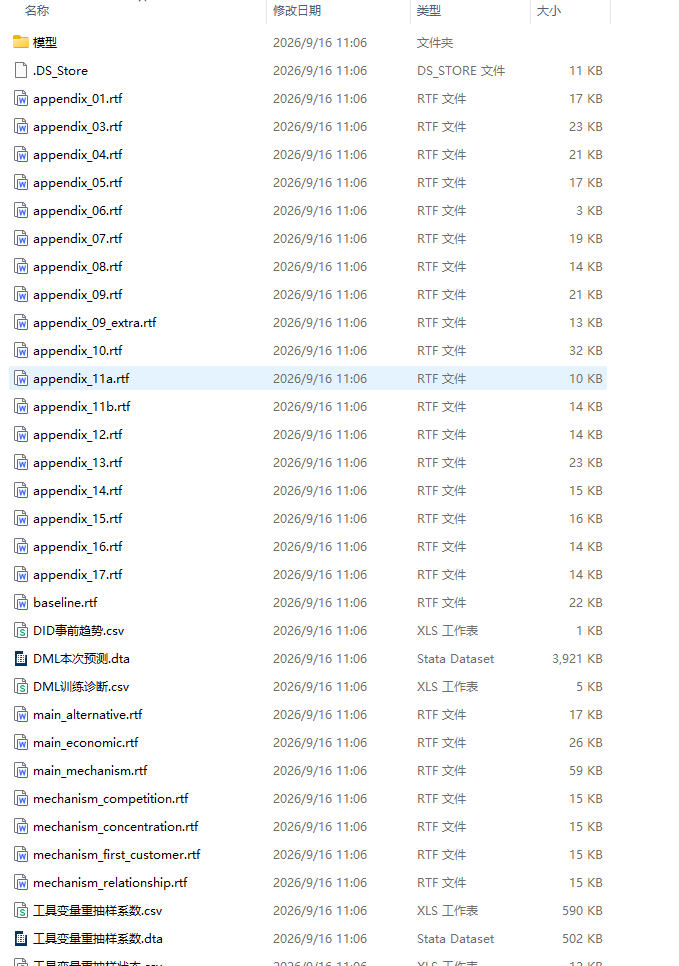
回归结果\baseline.rtf、appendix_*.rtf、main_*.rtf、mechanism_*.rtf:基准、附录、机制、替代性解释和经济效应回归表。
回归结果\DML训练诊断.csv、DML本次预测.dta、DID事前趋势.csv、工具变量重抽样系数.csv、两阶段重抽样系数.csv及相应状态文件:双重机器学习、双重差分和两阶段重抽样输出。

五、参考文献
[1] 王红建、张高昂、吴涛等. 客户环境关注、压力传导与供应商企业绿色创新[J]. 经济研究, 2026, 61(1): 72-94.
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
相关推荐
栏目导航
热门文章
推荐文章
 扫码加好友,拉您进群



 全部版块
 我的主页


 收藏