立即打开
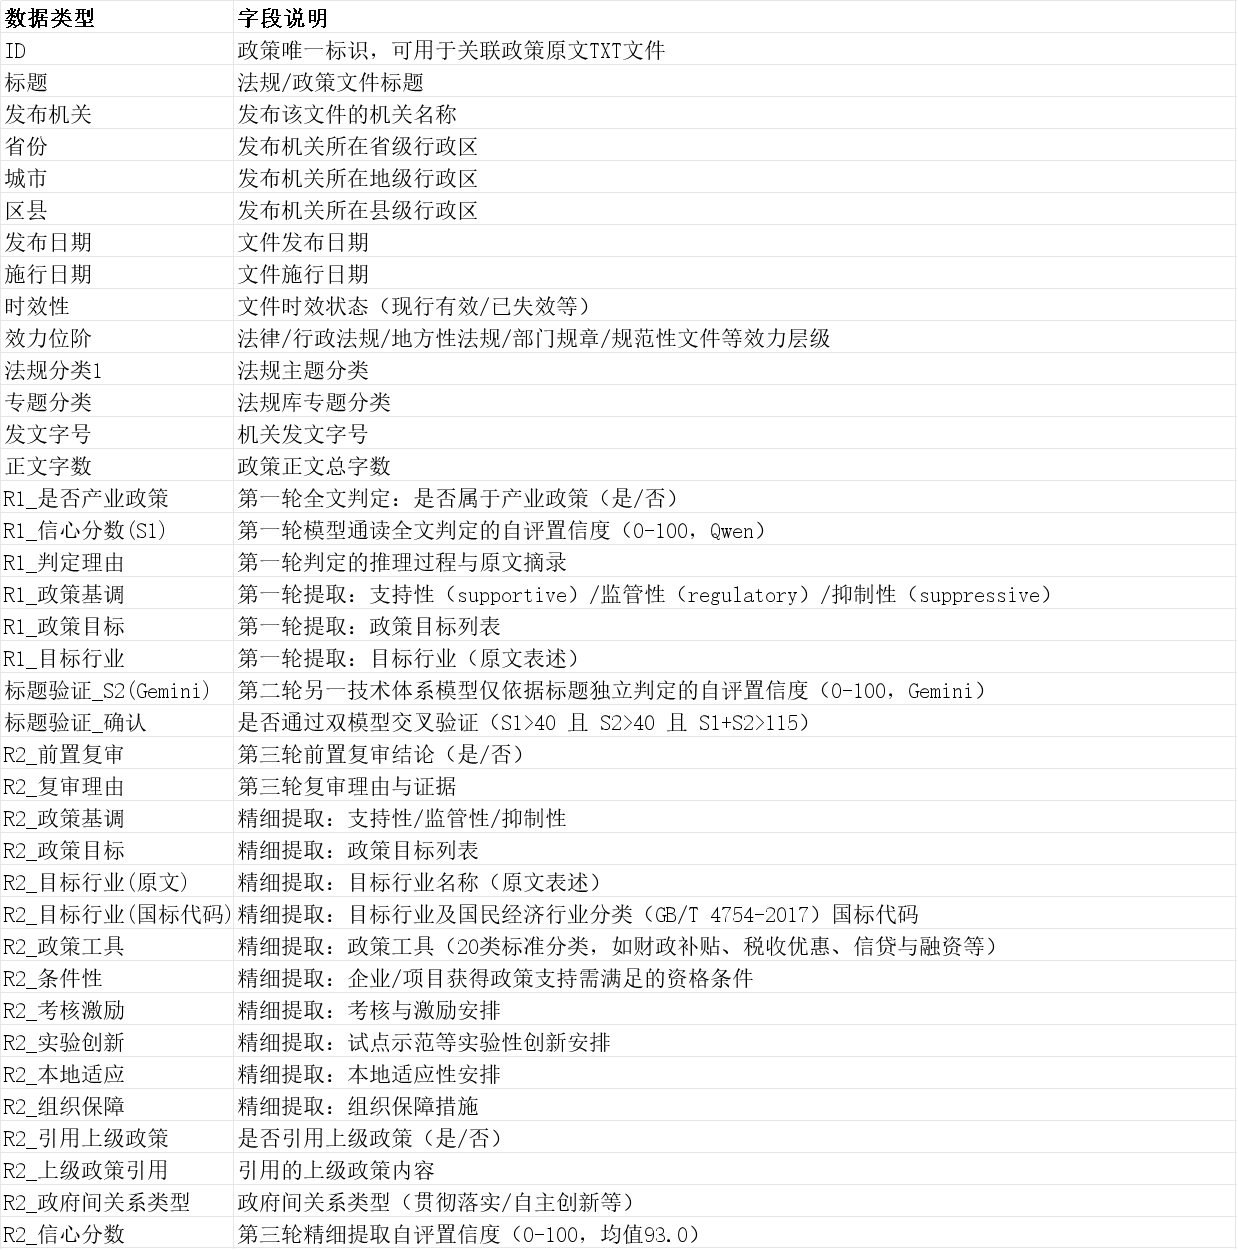
中国产业政策文本数据基于大语言模型(LLM)技术,对五百多万条全量法律法规文档逐条识别、结构化提取而成,覆盖1949-2025年中央、省、市、县(区)各级政府发布的各类产业政策文件,共识别产业政策约63.8万条。每条记录除保留标题、发布机关、发布日期、效力位阶、发文字号等法规原始信息外,还提取了政策基调、政策目标、目标行业(含国民经济行业分类代码)、政策工具、资格条件、组织安排、政府间关系等20余个结构化维度,并配套政策原文TXT(通过ID字段关联),形成"结构化数据表 + 政策原文"的完整数据集,可直接导入Stata、R、Python进行分析。
置信度分级,按需筛选
- 每条政策附三个模型置信度字段(S1全文判定、S2标题判定、R2精细提取,取值0-100),全部判定均附原文摘录与推理过程、逐条可追溯。研究者可通过「标题验证_确认」「R2_前置复审」等字段按需筛选不同置信层级的样本:
- 全量识别结果(约63.8万条):覆盖面最广、召回率最高,适用于政策数量统计与长周期趋势分析。
1.时间区间
1949-2025(有效数据集中在2007-2024年)
2.字段展示

3.样本下载(正式数据的一部分)
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
栏目导航
热门文章
推荐文章
 扫码加好友,拉您进群



 全部版块
 我的主页


 收藏