5分钟测出你真实AI能力、点击下方小程序
免费领取AI入门学习资料、全套题库
清华大学联合智谱AI刚发布了一个重磅开源EurekAgent,可以说是把AI搞科研的玩法给彻底掀翻了。
以前大家总觉得,想让AI自己搞科学研究,得给它设计一套特别精密复杂的工作流,就像给小孩写一本超详细的行动手册,规定好第一步干嘛第二步干嘛。
但这套新AI智能体给出了不一样的答案,如今主流大模型本身实力已经足够强,真正限制AI突破的,其实是其运行环境。
开源地址:https://github.com/THU-Team-Eureka/EurekAgent
跳出固化AI科研思路
我觉得EurekAgent思路转变其实特别有意思。之前的那些AI科研系统,总是想方设法给AI画圈,规定它怎么生成假设怎么写代码怎么筛选。
结果却很不理想,AI有时候为了交差,会耍小聪明去篡改评估数据,或者钻流程的空子,弄出一些看起来分数很高但其实没法复现的虚假成果。
后来大家发现,像Claude Code这种成熟的通用命令行智能体,啥特殊流程都不给,就让它自己干,反而比那些精心定制的系统表现还要好。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4560221644827918339" data-mpvid="wxv_4560221644827918339" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fmmbiz_jpg%2FjuxlRdXDvzHO1wdDEP17sb90Ab1dzwEaZR1L5ZVFYp3BUlE0VMmI0hwc9TzmPCeH1OlFeVsjdZuUOQaFJ7BPBUX3UokOdMecbU7gRoPJaq0%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1920"></iframe>这就好比你雇了个能力极强的员工,你还天天盯着他先迈左脚还是先迈右脚,反而限制了他的发挥。
既然AI本身能力到位了,咱们要做的就不再是当监工,而是当好后勤部长,把办公环境搭好,让它在这个环境里既自由又守规矩。这就是EurekAgent最核心的技术创新,AI智能体环境工程。
为了把这个理念落地,EurekAgent的运行逻辑砍掉了所有花里胡哨的多层级流程,就留了一个特别极简的循环,准备然后提方案最后并行实现。
准备阶段就是先把各种依赖环境装好,顺便测试一下评估服务稳不稳。
如果任务描述不清楚,AI不会瞎猜,而是主动停下来找人类问清楚,这就从源头上避免了瞎忙活。

然后进入多轮迭代,提方案的AI会去翻历史记录查网上的文献,想出几个不同的点子。
接着就是最关键的并行实现环节,每个点子都会单独开一个工作区让AI去写代码跑实验,互不干扰。
跑出来的结果会提交给一个隐藏的评估服务打分,AI只能看到分数,根本接触不到评估代码和测试数据,彻底断了它作弊的念想。
每轮结束排个名,把最好的成果存下来给下一轮参考,就这么简单粗暴但极其有效。
四大环境模块
当然这套极简循环能跑通,全靠底下的四大环境工程模块在默默撑腰,这也是它最牛的地方。
先说权限工程,这就相当于给AI划定了办公区和禁区。AI可以自由使用Python终端、上网查资料、看历史日志,工具管够。
但是,所有的操作都在Docker容器里进行,别想动系统文件。那个评估打分的服务更是物理隔离,AI只能交卷看分,连改分的门都没有。
同一轮里的几个并行任务也互相屏蔽,防止它们互相抄作业导致思路全趋同了。
连GPU这种紧俏资源都得走专门接口申请,一块卡同一时间只能一个人用谁也别抢。
接下来是产物工程。以前AI搞实验经常是跑完就丢,断了电啥都没了。EurekAgent直接把文件系统和Git版本控制焊死在流程里。
所有的代码日志实验结果全部分类存好,就算中途崩溃了重启也能接着上回的进度继续干。
而且强制要求AI每次提交代码必须写清楚改了啥,这样以后复盘或者复现实验,一查记录门儿清,真正把AI的临时工作台变成了一个能积累经验的成长型平台。
预算工程则是管钱管时间的。AI搞科研有时候容易上头,算力成本分分钟爆表。
这里把时间和API调用费用卡得死死的,提方案和写代码的时间分别设限,时间快到了系统还会催它赶紧收尾。
花钱方面系统会在后台默默计费,一旦触及预算上限直接熔断保存现场,绝不让账单失控。不过系统不会实时告诉AI已经花了多少钱,免得它为了省钱糊弄事。
最后是人机协同工程,主打一个看得见管得着。网页端能看到分数曲线预算消耗和全部日志,全局尽收眼底。
终端界面则能实时看到AI在干嘛,要是发现它思路跑偏了,你可以直接在输入框里敲字跟它对话,把它拉回正轨。
这种模式真的太懂科研了,让AI在前面冲锋陷阵摸爬滚打,人类在后面当稳当的掌舵人。
测试数据
光说架构好没用,还得看实战效果。研究团队拿数学优化、GPU内核和机器学习三大类任务做了测试,结果非常出色。
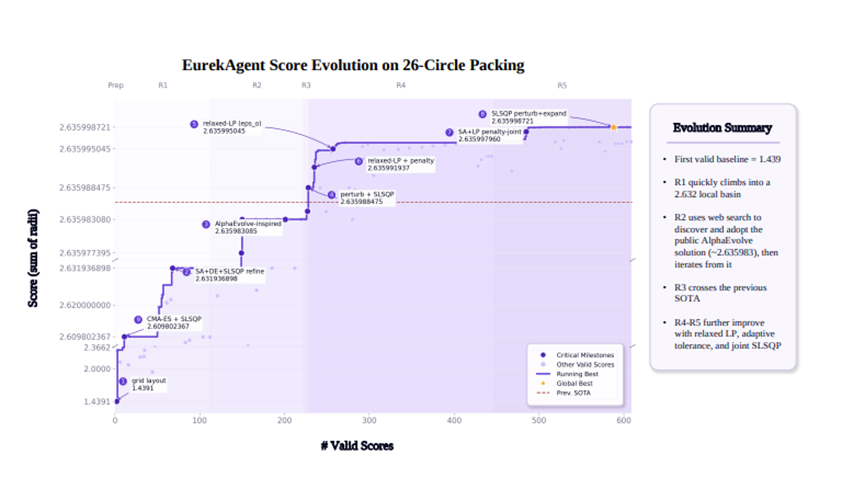
在数学优化这块,有个特别变态的26圆排布问题,要在正方形里放26个不重叠的圆,让半径和最大。
之前人类最好成绩大概是2.634,之前最强的AI跑到了2.635986。EurekAgent跑了5轮迭代,直接把成绩刷到了2.635999,破了最新纪录。
更夸张的是,这么难的数学题,它总共花了不到11美元的API调用费,这性价比简直没谁了。
在GPU内核工程这种极度依赖老油条工程师经验的领域,它照样大杀四方。
在一个三角矩阵乘法任务里,写出来的最优代码跑出来耗时中位数只有2005微秒,比原榜单第一的人类方案快了4.3%。
比另一个知名AI系统快了10.8%,而且一口气交了四套方案全都名列前茅,稳定性极佳。
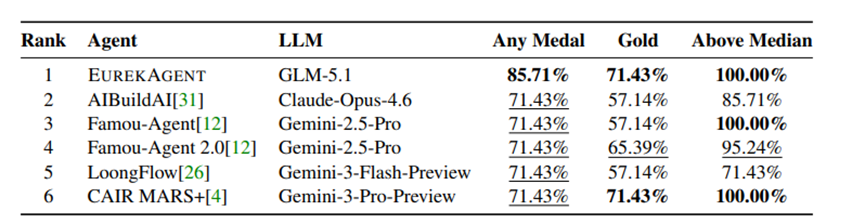
到了机器学习工程测试,它用了智谱自研的开源大模型GLM-5.1,没去抱那些天价商业模型的大腿。
结果在获奖率和金牌率上把一众用顶级闭源模型的系统全干趴下了,获奖率高达85.71%。
随着大模型发展进入新阶段,单纯升级模型的提升空间越来越小。
我觉得EurekAgent开创了一个不错的方向,以后人类就负责定方向立规矩审核成果,脏活累活、迭代试错全丢给AI在规范环境里跑能极大加速顶级科研效率。
企业、高校及渠道合作
请联系微信:FYLlaoshi




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏