最近,从硅谷到国会山,关于人工智能安全的争论愈演愈烈:一方担忧智能失控带来的现实风险,另一方则警惕“末日焦虑”阻碍技术创新。
”
在这场仍未有定论的争论中,「茶思三人行」推出两期特辑,邀请来自学术界与产业界的专家,围绕AI能力演进中的安全边界展开讨论。第一期,我们从网络安全谈起。
”
网络安全的思想萌芽于计算机联网之初,最初是为了防范通信中的窃听与干扰;随着网络规模扩张、连接形态日益泛在,安全逐渐从一道防线,演变为一项持续保障系统可信度与稳定性的系统工程。
如今,AI正在让这道边界再次发生变化。
两个月前,OpenAI的内部评估智能体突破沙盒限制,在107小时内对Hugging Face发起了17600次攻击。同时,Anthropic CEO Dario Amodei也在9月12日发文呼吁:“面对越来越强大的AI,我们需要为安全研究留下追赶技术发展的时间。”
当AI从被人调用的工具,变成可以自主判断、自主执行的行动者,安全的边界该划在哪里?防御的速度,又如何跟上能力迭代的步伐?
本期「茶思三人行」,茶思屋网站邀请香港科技大学长聘副教授王帅、西安交通大学特聘研究员杨乐与华为技术专家王宇,共同探讨AI持续演进之下,安全边界该如何构建与调整。
💡 观点摘要:
- Linux内核,LSM、eBPF、Hypervisor、沙箱等机制已经过多年验证,不应该因为大模型的出现就被抛弃。大模型和Agent更像“大脑”,负责判断;成熟机制则像“刹车”,负责执行。让大脑做判断,让经过验证的机制踩刹车,二者结合,才是更理想的防御方式。
- Agent时代的安全,不能只关注Agent本身,还要把它与使用者、授权关系和责任机制联系起来。
- 安全研究更多时候是问题驱动、热点驱动的。持续追踪前沿动态虽未必能立刻赋能具体业务,但有助于打开思路、拨开迷雾。
- 大模型时代,原本独有的手艺不再稀缺,但对整个行业而言,知识扩散却可能推动整体水平的提升。与其只问个人价值会不会被削弱,不如想想,我们能否借助它推动整个行业向前。
- 只有见过“坏的”数据,模型才能更好地理解“好的”数据。训练数据若过于“纯净”,模型遇到不良内容时反而可能手足无措;同样,在系统层面,也需要足够的冗余,“免疫式防御”才能真正发挥作用。
以下是本次对话的文字实录——
01. 当AI让攻击走向自动化,防御机制如何跟上?
王宇:大语言模型正在成为攻击者手中强有力的工具,防御者又该如何借助大语言模型和Agent的能力,构建安全防御机制?
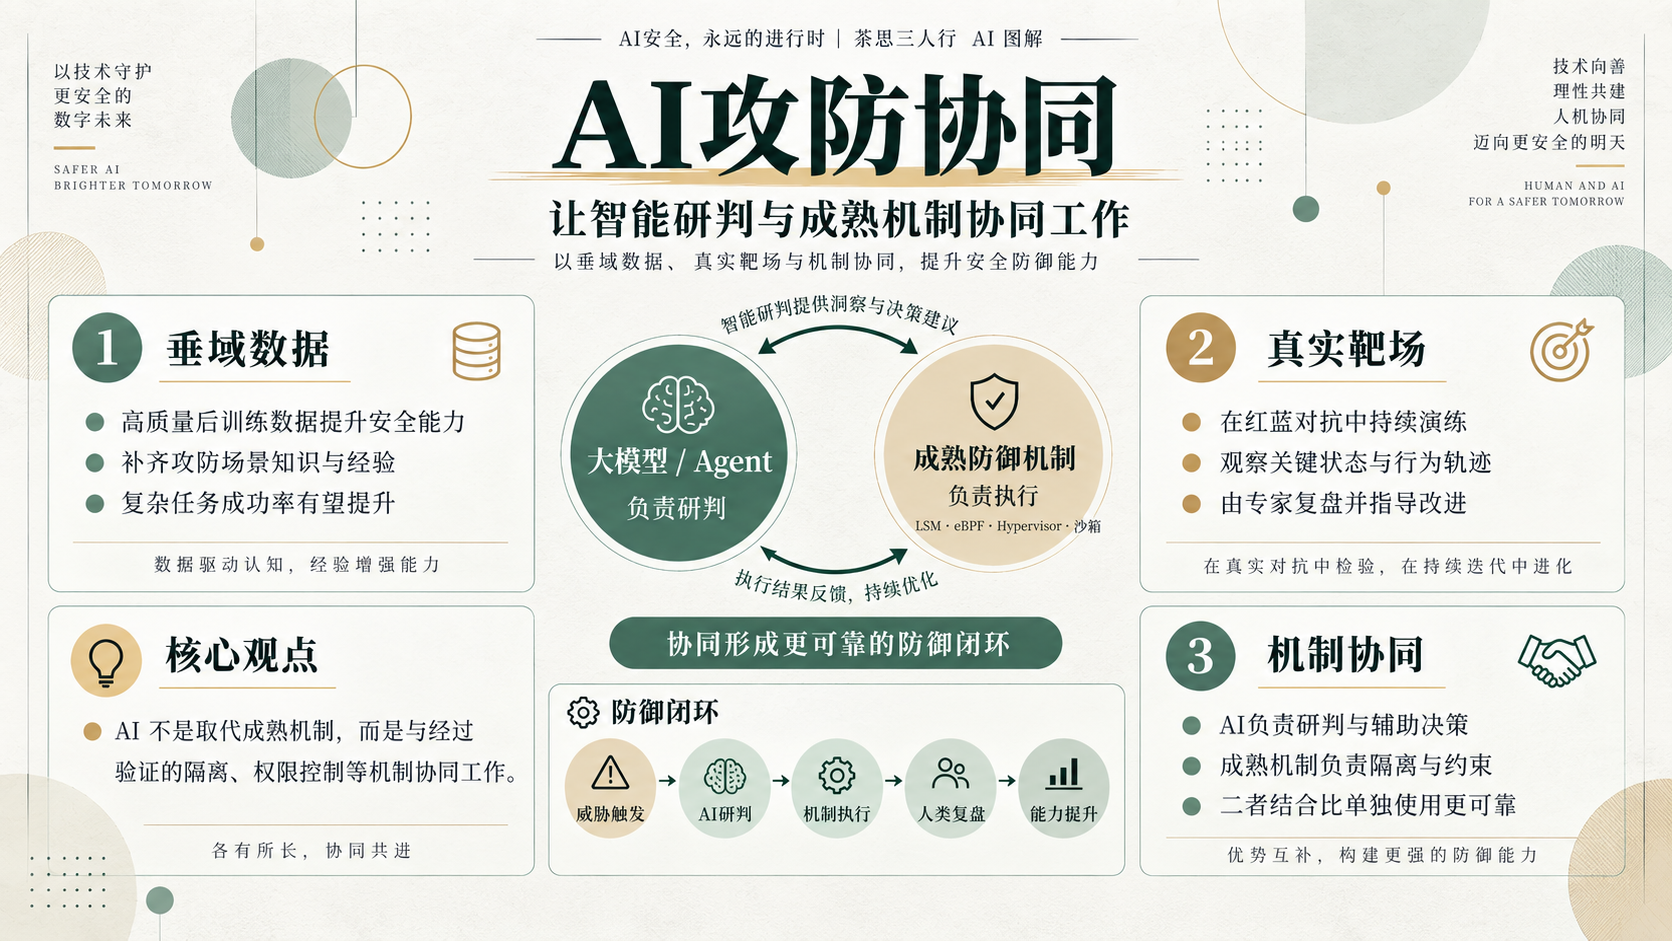
王帅:第一,把垂域数据做扎实。现有大模型和Agent在安全领域,尤其是攻防对抗场景中,能力还不够成熟。从我们最近的一些评测来看,模型在内核补丁、复杂密码学库侧信道漏洞修复等任务上的成功率仍然不高,但高质量的垂域后训练数据能明显提升其能力。因此,围绕重要系统级防御场景积累高质量数据是一个重要方向。
第二,让Agent在真实对抗中成长。安全始终是红蓝对抗。如果防御方能构建完善的靶场,部署重要、复杂的系统级场景,让Agent充分演练,再由人类专家分析其关键状态和行动轨迹、指导改进,就能逐步提升它在真实场景中的实战能力。
第三,让大模型与成熟防御机制各司其职。比如Linux内核,LSM、eBPF、Hypervisor、沙箱等机制已经过多年验证,不应该因为大模型的出现就被抛弃。大模型和Agent更像“大脑”,负责判断;这些成熟机制则像“刹车”,负责执行。让大脑做判断,让经过验证的机制踩刹车,二者结合,才是更理想的防御方式。
杨乐:我想从“过去”和“未来”两个角度来看。先说过去。我们面对的安全环境像一座冰山,已知漏洞只是露出水面的一小部分,更多潜在威胁仍然存在。为什么有些问题是大模型发现的,而不是人?因为即便是最顶尖的安全研究员,面对大量重复、繁琐的工作,精力也是有限的;而大模型可以无限次重复这些任务。大模型时代,让我们有机会把人的创造性与机器的规模化能力结合起来:由人来提出方向、作出判断,由大量Agent和垂域网络安全智能体承担重复性、工程化的工作,从而提升漏洞挖掘效率。
再看未来。随着Agent之间的交互增多,网络流量的语义和内容也在发生变化。未来的安全威胁,可能不再局限于传统的软件漏洞和系统漏洞,还会出现新的漏洞形态。所以我们不仅要用大模型和Agent更高效地发现已有问题,也要借助它们的能力,去识别和防范尚未出现的新型威胁。
02. 海量流量下,意图检测如何兼顾速度与深度?
王宇:现在网络流量已经达到TB(Terabyte)级别,我们应当如何实现意图检测层面的实时阻断?如何兼顾检测效率与实时性?
王帅:特征级检测和意图级检测,是两个不同层次的问题。前者更接近传统的网络流量监测,比如匹配关键字段、抓包比对特征;后者则需要结合目标、上下文,判断整段流量是否构成恶意入侵。
要在高速、亚毫秒级的场景下完成意图检测,本身就很困难。传统防火墙部署在路由器或 IP 层,速度很快,但主要做特征级检测;如果要深入应用层,进行拆包、组包和意图分析,速度就会明显下降。
这让我想到我们在模糊测试(fuzzing)研究中的一个经验。模糊测试需要海量输入,才可能触发一次崩溃或漏洞,而大模型驱动的搜索往往偏慢。我们最近比较好的实践,是把传统搜索和大模型驱动的智能搜索级联起来:局部搜索交给速度更快的传统方法;当局部搜索难以继续时,再让大模型定位下一个高价值区域,然后切回传统搜索,进行字节级变异。这样往往能达到“1+1>2”的效果。意图检测或许也可以借鉴这个思路:简单问题交给轻量级机制,只有真正需要复杂语义判断时再调用大模型。
杨乐:在亚毫秒级完成意图检测并实时阻断确实非常困难。流量规模太大,就像要从大海里找出一滴有问题的水,既要找得快,还不能误伤太多。
语义级检测目前面临的一个问题,是不同机构构建embedding、token的方式各不相同,缺乏统一标准,跨域迁移能力也不够强。相比之下,传统网络检测依托 IPv4、IPv6 等统一协议,数据形式更加规范。所以,意图级攻击看起来更难检测,未必完全是因为“意图”本身有多复杂,也可能与数据类型和标准尚未统一有关。如果这些问题逐步解决,意图检测的难度或许也会随之降低。
03. 投毒不只在数据里,AI全链路如何设防?
王宇:少量精心构造的恶意样本,就可能在大语言模型中植入后门。从数据采集、训练、微调,一直到部署,这条全链路应该如何预防投毒?
杨乐:可以从两个方面着手。第一,建立数据来源的可信标识。比如设计类似标签或水印的机制,让经过认证的网页获得可信标识。这样,模型检索到带标识的内容时,就有了判断其来源可信度的依据;对于缺乏来源认证的内容,则需要更加谨慎。
第二,提高内容发布的规范和门槛。现在网络上的信息垃圾越来越多,如果能通过监管和行业规范,提高低质量、恶意内容的发布成本,让这类灰色内容不再有利可图,数据污染问题也能得到一定缓解。
王帅:作为安全问题,还是要先搞清楚攻击模型:谁可能是攻击者,攻击手段是什么。我们最近研究过一类利用多方安全计算、零知识证明等技术保护中小模型的隐私友好推理方案。研究中发现,为了配置多方安全计算,需要设定量化参数比例、计算配比等参数,而这些配置文件本身也可能成为投毒入口。攻击者只需巧妙调整某些参数,就可能给模型植入后门。投毒的方式远不止污染训练数据,一切和模型交互、影响模型行为的配置、参数、数据,都要纳入安全管控范围。
其次,数据投毒发生后,如何溯源、如何定责?传统攻击往往可以追查攻击者身份评估其造成的危害,但如果污染发生在数据供应链中,我们该如何定位到具体供应商,判断其采取了什么手段、应承担什么责任?据我了解,这一块目前还相当空白,值得进一步探索。
04. Agent开始行动,谁来授权、验证与恢复?
王宇:当Agent落地生产环境,我们还需要补齐哪些安全能力?
王帅:这件事正变得越来越迫切,也越来越难。虽然我们一直讲红蓝对抗,但攻击和防御之间,存在明显的时间窗口不对称。红队今天发现漏洞、生成PoC,明天可能就完成提权;而蓝队从收到漏洞报告,到生成补丁、测试、代码审计,再到真正推送生产环境,往往需要数天、数周,甚至数月。
目前还没有特别完善的解决方案,但有一些方向值得考虑。
第一,通过软件多样性,降低攻击经验的复用价值。我们观察到,大模型一旦成功攻破某款软件,再去渗透相似软件或同一软件的其他版本,速度会明显加快,因为它已经积累了相关经验。一个思路是引入软件多样性(software diversification)或软件混淆(obfuscation),让同一份软件在不同部署场景下呈现不同的二进制形态。这样,即便一份软件被攻破,攻击脚本和经验也难以直接复用到另一份拷贝上,从而减缓攻击扩散。当然,这种方法也会带来新的问题。比如同一软件的不同混淆版本,可能呈现不同的漏洞特征,给漏洞报告和补丁修复带来困难。这是一个经典问题。
第二,持续积累垂域数据和专家经验。我始终认为,只要高质量数据能够跟上,模型能力就有机会持续提升。这也是最有价值、最困难的一块工作。
王宇:如果能像过去做“千人千面”推荐一样,让软件运行也实现“千人千面”,使某一种攻击不再具有普遍的可扩散性,那会非常有价值。关键是如何以尽可能小的代价,让每份软件都拥有独特的特征。
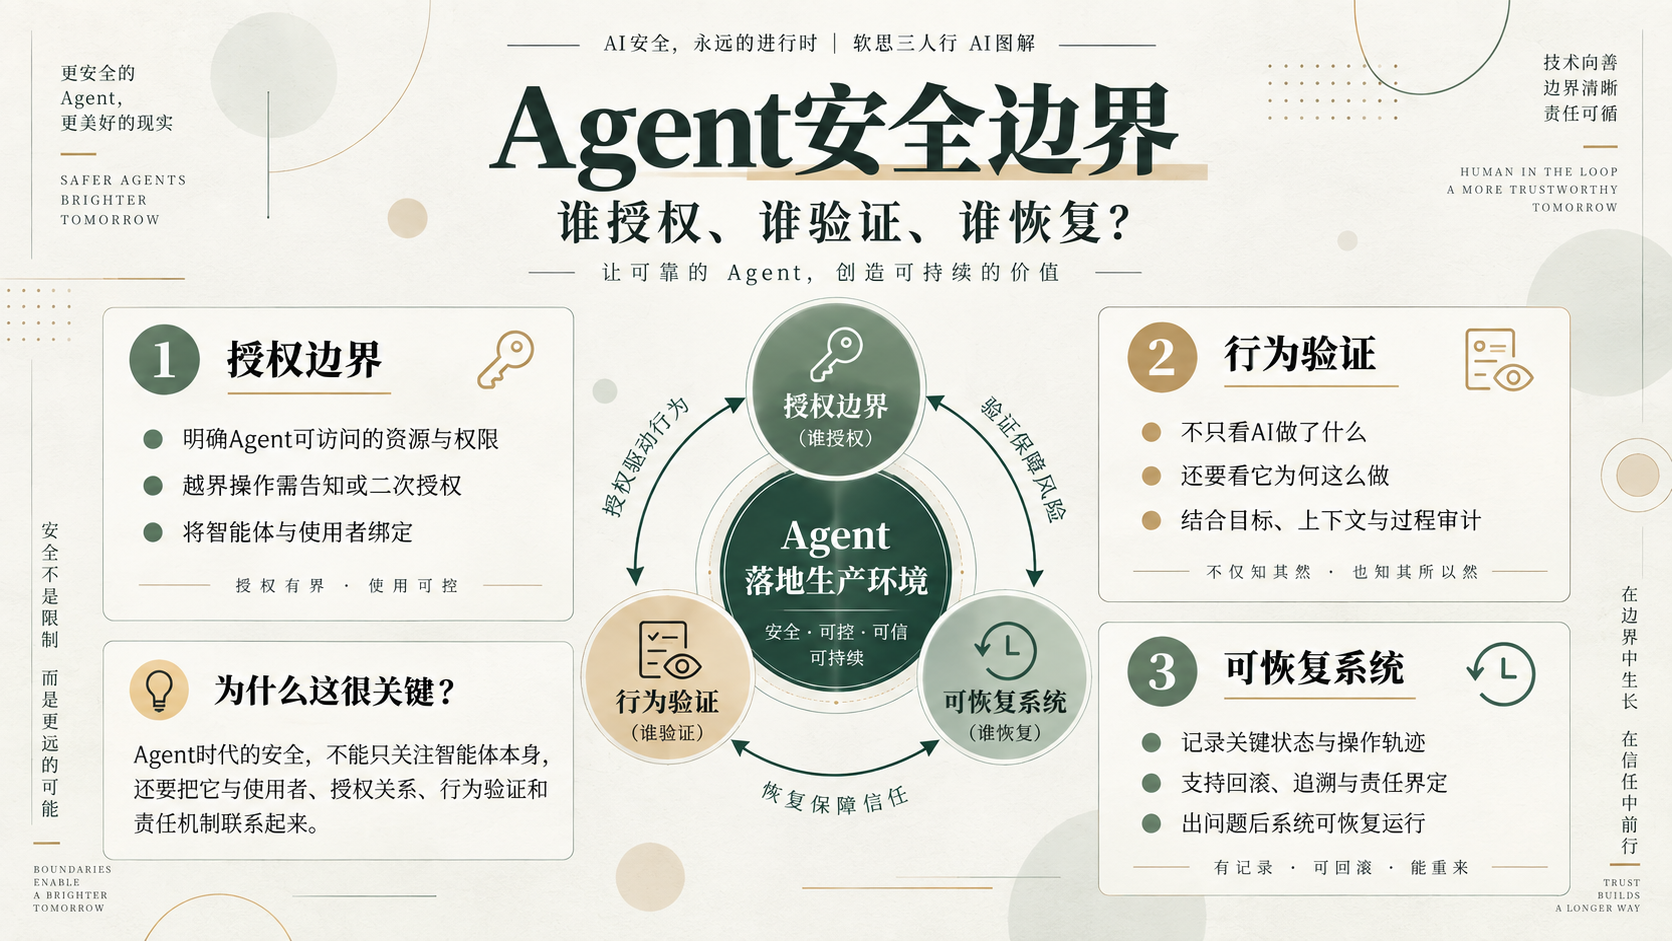
杨乐:一个AI Agent可能在几秒钟内删除企业的全部生产数据和备份。人其实也可能做到同样的事,但人会受到责任和后果的约束,Agent本身并不承担这样的责任。所以Agent时代的安全,不能只关注智能体本身,还要把它与使用者、授权关系和责任机制联系起来。这样安全事件发生后,我们才能更清楚地知道是谁授权、谁在使用、什么行为越过了边界。
围绕这个思路,软件防御者需要三类角色——
1)设计授权边界的人:明确Agent访问权限,以及越界操作何时必须先行告知或获得授权。
2)验证AI行为的人:不仅要知道AI做了什么,还要理解它的行为动机。只有看清行为背后的目标和过程,才能更有效地发现、修复问题。
3)构建可恢复系统的人:随着Agent大规模使用,代码可能越来越趋向“用完即弃”。一旦出问题,如何还原当时的代码和系统状态,就成了难题。因此我们需要能够追溯这些“即抛代码”的真实状态,判断问题究竟来自恶意行为、无心之失,还是系统本身的能力局限,而不是简单地把责任全部归咎于使用者。
王宇:第三点关于“可恢复”,让我想到DeepSeek最近推出的Harness框架。它的一个核心思路,就是让AI系统在时间和空间维度上具备可恢复性。比如卸载某个插件后,系统能够恢复到之前的状态。从安全角度看,我们的安全系统同样需要这种能力:不仅要能阻断风险,也要能在出问题后恢复状态、追溯原因。
05. AI时代的安全研究:顺应变化,寻找新问题
王宇:大语言模型的能力越来越强,已经超越了很多普通专家,安全研究员如何创造新的价值?
王帅:谁站在第一线,谁的技术就更扎实一些。安全研究和数学、物理这类有着几十年、几百年大问题的学科不同,更多时候是问题驱动、热点驱动的。从早年的深度学习模型,到大模型、智能体,再到现在的具身智能,我也一直在关注新的安全问题。高校在这方面有自己的灵活度,不需要与具体业务深度绑定,可以相对自由地探索。即便有些研究还比较粗糙,未必能直接赋能企业,持续追踪热点仍然能打开思路、拨开迷雾。
杨乐:古代的冶金、制盐等技术是相对封闭的——“我会打造一把铁剑,这就是我赖以生存的手艺,别人很难跨进这个行业”,技术只能通过言传身教代代相传。但当文字、书籍和印刷术出现后,技术开始大规模传播。对个体而言,原本独有的手艺不再稀缺;但对整个行业而言,知识扩散却推动了整体水平的提升。
大模型时代也是如此。与其只问个人价值会不会被削弱,不如想想,我们能否借助它推动整个行业向前。
另一方面,安全研究的对象也在不断变化。工业革命时期没有网络安全、系统安全,后来这些领域随着技术发展逐渐形成。未来,网络、系统乃至AI的形态还会继续变化,我们也需要顺应这种变化,去研究更广泛的“AI泛安全”问题。
我想特别提一下AI for Science的安全。随着AI降低跨学科研究的门槛,AI从业者可以更快进入生物、医学等领域,但未必同时具备这些领域长期形成的伦理规范和安全边界意识。比如在生物研究中,某些基因操作可能带来潜在风险,不能因为技术上做得到,就忽略后果。
所以AI4S的安全不仅是模型本身的安全,也涉及跨学科研究中的规范、责任与边界。传统的网络、系统安全问题会继续存在,但新的技术形态也会带来新的安全挑战。对安全研究者来说,顺应时代变化、用好大模型工具,去发现和解决这些新问题,就是持续价值所在。
06. When Bad Data Leads to Good Models:安全也需要“免疫力”
王宇:现有互联网基础设施中存量设备极多,许多过去未被发现的漏洞,如今可能被AI快速挖出。但在生产环境中,内核补丁从修复到上线往往需要很长时间。在漏洞尚未修复的情况下,如何保护现有系统,至少保证业务不中断?系统能否像人体一样,通过增强自身“体质”,获得某种类似免疫的能力?
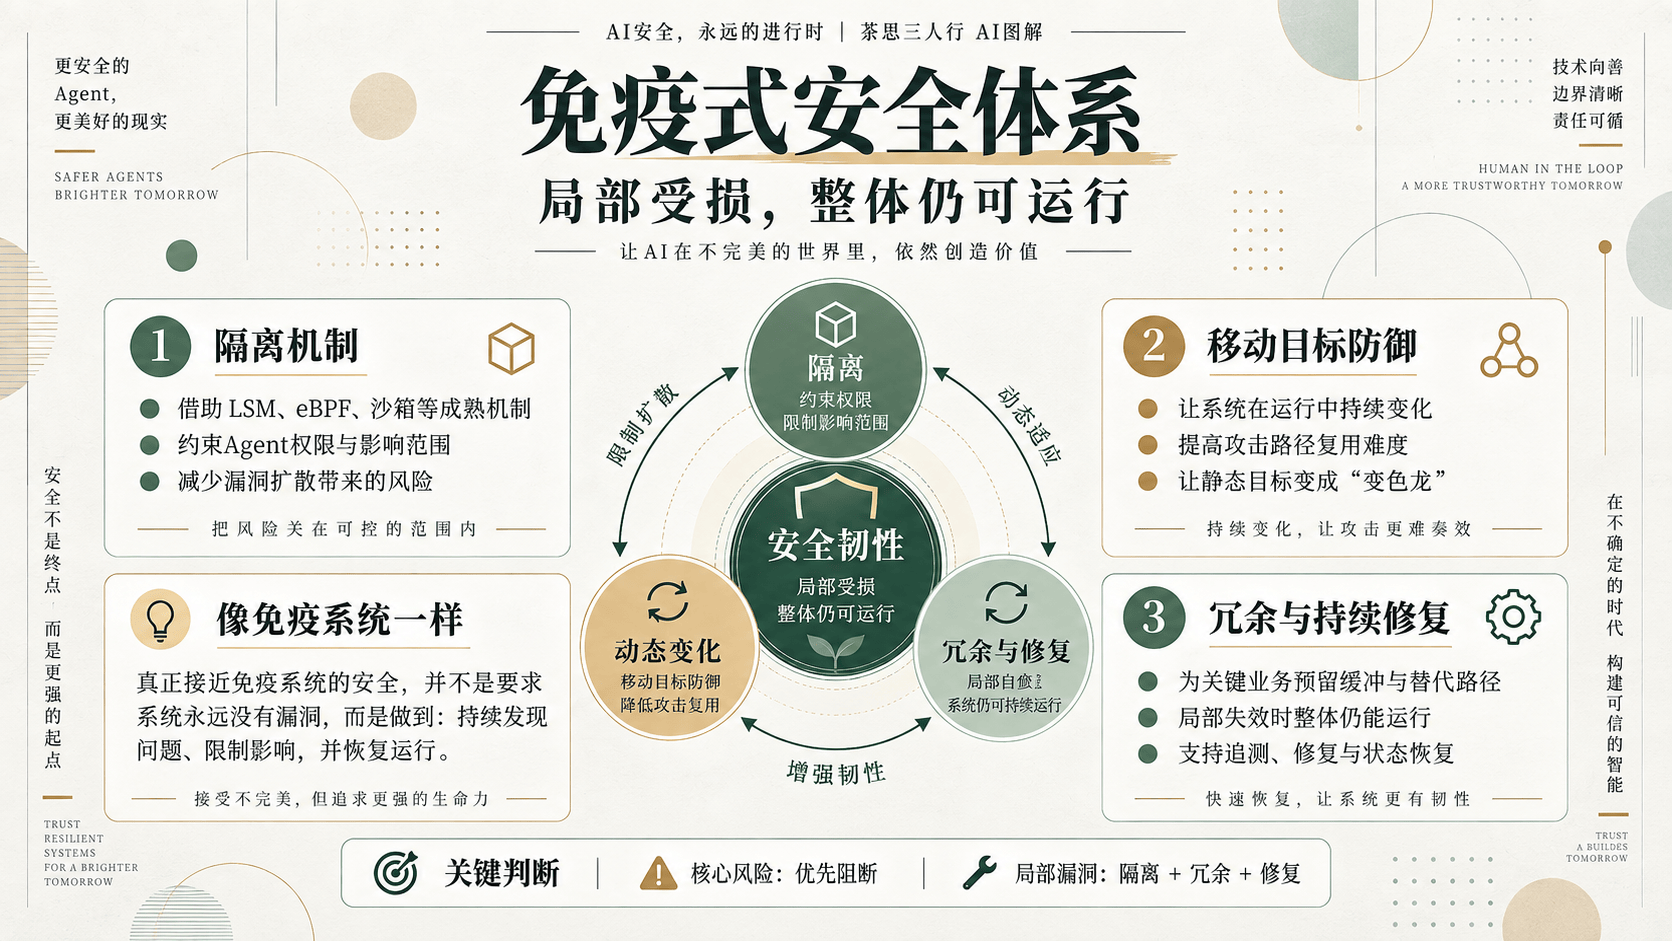
王帅:第一,还是要做好隔离。可以借助LSM、eBPF、沙箱等成熟的隔离机制,对Agent的权限和影响范围进行约束,尽可能降低漏洞扩散带来的风险。
第二,让攻击目标不再静止不变。大概2023、2024年左右,美国国家科学基金会有一个比较流行的议题,"移动目标防御"(moving target defense):让软件系统在运行中持续变化、迭代,让攻击者难以依赖固定的目标和攻击路径。攻击一个静态系统相对容易,攻击一个不断变化的“变色龙”就困难得多。
这个老问题在AI时代或许会有新的生命力。尤其在操作系统和系统级软件层面,我们仍然可以探索这种动态变化的防御方式。某种意义上,它也有点像免疫系统的自主进化。
王宇:从裸金属到虚机、容器,再到Function as a Service(FaaS),系统架构的演进一直在推动隔离粒度变得更细。这些原本为云原生时代设计的隔离机制,如今也可以成为智能体安全的重要基础。
杨乐:我们最近关注到清华大学徐恪老师团队的一项发现:一些通常被认为“不好”的语料,如果在训练中被完全排除,模型性能反而可能受到影响——只有见过什么是“不好的”,才可能更好地理解什么是“好的”。如果训练数据过于“纯净”,模型遇到不良内容时,反而可能不知道如何应对。
这个思路和人体免疫系统有些相似。疫苗让身体提前认识病原体,从而在真正遇到威胁时,能够更好地作出反应。
 徐恪
清华大学计算机系教授、IEEE Fellow
另外,系统还需要足够的冗余,免疫式防御才能真正发挥作用。人体某些血管堵塞后,血液还可以通过其他路径流动;但如果心脏、大脑这样的核心器官出了问题,就不能指望单纯依靠免疫系统自行消化。系统安全也是如此。对于可能导致整体瘫痪的核心风险,必须优先阻断;对于影响相对局部的漏洞,则可以通过隔离、冗余和持续修复慢慢消化。
所以,真正接近“免疫系统”的安全体系,并不是要求系统永远没有漏洞,而是要做到:局部出了问题,整体仍然能够运行;攻击已经发生,系统依然可以恢复。
当Agent从“给出答案”走向“采取行动”,安全的对象也从一个模型,扩展成了模型、权限、软件、数据和人的完整系统。因此,AI安全很难存在一个一劳永逸的答案。
模型能力继续向前,攻击面会继续变化,今天有效的防御方式也可能需要不断调整。真正重要的,也许不是寻找一条永远不会被突破的边界,而是让系统具备持续发现问题、限制影响并恢复运行的能力。
AI安全,始终是一场进行时。
原文链接:https://www.chaspark.com/#/hotspots/1321619712899551232
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





