去年某个随性的周六,我向 ChatGPT 提了一个十分简单的问题:“2025年诺贝尔物理学奖得主是谁?”
ChatGPT 立刻给出了回答,详细列出了获奖者姓名、研究领域,甚至还解释了他们获奖的具体科研成果。
但这里存在一个致命问题:彼时2025年的诺贝尔奖尚未公布。可模型没有丝毫犹豫、没有片刻迟疑,更没有如实告知“信息不足”或“2025年奖项暂未揭晓”。
相反,它无比笃定地输出了一段虚构内容,语气坚定得如同在答辩博士论文。我自己也曾博士答辩过,真希望我临场也能拥有大模型一本正经编造事实的底气!
人类有一个典型认知惯性:习惯性将置信度等同于正确率。如果一个人说“答案大概是42”,另一个人笃定地说“答案绝对是42”,即便两人的判断都有可能出错,我们也会本能地更相信后者。对人类而言,语气坚定、置信度高,往往是判断结果可靠的信号。
但对AI系统来说,置信度是极具欺骗性的参考指标。
本文将深度拆解背后的核心原因。
一、我们误以为:置信度 = 真实概率
假设我们让大模型识别图片中的动物,模型输出如下结果:
Cat: 0.97
Dog: 0.02
Bird: 0.01
绝大多数人会直观理解为:模型有97%的把握判定这是一只猫。
这看似合理,却完全误解了模型置信度的真实含义。需要明确的是,绝大多数AI模型都会通过 Softmax 激活函数 生成预测结果。
Softmax 的作用是将模型原始输出的对数概率(Logits)归一化为总和为1、形似概率的数值。而该函数中的指数运算特性,会让微小的原始数值差异被急剧放大。
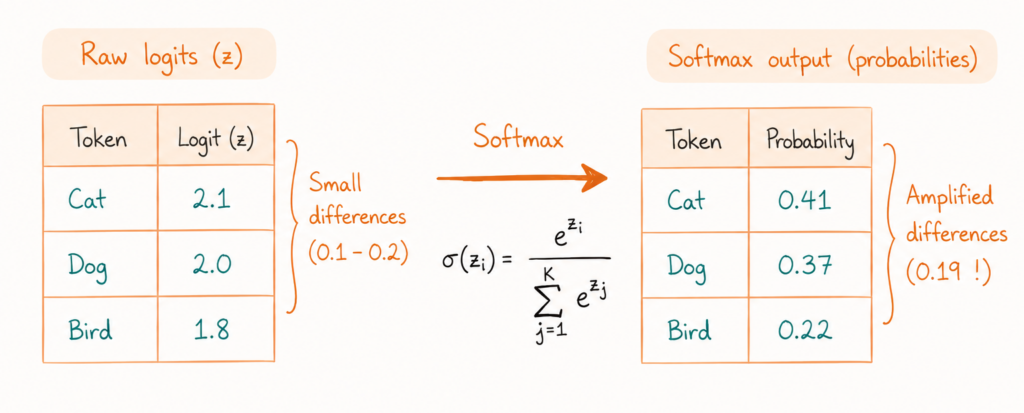
这意味着,模型输出的97%置信度,并非代表“有压倒性证据证明这是猫”。其真实含义大概率只是:在当前所有候选选项中,“猫”这一选项的得分微弱领先。
这两种解读,本质天差地别。
二、人类与AI对“不确定性”的处理逻辑截然不同
人类可以坦然接受不确定性,并擅长表达不确定状态。
我们日常交流中经常会说:“我可能错了”“我基本确定”“也许是这样”“我个人认为”。人类的置信度是连续、可变、有梯度的。
但AI模型的表现,像极了小组作业里那种三分钟看完知识点、就敢自信爆棚给所有人讲解的同学(相信大家身边都有这类人)。
你告诉大模型“我认为法国首都是巴黎”,它会回复“巴黎是法国首都,置信度99.8%”;你告诉它“我认为亚特兰蒂斯是虚构的”,它却会输出“亚特兰蒂斯位于葡萄牙以西约400英里海域,置信度98.7%”。
两件事一件正确、一件荒谬,但在大模型的判定逻辑里,二者的输出置信逻辑完全一致。
三、典型问题:自信式谬误(自信傻瓜困境)
这就催生了AI领域的自信式谬误问题:模型可以在完全错误的情况下,表现得极度笃定。更危险的是:越是需要谨慎判断的未知场景,模型反而越自信。
这种问题在模型遇见训练分布外数据时尤为突出。
举个例子:假设我们训练一个猫狗图片分类模型,正常识别猫狗精准度很高。但如果输入一张烤面包机的图片呢?
人类看到从未见过的陌生物体,会坦然承认“我不知道这是什么”。但绝大多数AI模型不会。它大概率会输出:
Dog: 98%
Cat: 2%
除非你的烤面包机长了贵宾犬的外形,否则这个结果显然是彻底错误的。
出现该问题的原因远比大家想象的简单:模型从未被训练过“以上都不是”的判定逻辑。面对陌生样本,它只能在现有候选标签中,强行选出得分最高的那一个。
这就好比指着一辆自行车,逼别人回答“这是什么水果”。对方最后只能随便蒙一个答案、强行收尾:“是香蕉?”
我们可以模拟大模型的过度自信现象:
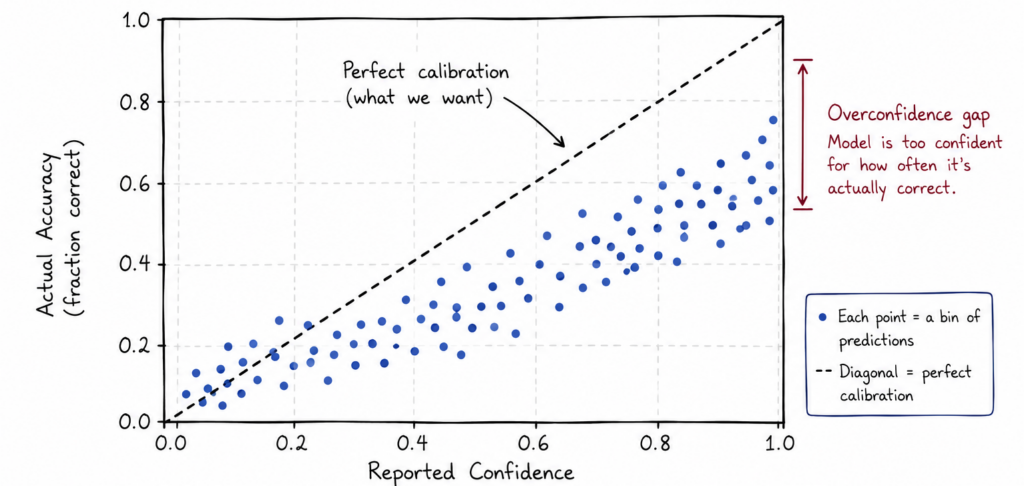
我们理想中的模型:输出90%置信度时,真实正确率约为90%。
现实中的多数模型:输出90%置信度,真实正确率仅有65%。
置信度与真实准确率的严重脱节,正是大模型训练优化需要解决的核心痛点。
四、让模型学会“诚实”:置信度校准
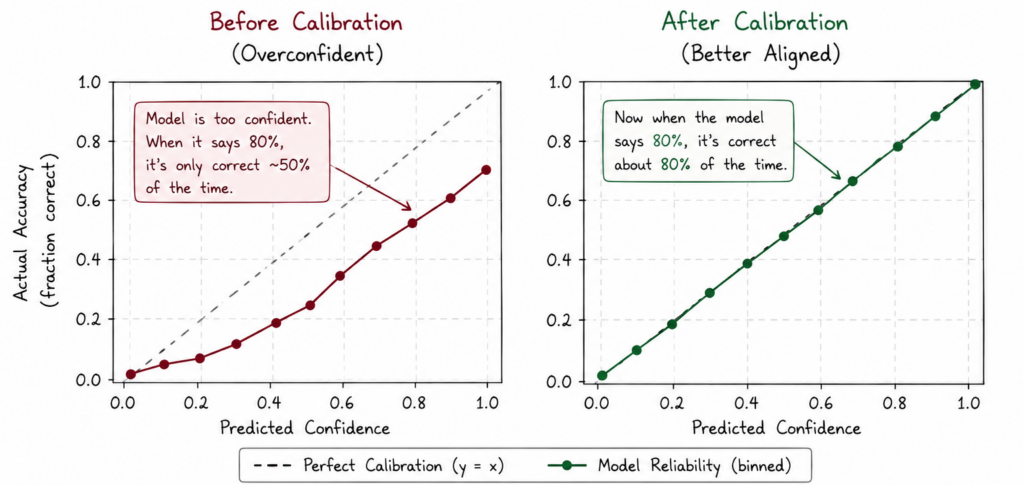
既然我们找到了模型“自信犯错”的根源,该如何优化,让模型置信度与真实准确率匹配?这就需要用到**置信度校准(Calibration)**技术。
校准不会提升模型的预测准确率,但能提升模型的诚实度。
经过校准的模型,90%的置信度具备真实参考意义:历史数据证明,该置信度下的预测结果,真实正确率约为90%。
行业主流校准方法包括:
温度缩放(Temperature Scaling)
保序回归(Isotonic Regression)
以上方法的核心目标:对齐模型预测置信度与真实结果正确率。
五、为什么置信度校准至关重要
AI把烤面包机识别成狗,我们只觉得滑稽好笑。但现实场景中,大量类似的错误并不好笑,甚至致命。
大模型已广泛应用于医疗诊断、自动驾驶、风控反欺诈、金融预测等高精度、高风险场景。
模型输出“癌症患病概率99%”与“癌症患病概率62%”,会让医生做出截然不同的诊疗决策。
一旦模型置信度校准失效,人类会盲目信任虚假的高置信预测结果。而人类天生容易被“笃定、高置信”的结论说服,即便我们明知需要理性甄别,依然很难规避认知偏差。
随着AI深度落地真实业务,我们的评判标准需要迭代:不再只问“模型准不准”,更要问“模型说90%置信度时,真实正确率真的是90%吗?”
模型聪明,和模型可信,是完全不同的两件事。
人类本身也极易过度自信:总以为两天能做完项目、不用看说明书就能组装家具、一趟就能搬完所有杂货,即便过往经验多次打脸。
或许,AI只是复刻了人类的认知陋习。但二者最大的区别在于:人类盲目自信的错误,影响范围有限;而AI的高置信错误,会被规模化放大、影响数百万用户,造成不可估量的后果。
六、结语
长期以来,我们评判AI能力的标准,始终聚焦于酷炫的能力突破:
能不能写代码?能不能生成画作?能不能通过考试?能不能逻辑推理?
这些维度固然重要,但也让我们忽略了更核心的问题:我们能否信任这个模型?
单次输出正确答案,只是亮眼的能力;持续输出正确结果,同时懂得识别自身未知、主动保留不确定性,才是真正可靠的AI。
稳定性与可靠性从不是博人眼球的热点,却是AI落地的基石。
置信度本身没有问题,真正的问题是:置信度沦为了模型的“表演效果”,而非真实确定性的量化指标。
随着AI全面渗透医疗、教育、金融、科研、决策核心链路,我们必须摒弃“置信度即真相”的误区,将其视为需要核验的预估参考值。
让模型笃定输出答案很简单,但让模型学会何时不该笃定,仍是人工智能领域最难、也最关键的未解难题之一。
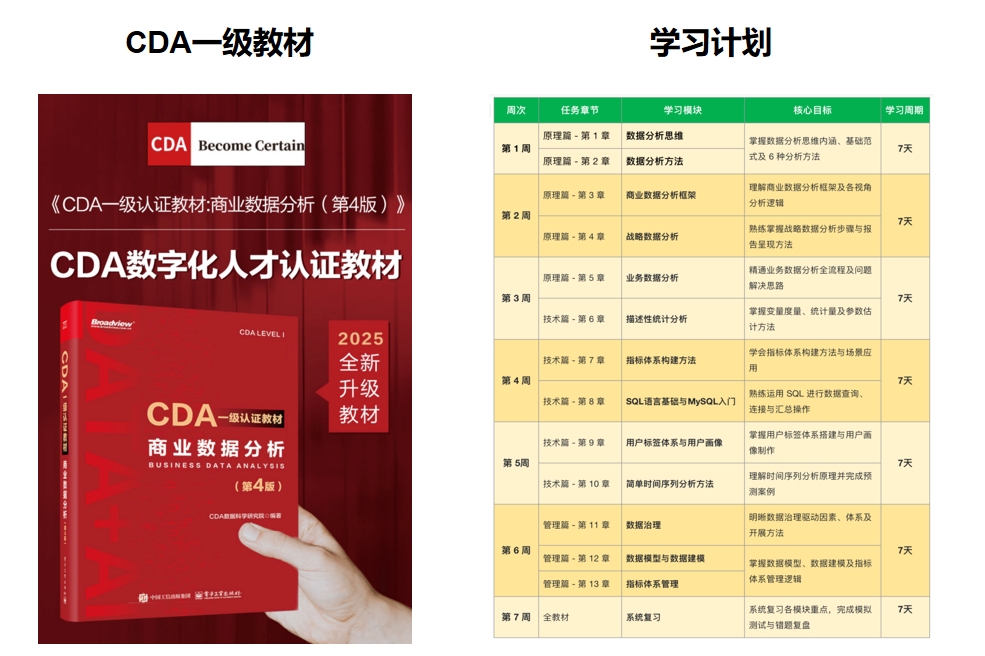
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





