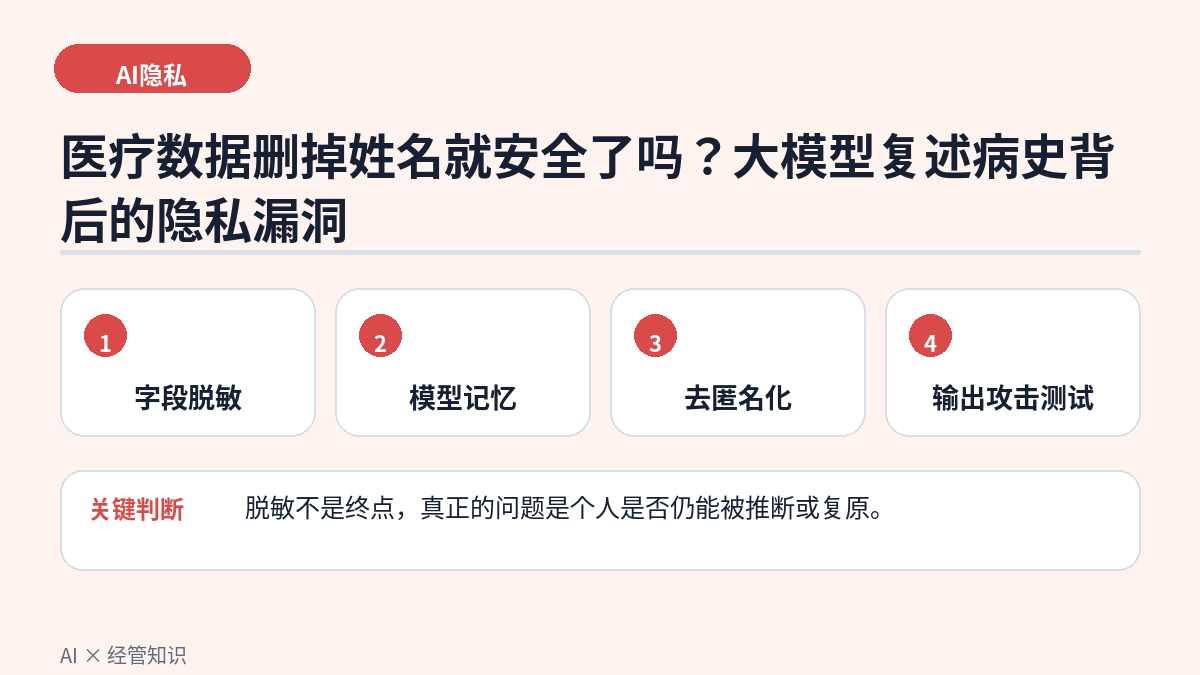
某医疗 AI 团队将一批已做字段脱敏(删除姓名、身份证号)的患者病历用于训练问答模型,但在内部演示中,模型竟逐字复述了一位罕见病患者的完整病史片段。团队负责人据此认为数据已脱敏、不存在隐私风险。下列判断最准确的是?
A. 只要删除了姓名等直接标识字段,大模型就绝对不可能还原或泄露任何患者信息
B. 即使做了字段脱敏,大模型仍可能因记忆效应逐字复述训练样本(数据泄露风险),再结合背景信息还可能被去匿名化,脱敏并不等于无隐私风险
C. 隐私风险只发生在模型训练阶段,模型一旦部署上线就彻底安全
D. 只要不对外开放接口,模型内部记住了什么都不会构成隐私问题
参考答案:B
大模型存在记忆效应,可能逐字复述训练数据片段(数据泄露),并可能通过背景信息关联进行去匿名化,因此脱敏并不等同于无风险。B项最容易误判的是 A 用绝对不可能还原的绝对化表述制造虚假安全感,忽视了模型记忆与去匿名化的真实风险;C项把风险限定在训练阶段,否认了部署后通过问答诱导泄露的可能;D项把隐私问题等同于是否开放接口,忽视了即使内部使用、敏感信息被不当复述同样构成隐私事件。




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏