当下 AI 工程师普遍关注循环工程(Loop Engineering)。该概念爆火的源头,是 Anthropic 负责 Claude Code 的工程师鲍里斯·切尔尼提出的理念:他已不再聚焦提示词优化,而是通过编写循环逻辑,让模型持续迭代调用,直至满足预设条件。
这套逻辑适配带测试套件的代码智能体,但对于企业级 RAG 流水线而言,循环本身才是核心工程优化点。企业 RAG 会频繁遭遇各类常规故障:解析器丢失答案依赖的表格数据、检索返回相邻无关页面、模型输出不符合 JSON 格式、批量处理中途 API 超时等。
RAG 四大基础模块仅能处理标准正常流程,而循环工程专门负责兜底所有异常场景,让流水线实现故障恢复、避免卡死空转。
传统单次执行流水线存在致命缺陷:仅执行一次解析、一次检索、一次生成,无论结果为空还是残缺,都直接返回无效内容。而循环机制为流水线提供了纠错机会——自动识别异常、动态调整策略、在用户感知不到的前提下重新执行异常步骤。
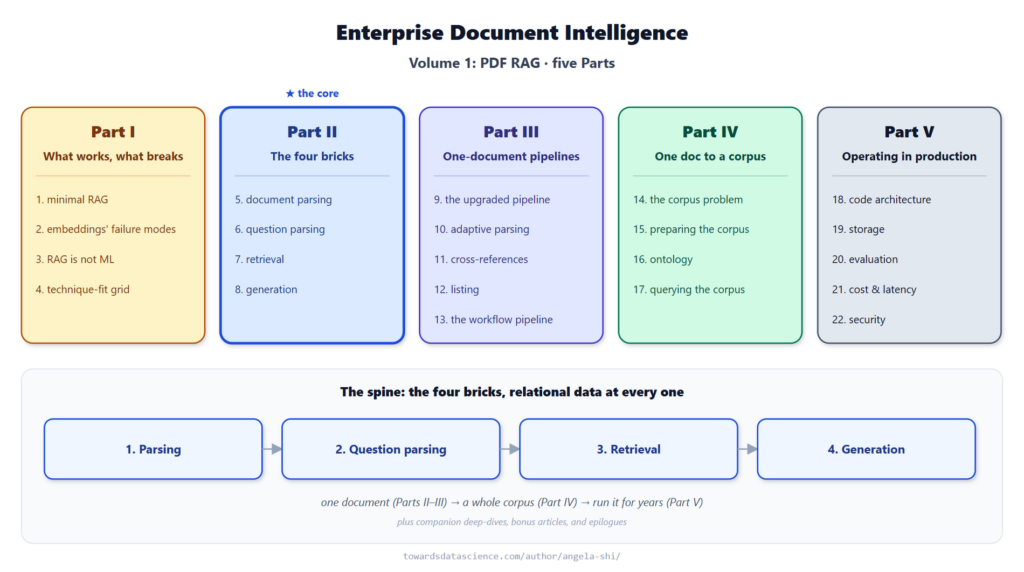 本文为系列配套独立文章,承接《RAG 系统的三层工程架构:提示词、上下文、循环》《支撑 RAG 输出的四类上下文输入》,聚焦其上层的循环工程体系,讲解循环的完整架构、双尺度分类、故障防护机制与人机嵌套循环逻辑。后续第四卷将拓展至智能体级别的循环工程体系,本文仅聚焦单文档场景。
可运行配套代码:模拟超时重试、检索范围扩缩、内容重生成等循环逻辑,开源仓库:https://github.com/doc-intel/notebooks-vol1
一、读懂循环工程:大模型调用的第三层核心架构
1.1 三层工程体系层级关系
大模型调用体系叠加三层核心工程能力,层层递进:
提示词工程:定义模型调用规则,包含系统提示、用户指令、输出格式约束;
上下文工程:管控模型每次调用的上下文窗口出入数据,筛选有效信息、剔除冗余内容;
循环工程:定义模型二次调用的触发时机、终止条件、异常恢复策略,是整套系统的容错核心。
优质提示词+标准检索链路可覆盖绝大多数正常场景,而剩余所有异常(格式校验失败、内容完整性不达标、接口限流/超时),全部依赖循环工程的兜底逻辑修复。
劣质循环工程的核心特征:针对同一错误重复执行完全相同的操作,无任何策略调整,属于无效空转,只会浪费 Token 与接口资源,无法修复问题。
有效循环的唯一判定标准:每次迭代必须修改关键参数,解决上一轮的核心问题,而非机械重试。
1.2 循环工程技术演进脉络
循环迭代并非新兴技术,其演进路径清晰:
1980年代:Erlang 「任其崩溃」架构诞生,奠定有限重试基础思想;
2022年10月:ReAct 首次将循环迭代融入大模型调用,实现「推理-决策-再执行/终止」逻辑;
2023年3月:AutoGPT 落地全自动自主循环智能体;
2023年 NeurIPS:反射机制(Reflexion)新增模型自我评估迭代能力;
2025年7月:Ralph 循环实现目标持久化,解决上下文重置导致的任务丢失问题;
2026年5月:Anthropic 将循环能力封装为 Claude Code 动态工作流。
本文聚焦单文档场景,仅用到轻量化循环能力:退避重试、格式失败重试、完整性校验、调度分支,不涉及复杂智能体编排逻辑,复杂场景将在后续文集更新。
二、循环的标准架构:三大核心控制维度 + 反空转准则
RAG 流水线中所有循环(无论大小),均遵循统一架构,由三大控制维度定义,且严格遵守唯一反空转规则。
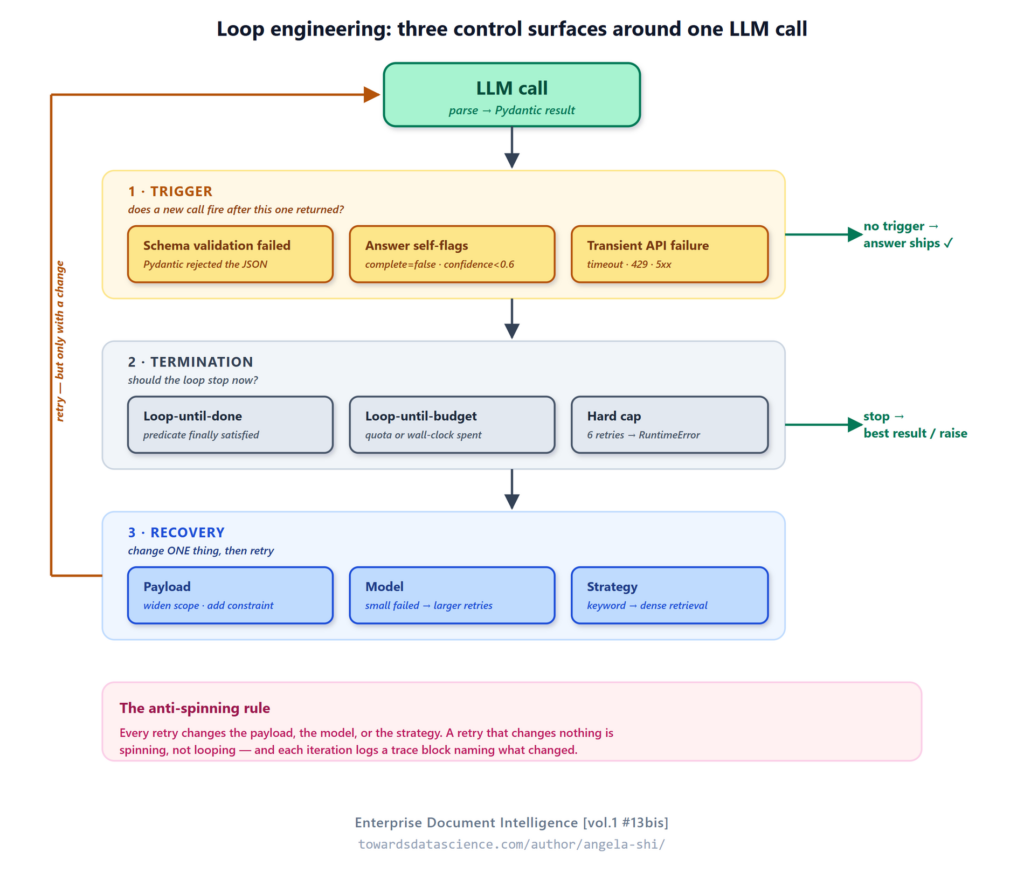
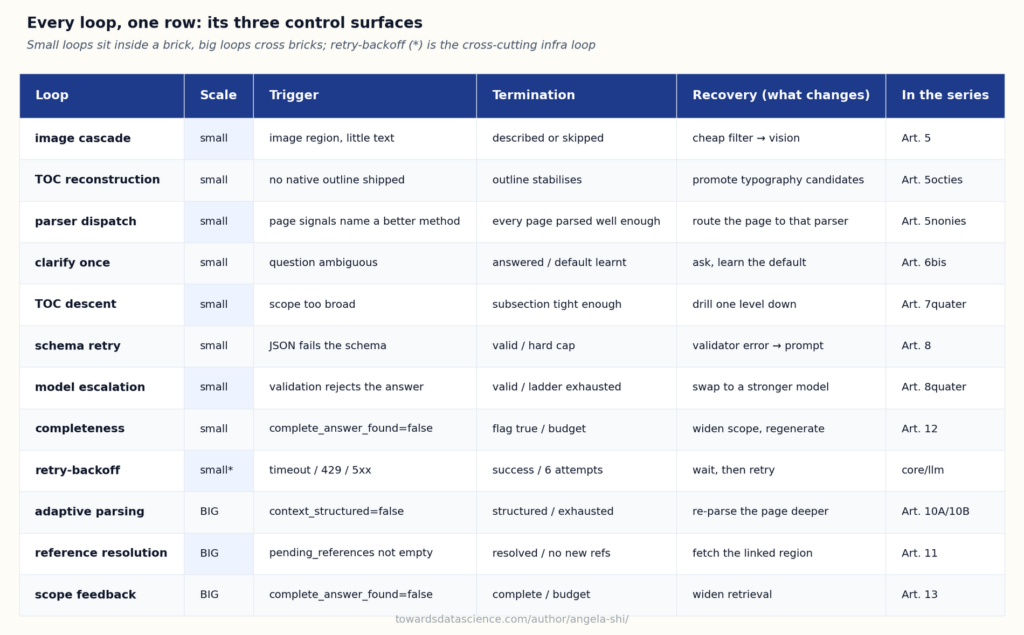
2.1 三大核心控制维度:触发、终止、恢复
(1)触发条件
首次调用完成后,触发新一轮迭代的明确判定条件,单文档场景包含三类核心触发场景:
格式校验失败:模型输出 JSON 不符合 Pydantic 规范,被校验器驳回;
内容自检异常:模型自主标记内容不完整、置信度低于0.6、需要补充说明;
接口瞬时故障:接口超时、连接失败、429限流、5xx 服务异常。
所有触发条件均为可量化的精准判定,系统日志会完整记录触发类型,由调度器统一分配处理策略。
(2)终止条件
循环停止迭代的硬性规则,杜绝无限循环,分为三类:
完成即终止:满足核心判定条件(格式校验通过、内容完整、置信度达标);
配额耗尽终止:达到最大重试次数、超出最大执行时长;
硬性截断终止:无论结果如何,达到指定迭代次数后强制停止,抛出异常。
无明确终止条件的循环,是官方明确标注的最高级故障模式。
(3)恢复策略
故障触发后,系统执行的修复动作,官方框架默认提供带抖动指数退避重试能力:
最大重试6次,间隔依次为 2/4/8/16/32/60 秒并叠加随机抖动,仅针对可恢复异常(超时、连接失败、限流、5xx系列错误),不可恢复异常直接抛出终止。
进阶恢复策略(适配不同业务场景):
模型降级升级:轻量模型输出异常时,自动切换高精度大模型重试;
人工介入兜底:高风险问题输出置信度过低时,推送人工审核;
容错批量输出:批量任务部分失败时,保留成功结果,单独标记失败项待后续重试。
2.2 核心反空转准则
重复执行相同操作、触发相同故障、无任何参数变更的循环,属于无效空转,只会消耗接口预算,无任何业务价值。
有效重试必须变更以下任意一项核心参数:
变更请求载荷:扩大检索范围、新增提示词约束、优化用户问题表述;
变更模型等级:轻量化模型失效后,升级高精度模型二次执行;
变更执行策略:关键词检索失效时,切换稠密向量检索等新方案。
落地规范:每一次重试必须日志记录「变更内容」,无变更记录的重试属于违规执行。同时设置最大重试上限,从根源杜绝资源浪费。
2.3 官方核心重试代码实现
def llm_parse(*, input, text_format, max_retries=6, cache=True, **opts):
for attempt in range(max_retries):
try:
return client.responses.parse(input=input, text_format=text_format)
except Exception as err:
if not is_retriable(err):
raise
if attempt == max_retries - 1:
raise
delay = _compute_delay(attempt, base=2, cap=60, jitter=0.3,
retry_after=extract_retry_after(err))
time.sleep(delay)
三、循环的两大尺度:模块内小型循环、跨模块大型循环
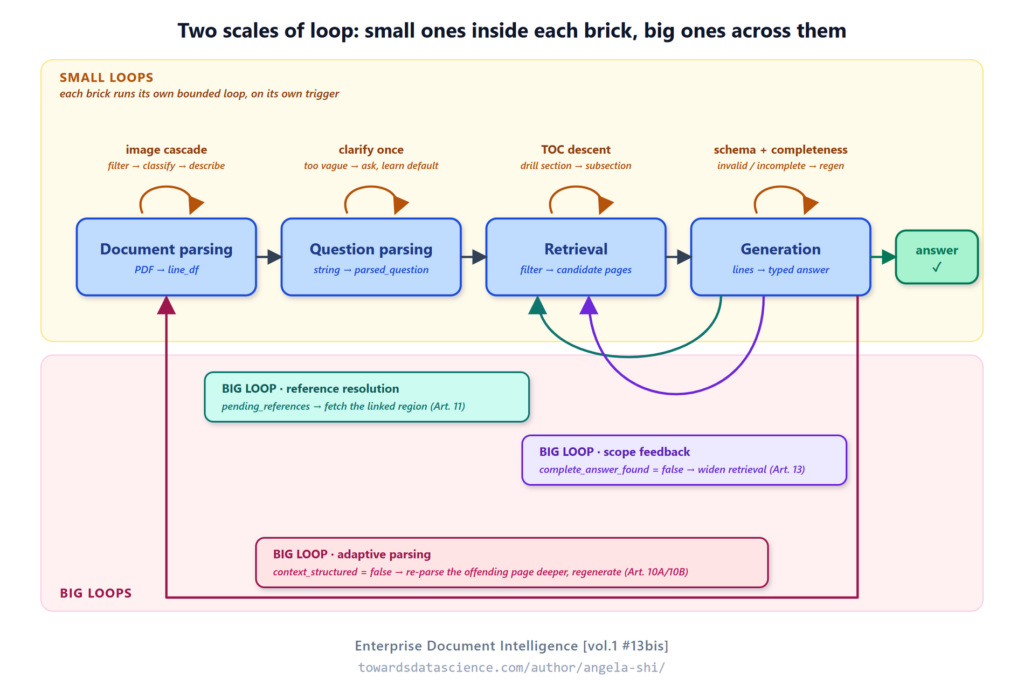
循环并非统一的通用机制,而是针对不同模块故障的定向容错方案,分为单模块小型循环、跨模块大型循环两类,架构统一、作用场景不同。
3.1 小型循环:内嵌于单一功能模块
小型循环运行在单个 RAG 基础模块内部,不跨流程,仅修复当前模块的局部问题,所有循环均包含标准的触发、终止、边界约束:
文档解析模块:图片轻量化筛选、视觉模型精准描述、文档大纲迭代修复、分页适配解析;
生成模块:JSON格式失败重试、清单内容不完整时重检索+重生成。
所有模块的底层 API 调用,均统一封装带退避重试的基础循环能力,属于流水线基础运维逻辑。
3.2 大型循环:跨模块联动迭代
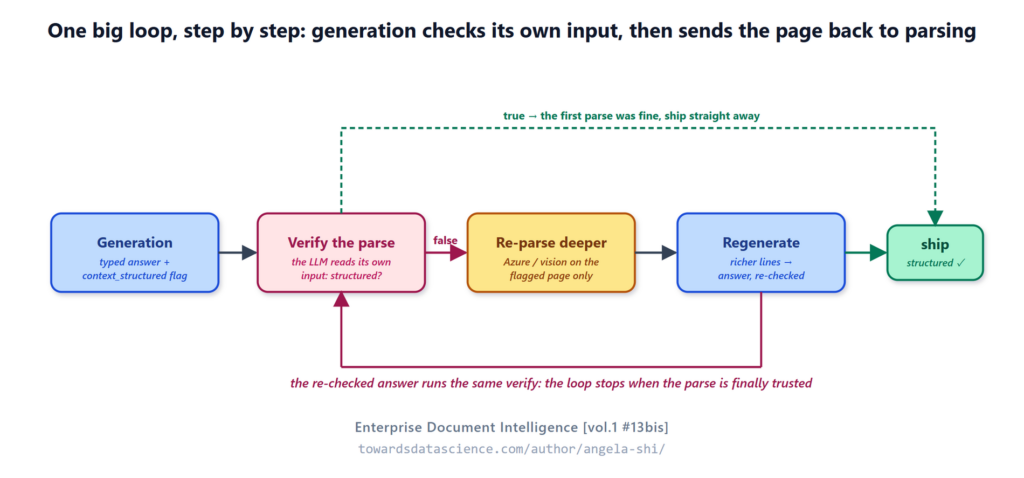
大型循环跨多个功能模块,由生成模块自检触发:模型判定输入上下文信息不足,主动回调上游模块重新处理数据。单文档场景包含三类核心跨模块循环:
自适应解析:生成模块识别页面解析残缺,调度深度解析器重新解析目标页面后再生结果;
交叉引用解析:识别文档内部引用锚点,定向检索对应章节内容,重新生成完整答案;
范围反馈迭代:识别检索范围过窄,自动扩大检索边界,重新检索并生成答案。
核心逻辑统一:通过标准化标记判定异常、有限度回调上游、二次生成后自检终止,杜绝无边界迭代。
3.3 现有框架内置的经典循环模式
当前 V1 版本框架已内置全部单文档场景所需循环能力,仅未做标准化命名:
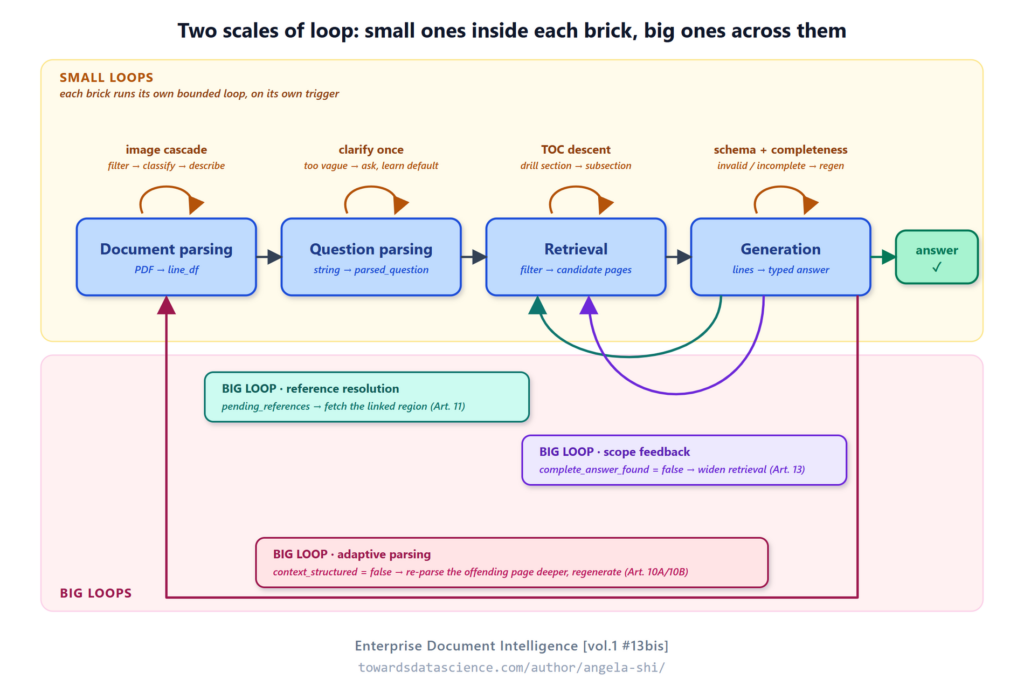
完成即终止循环:用于清单类任务,自检内容完整后立即停止迭代;
退避重试循环:底层 API 通用容错机制,适配各类瞬时接口故障;
生成过滤循环:结构化输出校验,格式异常自动重试生成;
分类执行循环:调度器根据问题类型,定向匹配对应处理逻辑;
跨模块反馈循环:生成模块反向优化上游检索、解析策略。
暂未落地能力(V4 高级智能体版本更新):对抗性校验、多答案择优裁判、空轮终止机制等复杂循环逻辑。
四、循环工程规避的三大核心生产故障
企业级单文档 RAG 生产环境高频三类故障,均可通过标准化循环工程体系彻底规避:
4.1 瞬时故障无限空转
故障现象:接口限流、超时等瞬时问题触发重试,无硬性终止上限,持续重试耗尽接口预算。
解决方案:设置最大6次重试硬上限,超限后强制抛出异常,同时日志告警,及时发现异常服务。
4.2 确定性故障重复重试
故障现象:模型固定输出格式错误、字段拼写错误,相同提示词重复重试,持续触发校验失败,无任何修复效果。
解决方案:格式失败后动态更新提示词,植入具体校验错误信息,引导模型针对性修正输出,打破固定错误循环。
4.3 低置信度结果直接输出
故障现象:模型输出置信度极低,但系统无校验拦截,直接返回不精准结果给用户。
解决方案:配置置信度阈值,低置信度结果自动升级处理——扩大检索范围、切换检索策略,或标注风险后输出,杜绝虚假精准答案。
五、嵌套循环体系:人机协同的三层循环架构
单轮调度循环只是内层逻辑,整套 RAG 系统运行依赖三层嵌套循环(借鉴吴恩达软件架构理念),三层循环各司其职、不可相互替代:
5.1 内层循环(秒级-分钟级):机器自动调度
即本文核心讲解的自动化循环:接口故障重试、格式异常重生成、检索范围迭代优化,全程无人工干预,受预算与次数约束。
5.2 开发循环(分钟级-小时级):工程师迭代优化
工程师通过日志审计、故障统计,针对性优化词典、提示词、校验规则、检索策略,部署后更新内层循环的执行逻辑,实现系统迭代升级。
5.3 外层循环(小时级-周级):业务专家校准
业务专家修正系统错误输出、优化问题模板、校准抽取字段,修正数据入库成为标准答案,反向迭代系统知识库与规则体系。
核心设计理念:只要人工掌握 AI 不具备的业务知识,外层人工循环就无法被自动化替代。系统设计核心原则:降低专家校准成本,简化修正操作、完善审计日志、搭建审核队列,让人工迭代效率持续提升,实现系统正向优化。
六、适用范围与后续拓展
本文仅聚焦单文档 RAG 场景,三类复杂场景暂未覆盖,将在后续文集更新:
语料库级循环:批量文档局部恢复、用户编辑内容实时刷新;
智能体级循环:多轮长周期迭代、子智能体调度、记忆生命周期管理;
对抗性校验循环:独立校验智能体反驳验证答案真实性。
七、总结
循环工程是继提示词工程、上下文工程之后的第三大 RAG 核心工程体系。在单文档场景下,核心包含四大基础能力:适配瞬时接口故障的退避重试、适配格式异常的生成过滤、适配内容残缺的完整迭代、适配多场景的调度分支策略。
整套体系的核心铁律:所有有效重试必须变更核心参数,无变更的重复执行均为无效空转。
循环工程的核心价值,不在于优化正常流程,而在于兜底所有生产级异常,让 RAG 流水线具备自愈能力,摆脱单次执行的局限性,实现稳定、可控、可迭代的企业级落地。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





