1、资料名称:2025-2000年地级市生产网络数据、上游关联强度、下游关联强度
2、测算方式:
参考顶刊《管理世界》金星晔对上市公司生产网络的构造方法,先在企业层面把企业之间的投入产出关联从「
产品文本」层面刻画出来,生成企业—企业上下游关联强度,再按企业办公地所在地级行政区归集为城市层面的生产网络指标。核心操作步骤:
① 从年度报告中提取主营业务描述文本(起始关键词「从事的主要业务」、终止关键词「重大变化情况」),并并入「主营构成(按产品)项目名称」与「经营范围」,得到每家企业逐年的主营产品语料;
② 依据上述语料,利用 Jieba 分词并对照产品词库筛选出主营产品词汇,按年度构造每家公司的TF-IDF 产品词向量;
③ 基于 2017 年全国投入产出表(竞争型,149 个产品部门),计算每两个产品部门之间的上下游关联强度矩阵 V——先求投入系数与产出系数(SUPP、CUST),再取两者算术平均;
④ 依据《国民经济行业分类(GB/T 4754—2017)》的产品部门详细说明,构造 149 个产品部门的描述文本并计算其词向量;再计算每家公司产品词向量与产品部门描述词向量的余弦相似度,得到「公司×产品部门」相似度矩阵 B;
⑤ 按 Relation = B × V × B′ 得到企业—企业上下游关联强度矩阵;按企业办公地所在地级行政区
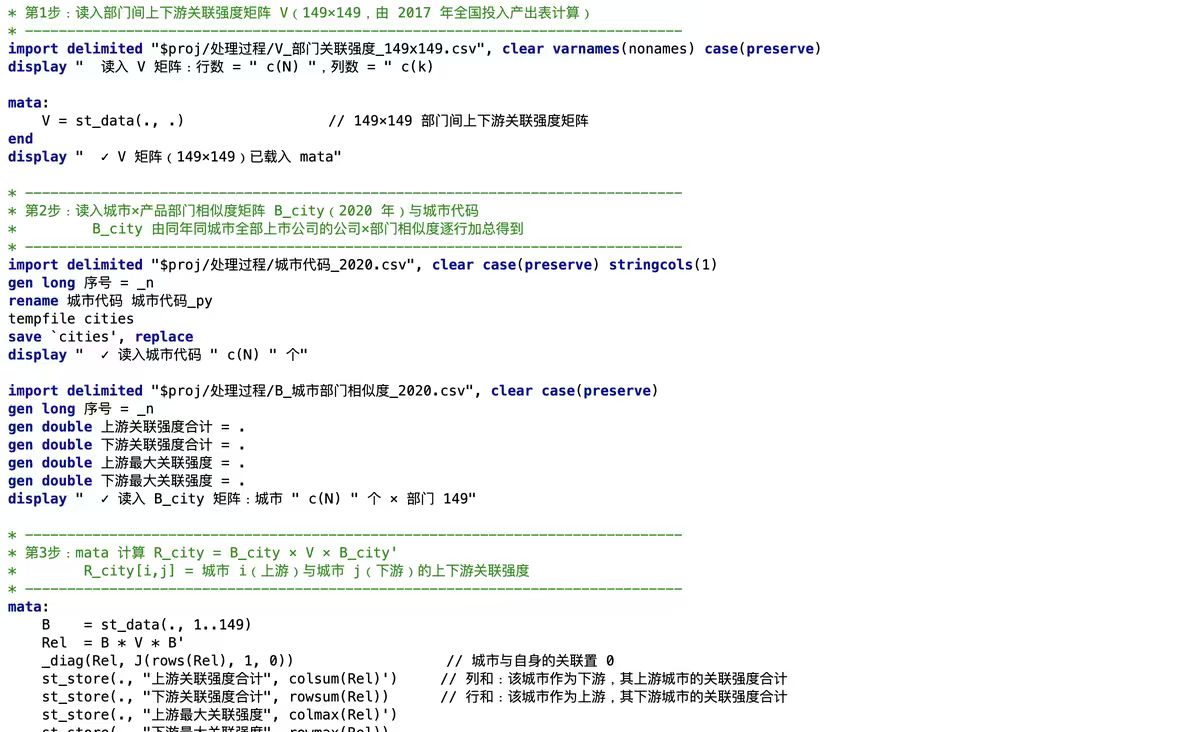
把 B 逐行加总得到「城市×产品部门」矩阵 B_city,再按 R_city = B_city × V × B_city′ 得到城市—城市上下游关联强度矩阵;
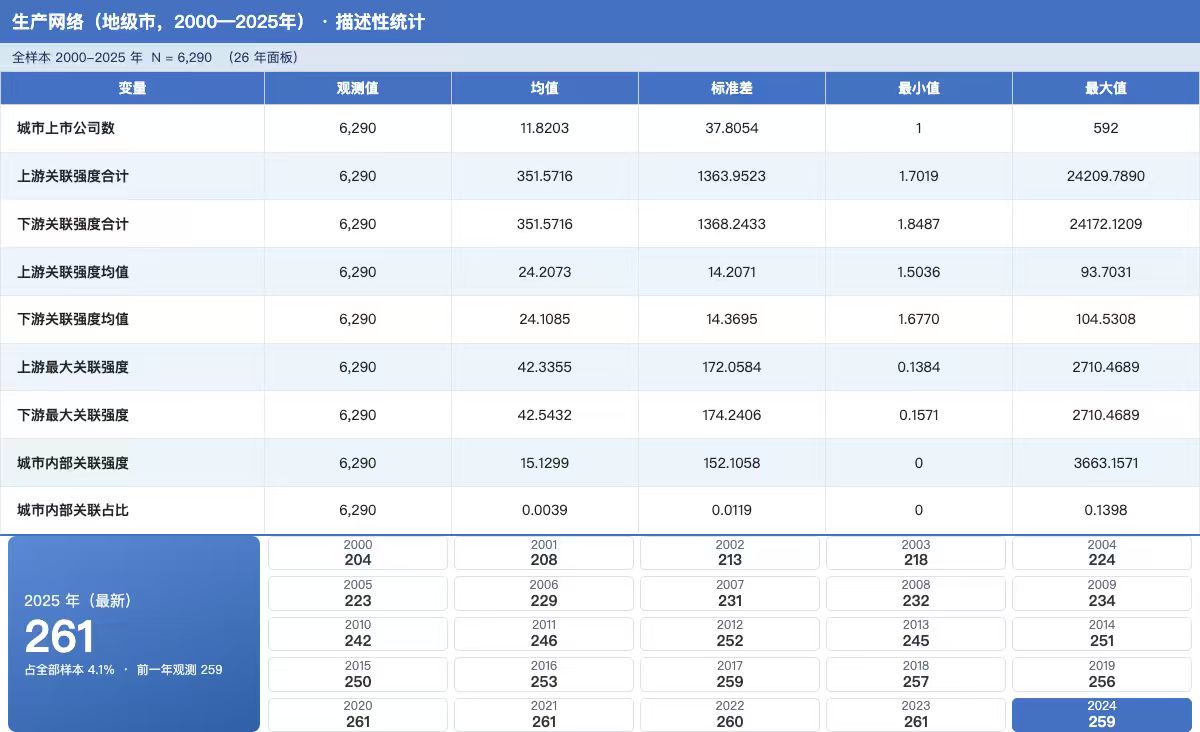
⑥ 汇总到城市—年度层面,输出上游/下游关联强度合计、上游/下游关联强度均值、上游/下游最大关联强度、城市内部关联强度与城市内部关联占比。
我们多做了几个变量,包括核心变量或者稳健性检验及过程变量,数据全流程公开,每个原始数据及过程都清晰可查(非主观编造),大家可以做核心变量或者稳健性检验,多个数据更加容易显著!
3、资料范围:
285 个地级行政区,6,290 个—年度观测值,年份跨度 2000-2025 年。
具体数据分布情况如下方描述性统计。
资料包含城市对关联明细长表(城市i—关联城市j—年份—关联方向—关联强度,共 25.16 万行,每个城市每年保留关联强度最高的 20 个上游城市与 20 个下游城市)与城市—年度指标表;同时包含计算代码(Stata 和 Python 代码都有,真实代码,可以向期刊公布,每一步都可以复现和做重复实验)、完整的复现说明(教大家一步步复现,做法过程全部公开,无数据黑箱,并且对复现过程常见问题做了解答)及最终结果(最终结果格式是 excel 电子表格格式,非常方便大家导入到自己数据里面),大家可以验证一下确保准确性!
这里的核心变量是上游关联强度合计和下游关联强度合计,指标给大家解释一下
上游关联强度合计:这家公司"往上够"的力度——从上游(供应商、原料、零件)那边拿到的投入有多强、有多广
下游关联强度合计:这家公司"往下伸"的力度——它作为供货方,往下游(客户)出货有多强、有多广
数值越大 = 越是嵌在这条产业链里、越是核心的环节。 比如一家做整车的大厂,上下游关联强度通常都远高于一家边缘的小供应商。
配套的 上游/下游最大关联强度 是"最强的那一条线有多强",用来看它有没有一个特别关键的上下游伙伴。
4、参考文献:
金星晔,赵晟坤,郅曼琳,等.生产网络视角下的数字技术扩散效应:经验证据、影响路径与经济后果[J].管理世界,2026,42(8):37-58+73+59.
此数据为科研课题组自用数据,根据真实的行业分类标准及公司年报文本一步步做出来的,每一步都每一步都可以复现和做重复实验,非仅仅只有一堆文件胡编乱造(根据参考文献瞎编结果根本就没有研究价值,不能反映真正的城市生产网络布局水平,实证围绕着错的结果根本就毫无意义浪费大家时间),真正的原创一手认真整理数据,数据处理较为复杂。






 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏