按住下方图标,点击小程序
免费领取AI学习资料、精选提示词
搞科研、写论文的朋友们,你们是不是也经历过这种崩溃时刻?
好不容易在知网或者arXiv上下载了十几篇核心参考文献,兴致勃勃地准备大干一场。结果一打开PDF,心态直接裂开。
双栏排版把文字切得支离破碎,读起来还要自己在脑子里重新拼图;好不容易有个重要的数据表格,偏偏跨页了,上一半在上一页,下一半在下一页,复制下来全是乱序。
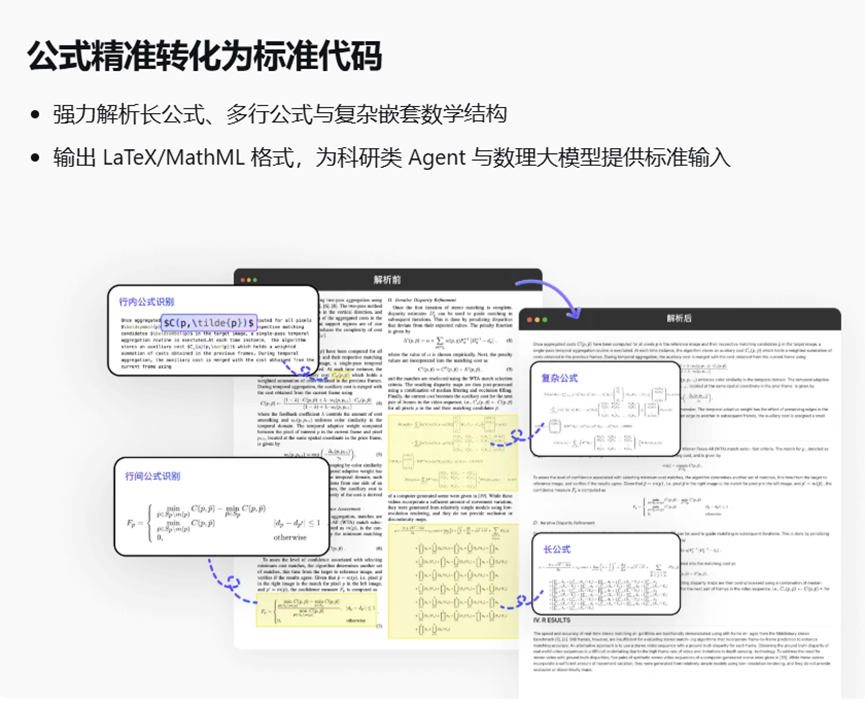
要命的是那些数学公式,在PDF里看着挺正常,一粘贴到Word或者Latex里,直接变成一堆火星文。
今天必须得好好介绍一下MinerU,这个超过71000星,曾经拿过github每日最佳的重磅开源来解决大家的难题。
最爽的是,MinerU还支持0部署在线使用和桌面客户端,小白也能直接上手。
开源地址:https://github.com/opendatalab/mineru
在线:https://mineru.net/OpenSourceTools/Extractor
简单来说,MinerU就是帮你把复杂文档变成大模型看得懂的Markdown或JSON。
就像给文档做了个翻译,从人类阅读的格式翻译成AI能理解的格式,而且翻得很完整,连公式、表格、多栏排版这些复杂的结构都能处理。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4581685748369833986" data-mpvid="wxv_4581685748369833986" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fmmbiz_jpg%2FjuxlRdXDvzGsmEa9JueQQtDTAKhgaibOiapab5G3DPRCfb5HFlqpjkjMjqpYuejOXjkmvVyiapujyMpocSBRxOqVIRCwNjNaERah5c4l2yy4mQ%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.8296296296296297" data-w="1976"></iframe>功能展示
咱们细说下MinerU到底都能干点啥。
先说支持格式PDF、Word、PowerPoint、Excel、图片、网页统统没问题,一百多种语言都能识别。这个覆盖范围已经相当惊人了。
公式转换这块真的让人眼前一亮,所有数学公式都能自动变成LaTeX格式,大模型最喜欢这种表达方式了。
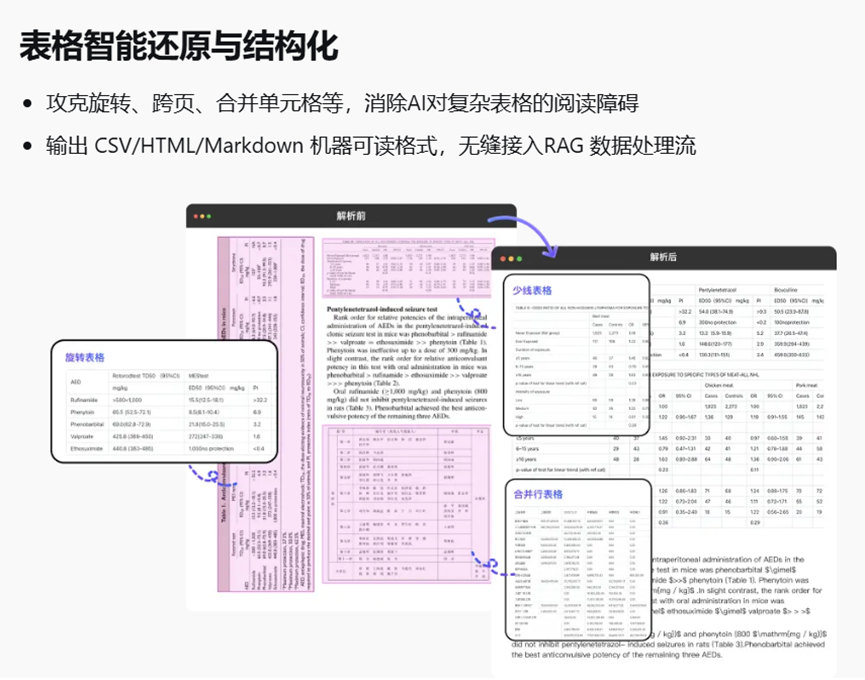
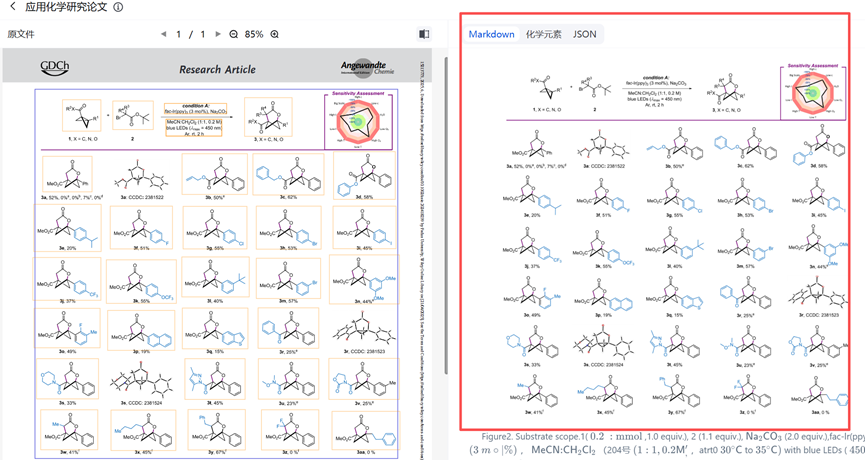
表格处理也特别溜,不仅把表格变成HTML格式,还能自动合并跨页的表格,读起来就像一张完整的表,不会因为分页就断掉。
多栏排版之前一直是文档解析的噩梦,MinerU能够按照人类阅读的顺序重新组织内容,自动去掉页眉页脚这些干扰信息。就像有个老练的编辑帮你把文章整理得井井有条。
OCR识别用了双引擎技术,一个负责精确识别,一个负责整体理解,结合在一起准确率就特别高,连手写字都能认得出来,一百多种语言都支持。
兼容性也非常强,跟主流的AI开发工具对接基本丝滑对接。
MCP可直接集成到Cursor、Claude Desktop、Windsurf这些开发环境,用起来就跟本地功能一样。
RAG框架那边LangChain、LlamaIndex、RAGFlow、Dify、FastGPT都有原生支持,接上就能用。
开发者想要深度集成的话,Python、Go、TypeScript的SDK都有,REST API、Docker这些标准方式也都支持。
MinerU除了能转换之外,还能开发出很多高级的应用。丽如,可以用MinerU把整个论文库都转成结构化数据,然后喂给AI做知识检索,准确率比普通解析高多了。
或者把企业内部所有文档都批量转换,搭个私有知识库,员工自然语言提问就能找到需要的信息,连表格里的数据都能精确查询。
我觉得MinerU算是开源领域里处理文档的一把尖刀。不管你是AI应用开发者,需要给大模型准备干净的数据,还是整天泡在文献里的科研人员,这个工具都能帮你节省大量时间。
企业、高校及渠道合作
请联系微信:FYLlaoshi




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏