开篇:RAG 开发者最熟悉的崩溃现场
这篇由香港科技大学(广州) 等机构合作完成的论文《Information Flow Reveals When to Trust Language Models》,想解决一个做 RAG 的人几乎都踩过的坑:文档明明检索到了,大模型却未必真的用了它。
文档明明检索到了,甚至就塞在上下文里,大模型还是能一本正经地胡说八道。你去调 prompt,换 reranker,拉长上下文, 甚至改 agent 工作流,最后会发现一个很扎心的事实: 你知道“资料给到了”,但你并不知道模型到底“有没有用到”。
这其实就是今天很多 RAG 系统的信任危机。
我们平时看 benchmark、看最终答案、看置信度、看 self-consistency,本质上都还是在看结果层。可真正关键的问题是过程层: 模型在生成这个答案的时候, 内部到底参考了哪些 token?哪些证据真正进入了它的“主思路”?
这篇论文最有意思的地方就在这里。它不是继续在输出层打转,而是直接往模型内部走,逐层追踪上下文 token 对最终答案的真实贡献。通俗点说,它像是给大模型装了一个“思考回放器”。
这篇文章最核心的观点可以浓缩成一句话:
判断一个大模型值不值得信,不该只看它说了什么,更要看它在内部到底依赖了什么。
图 l 可以理解为整篇论文的出发点。它强调的不是传统意义上的输出正确率,而是一个更底层的问题:模型给出答案时,内部究竟有没有把检索到的证据真正纳入计算过程。也正因为这个问题过去几乎没有被直接观测,RAG 系统才会频繁出现“文档明明给了,模型却像没看见”的失效场景。
我们一直在用“看结果”的方式误判大模型
先想一个问题:两个 RAG 系统回答同一个问题,最后答案一样,它们就一样可靠吗?
完全不一定。
系统 A 可能是真的抓住了文档里的关键证据;系统 B 也可能只是凭训练记忆、模式匹配,或者上下文里的无关线索“蒙对了”。表面上它们都答对了,底层机制却可能天差地别。
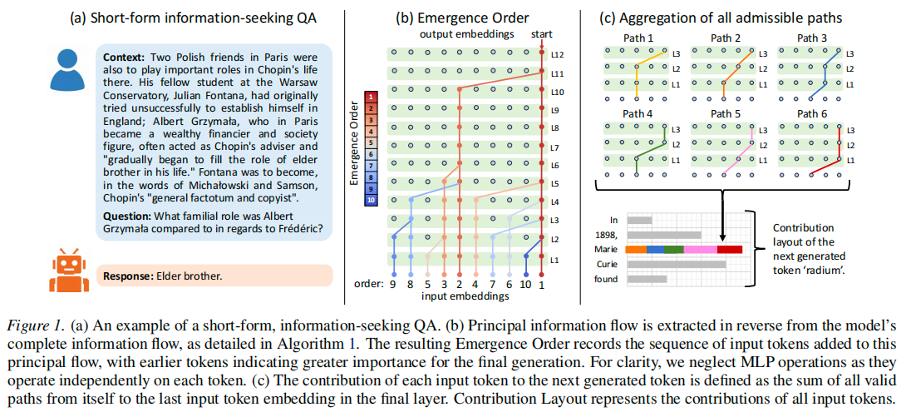 Figure 1: 论文的问题设定:真正要判断的不是“答案对不对”,而是模型内部是否真的依赖了相关证据。
这就像两个学生都做对了一道题。你不知道一个是自己推出来的, 还是另一个刚好背过原题。只看分数,很难判断谁是真的会。
这正是很多不确定性量化方法的局限:
基于似然的方法,主要看输出 token 的概率高不高;
基于单层注意力或隐状态的方法,通常只能截到“某一帧画面”。
问题在于,这些方法大多没有真正回答一个更关键的问题:信息是怎么从输入端,一层一层流到输出端的?
而这篇论文的切入点非常明确:既然我们想知道模型有没有真的用上证据,那就不要只盯着结果,而要直接追踪内部的信息传播过程。
第一个关键发现:模型内部的信息,不是平均流动的
论文研究的是短格式 RAG 问答任务,在 LLaMA-3.2-3B-Instruct、LLaMA-3-8B-Instruct 和 Gemma- 3-4B-it 等模型上,结合SQuAD2.0 、HotpotQA 、MS MARCO 等数据集做了系统分析。
作者的出发点很直接:Transformer 每一层里,token 与 token 之间都会发生信息交互。而信息交互过程中的贡献可以基于曼哈顿距离来测量,如图2。
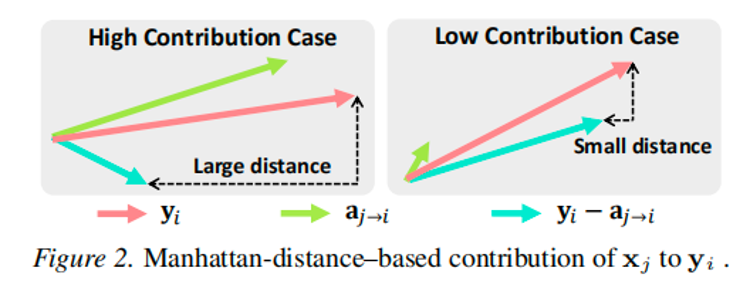 Figure 2: 基于向量间的曼哈顿距离,测量token 对token 的贡献。
如果把这种交互进一步量化,就能得到每一层里“谁对谁贡献了多少”的贡献矩阵。
但真正有价值的,不是只看某一层。
因为模型不是只在某一层思考。一个 token 对最终答案的影响, 往往是跨层传播、层层累积出来的。你只截取最后一层,或者只看中间某一层,本质上都像是在看案件监控的一帧截图,缺少前因后果。
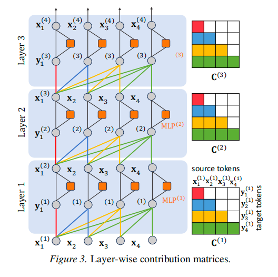 Figure 3: 每一层都有其各自的贡献矩阵。
基于图3中每一层贡献矩阵间的累积效果,作者提出了一个很关键的概念: 涌现顺序(Emergence Order)。
它想回答的问题是:如果从最终答案反向回溯,哪些 token 最早进入了那条真正决定输出的“主信息流”?
这个想法很像破案。案子最后破了, 当然不是每条线索都一样重要。真正关键的,往往是最早进入侦探主视野、并且持续影响判断的那几条线索。论文里的涌现顺序,抓的就是这种“先进入主干道的信息”。
更具体地说,作者设计了 Auto-Emergence 算法。从最后一层最后一个 token 的输出表示出发,逐层往回追,每一步都找出当前最强的贡献路径,把整条主信息流一点点剥出来。最终,所有token 会被排出一个顺序:越靠前,说明它越早、越直接地参与了最终答案的形成。
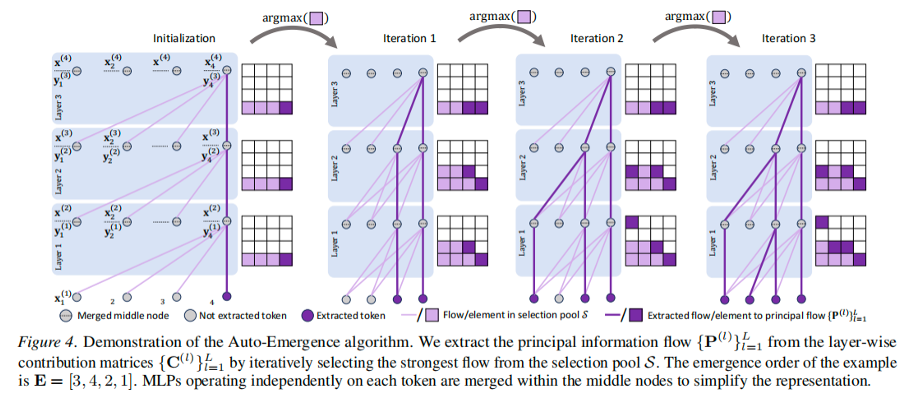 Figure 4: Auto-Emergence 算法从输出端反向追踪, 逐层提取最强贡献路径, 得到 token 的涌现顺序。
图 4 是整篇论文最核心的一张图。它把“主信息流”这个概念真正落成了一个可操作的算法流程:不是凭感觉猜模型参考了谁,而是从输出端反向回溯,逐层找出谁在真正地推动生成。也就是说,从这一刻开始,“模型到底参考了哪些证据”第一次变成了一个可以排序、可以分析、可以可视化的问题。
论文里还有一个很有意思的反直觉现象: 由于残差连接的存在,每个 token 对它自己的贡献往往都很强。乍一看,这似乎说明方法没抓住重点。但作者指出, 这恰恰是 Transformer 的正常属性,因为残差连接本来就是让模型在上一层表示的基础上做增量更新,而不是每层推倒重来。
换句话说, 自贡献很强不是 bug,而是架构本身的物理规律。关键不在于有没有自贡献, 而在于除了自贡献之外,哪些外部 token 真正进入了主推理链路。
第二个关键发现:不在主干道上的 token,也可能是幕后功臣
只看涌现顺序,还不够。
因为一个 token 没有直接出现在主信息流里,不代表它对答案毫无贡献。现实里的推理也一样。并不是所有关键因素都站在舞台中央,有些信息更像“中转站”或者“幕后支撑项”,没有它们,前台那条主逻辑根本立不起来。
于是论文又提出了第二个关键概念: 贡献布局(Contribution Layout)。
它不只关心“谁最先冲进主干道”,而是统计所有可能的信息传播路径,去看每个上下文 token 最终一共贡献了多少。
如果把前面的涌现顺序比作“谁最早直接冲到案发现场”,那贡献布局更像在算整张关系网:谁虽然没有站在最前面,但通过多跳传播、间接支撑,仍然对最终结论产生了重要影响。
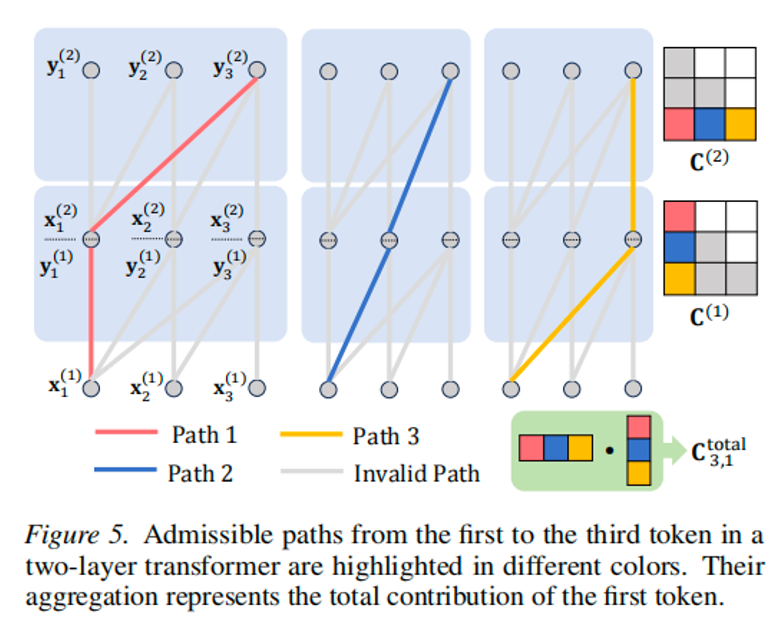 Figure 5: Contribution Layout 汇总多条合法传播路径,衡量各 token 对最终输出的直接与间接总贡献。
图 5 解释得特别直观:真正的贡献并不一定只来自“那条最显眼的主路”,还可能来自很多间接路径的累计。一个 token 也许没有直接决定答案,但它可能通过影响中间 token,间接改变了最终输出。贡献布局的价值,就在于把这些“幕后功臣”也统计进来。
论文给了一个非常典型的例子:
“Alice gave Bob the book after she finished reading it.”
当模型要判断 “she” 指的是谁时,直接证据当然是 “she” 和 “Alice”。但如果只盯着这两个词, 也不完整。像 “book” 和 “reading” 这样的词,虽然不是最终指代决策的正面主角, 却构成了必要的语义背景。
这就解释了为什么真实推理往往不是“抓到一个关键词就完事”,而是需要一整片局部语义场共同托住答案。
所以从工程视角看,贡献布局特别有价值的一点是: 它让我们不再只会问“模型到底看没看证据”,而是开始能问更细的问题:
这比只看 attention heatmap 更进一步, 因为它不只是可视化“看了谁”,而是在量化“谁真的起了作用”。
第三个关键发现:光专注还不够,还得专注对地方
有了信息流之后,论文真正把“什么时候该信任模型”这个问题往前推了一大步。
作者提出,可靠生成至少要满足两组互补条件。
第一组叫 Simulatability,可以翻译成“可模拟性”。
它的意思其实很朴素:如果模型内部真正依赖的 token,和外部判断为“真正相关”的 token,大体是对齐的,那这次推理就更可信。为了构造这个外部参照,论文使用了重排序模型给上下文 token 打相关性分数,再拿它去和内部信息流排序做比较。
如果两者越一致,说明模型内部那条“思路”越像一个靠谱的人类分析者在看材料, 而不是东抓一点、西抓一点,最后碰巧说对。
第二组叫 Concentration,也就是“集中度”。
它衡量的是:模型在这次生成中, 到底有没有形成清晰焦点。若贡献分布高度集中, 说明模型真正把注意力落在了少数关键证据上;若分布非常平均,则很可能是在一堆信息里到处游移,没有形成真正的判断中心。
这两组互补条件把“模型为什么不可靠”拆成了两种不同类型。它不是简单地给一个总分,而是把问题分成“有没有对齐到真正相关证据”和“有没有形成明确聚焦”两个维度。这样一来,我们终于能分清:模型到底是在散着想,还是在自信地想错。
这两个条件放在一起看,就特别有意思了。
如果可模拟性高,但集中度低,说明模型大方向没错,但内部还是有些散;
如果集中度高,但可模拟性低,说明模型非常自信,但它盯错了地方,这反而更危险;
只有两者都高,才更接近一种“既用对证据,又抓住重点”的健康推理状态。
这也是这篇论文最打动工程实践的一点。
因为它告诉我们,很多时候模型的问题不是“没想”,而是“想偏了”;也不是“没聚焦”,而是“聚焦错了对象”。过去我们缺的, 不是更多结果分数, 而是这样一种能把错误类型拆开的内部诊断框架。
一个无需人工打标的“内部测谎仪”出现了
如果前面的发现只停留在解释层面,那它还只是篇漂亮的可解释性论文。
但作者没有止步于此,而是进一步把这些内部信号做成了一个可用的诊断器。
论文最终构造了一个 12 维特征向量,包括:
9 个不同粒度下的 Simulatability 分数;
2 个来自贡献布局的 Concentration 分数;
然后,作者用这些特征去训练一个 XGBoost 校准器, 目标很明确:不靠人工标注答案,只根据模型内部的信息流结构,预测这次回答靠不靠谱。
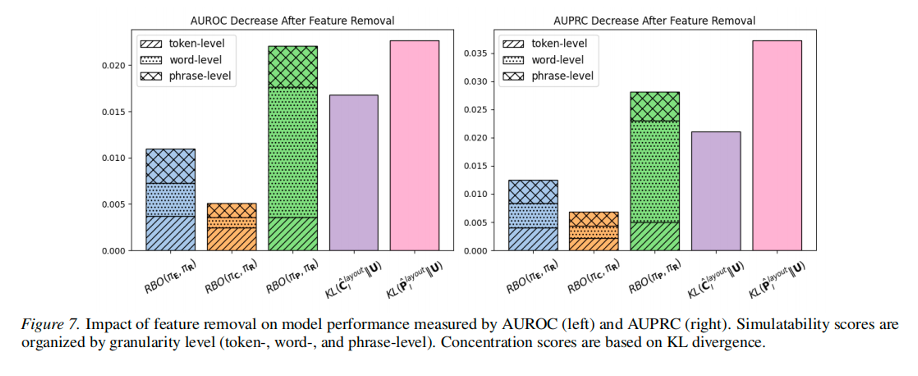 Figure 7: 基于 12 维信息流特征构建的校准器在多个模型与数据集上优于多种基线方法。
图 7 对工程读者尤其重要, 因为它回答了一个非常现实的问题: 这套东西到底能不能拿来用。答案是可以,而且效果不差。图里展示的不是一个抽象概念,而是一个真正跑出来、并且在多个模型和数据集上稳定优于基线的诊断器。这也是为什么这篇论文不只是“解释得好看”,而是已经开始具备实用价值。
结果相当强。
在多个模型、多个数据集上,这套方法的平均 AUROC 达到了 0.709,超过了对比方法的 0.676;分模型看,也在多数设置下取得了最优平均排名。
这件事为什么重要?
因为它意味着,未来我们也许不需要总是等到“答案错了”才知道模型不可靠。只要看一眼它内部的信息流形态,我们就能更早判断: 这次回答像不像是建立在真实证据上的。
从 RAG 和Agent 工程的角度,这个价值几乎是立刻可感的:
可以做更可靠的 hallucination 检测;
可以做回答前的动态降级与 fallback 触发;
可以做检索链路诊断,判断是“没检索到”,还是“检索到了但没用上”;
甚至可以用于训练过程中的内部监控,而不是只盯 loss 和 benchmark。
这就不是“论文里涨几个点”的问题了,而是把很多过去只能靠经验猜的工程问题, 第一次搬进了可量化、可排查、可追责的白盒分析框架里。
为什么这篇论文值得认真看
我觉得这篇论文真正值得反复咀嚼的,不只是它做出了一个新指标,而是它推动了一种视角变化。
过去我们太习惯从结果层理解大模型了。答对了, 就以为它真的会;答错了,就说它 hallucination;分数高了,就觉得模型更强。
但这篇论文提醒我们:“会答题”不等于“会推理”,“答对了”也不等于“用对了证据”。
如果以后我们真的开始系统性地分析模型内部的信息流,那很多问题都会变得更清楚:
一个 RAG 系统为什么检索质量不差却仍然经常失效?
一个 agent 为什么工具明明调用成功了,最终决策链还是歪掉了?
这些问题的答案,可能都不在输出层,而在模型内部那条看不见的信息传播路径里。
所以从更高一点的层面看,这篇论文推动的并不是一个小修小补式的 UQ 改进,而是一次很清晰的范式转向:
从“看它说了什么”,转向“看它是怎么想到这一步的”。
而一旦这种视角成立,未来的大模型评测、RAG 诊断、Agent 监控,甚至训练目标本身,都可能发生变化。我们不再只优化答案,也可能开始优化模型内部的证据利用方式、信息传播轨迹和推理健康度。
说到底,信任从来不是看表态,而是看过程。
放在大模型这里也是一样。真正值得信任的模型,不是那个总能把话说圆的模型,而是那个在内部真的沿着正确的证据链走到答案前面的模型。
作者团队
该论文由香港科技大学(广州)、吉林大学等机构合作完成。
第一作者:Rui Xu
合作作者:Yi Chen 、Jiujiu Chen
通讯作者: Sihong Xie
原文代码已开源: https://github.com/rxu0112/RAG-information-flow
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 扫码加好友,拉您进群
 全部版块
 我的主页


 收藏





